
大模型原理与训练 / 系统课时
按上下文窗口构造训练批次
按上下文窗口构造训练批次
训练时通常不会把整篇文本一次送入模型,而是从一维 Token ID 流中随机切出固定长度窗口。本节实现批次采样,并用输入与目标错位一位的方式,把每个位置组织成“根据已有上下文预测下一个 Token”的训练任务。
学习目标
- 理解
batch_size与block_size分别控制什么 - 从连续 Token ID 中随机采样固定长度训练窗口
- 验证输入
x与目标y的一位错位关系
为什么目标序列要向后错一位
若连续序列为 [10, 11, 12, 13, 14, 15],当 block_size=5 时,一个样本可以取 x=[10, 11, 12, 13, 14],对应 y=[11, 12, 13, 14, 15]。于是 x 的每个位置都有一个“下一个 Token”标签。
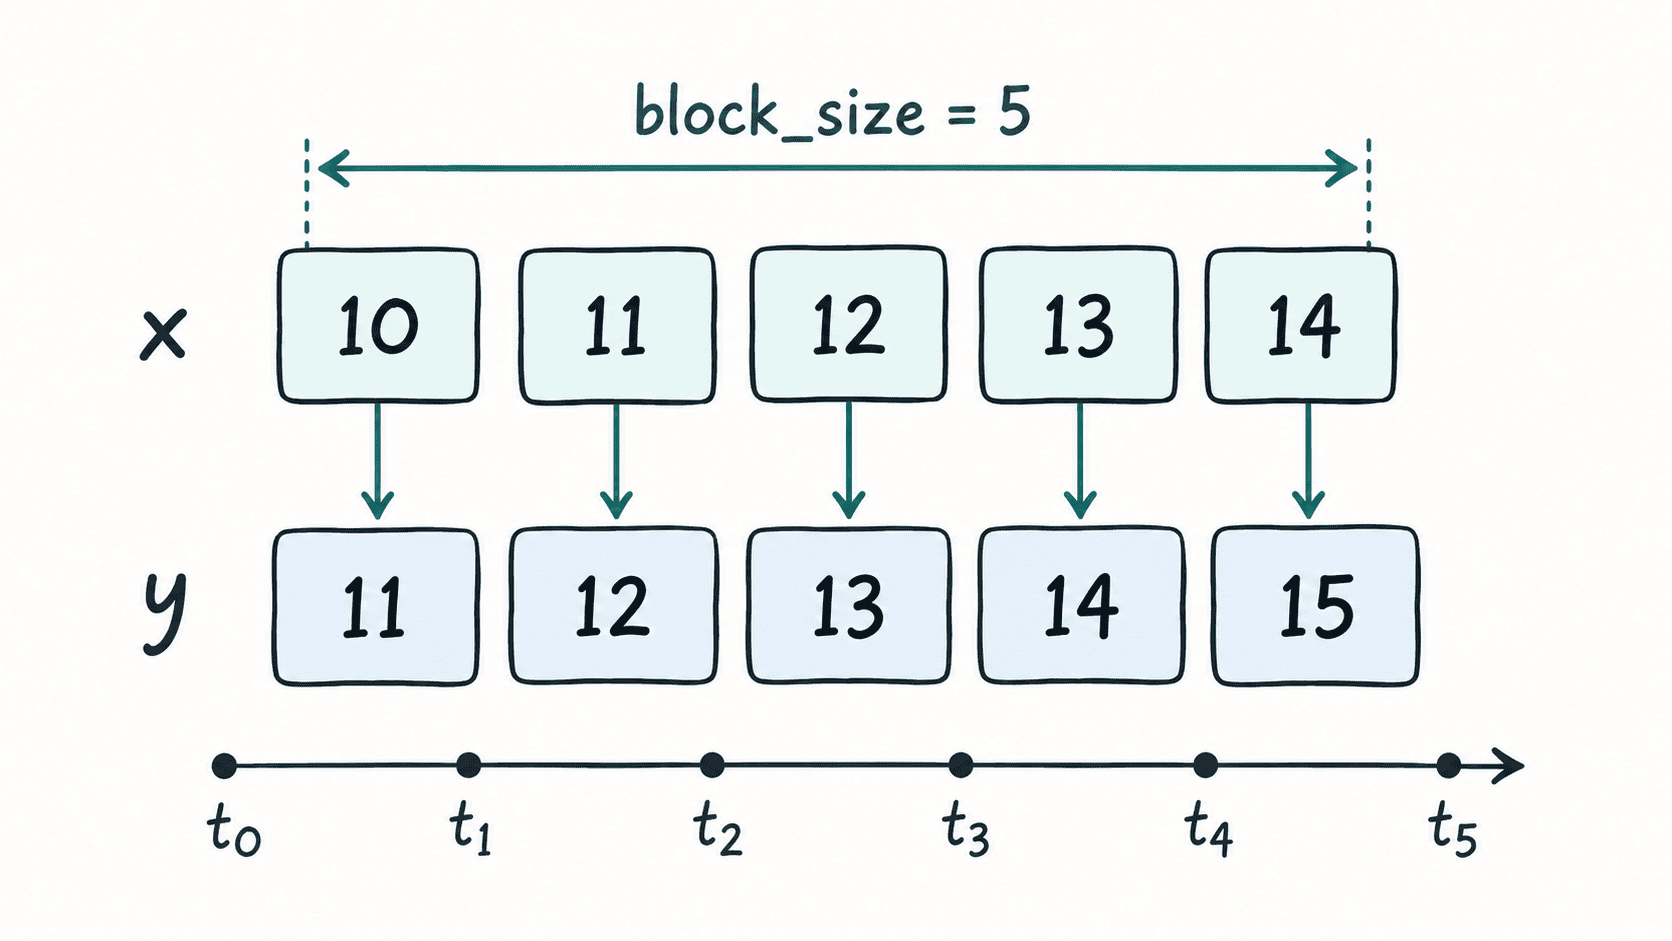
对 Transformer 来说,y 提供监督标签,而因果注意力掩码负责限制当前位置只能看到自己及之前的输入。错位标签负责定义预测目标,因果掩码负责防止偷看未来,两者作用不同。
实现随机批次采样
下面使用一段整数序列模拟已经编码好的语料。随机起点的上界必须保证 y 还能再向后取一个 Token,因此 torch.randint 的 high 参数使用 len(data) - block_size。
import torch

data = torch.arange(26, dtype=torch.long)
batch_size = 3
block_size = 5
generator = torch.Generator().manual_seed(7)

def get_batch(data: torch.Tensor) -> tuple[torch.Tensor, torch.Tensor]:
    # high 为开区间上界,确保目标窗口不会越过数据末尾。
    starts = torch.randint(
        0, len(data) - block_size, (batch_size,), generator=generator
    )
    x = torch.stack([data[i : i + block_size] for i in starts])
    y = torch.stack([data[i + 1 : i + block_size + 1] for i in starts])
    return x, y

x, y = get_batch(data)
print("x shape:", tuple(x.shape))
print("y shape:", tuple(y.shape))
print("shift aligned:", torch.equal(y[:, :-1], x[:, 1:]))
print("training pairs:", x.numel())
预期输出
x shape: (3, 5)
y shape: (3, 5)
shift aligned: True
training pairs: 15输出不依赖具体随机起点也能验证两个关键不变量:x 和 y 都是形状为 (batch_size, block_size) 的二维张量,而且 y 去掉最后一列后应与 x 去掉第一列后的内容完全一致。
两个尺寸参数分别控制什么
batch_size 表示一次并行抽取多少个独立窗口,主要影响单步处理的样本量和显存占用。block_size 表示每个窗口包含多少个 Token,也就是当前训练设置允许模型利用的最大上下文长度之一。
一个批次会产生 batch_size × block_size 个位置级预测目标。示例中是 个训练位置;增大 block_size 会让每个样本包含更长上下文,但注意力计算和显存成本也会随序列长度显著上升。
避免采样边界错误
最常见的错误是把随机起点上界写成 len(data) - block_size + 1。这样虽然 x 仍可能合法,但最后一个起点对应的 y 会尝试访问数据末尾之后的位置,最终得到长度不足的目标窗口并导致 torch.stack 失败。
另一个常见问题是让输入和目标使用不同起点。正确做法是先生成一组 starts,再从同一组起点分别切出 x 和向后偏移一位的 y。当形状检查和 shift aligned: True 同时成立,批次组织方式就满足自回归语言模型的基本训练要求。