
大模型原理与训练 / 系统课时
用梯度累积放大有效批次
用梯度累积放大有效批次
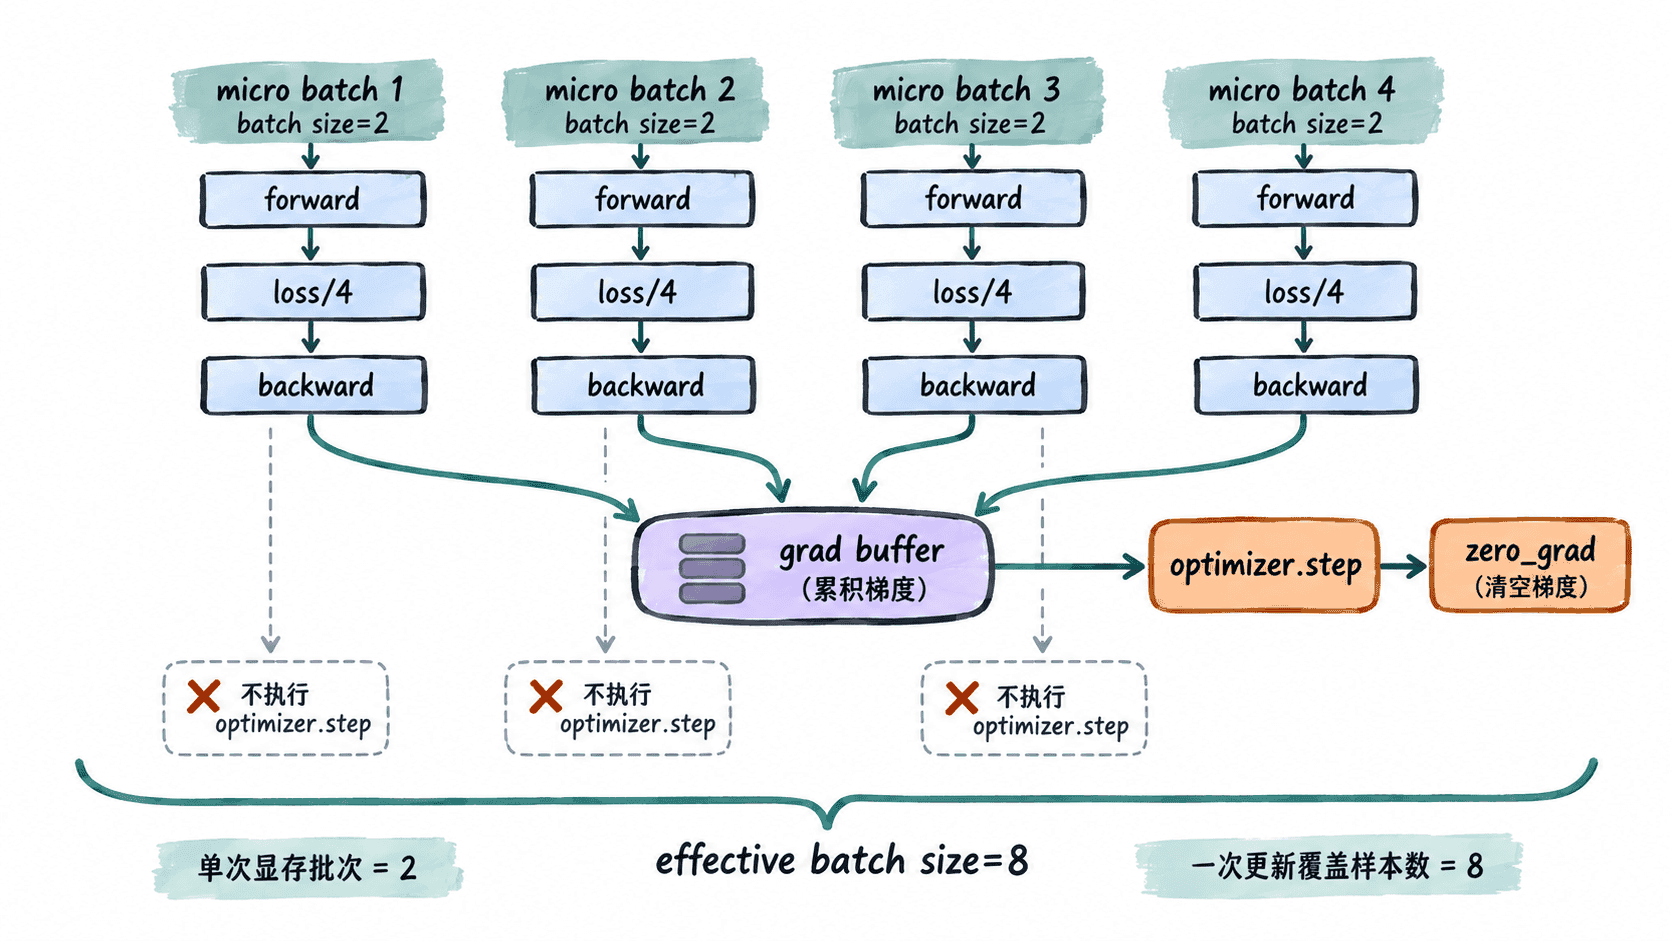
显存装不下更大的 batch 时,不必立刻减少有效训练批次。梯度累积把一个大批次拆成多个 micro batch,分别完成前向与反向传播,把梯度暂存在参数上,最后只执行一次参数更新。本节会用可运行实验验证正确的 loss 缩放,并明确显存批次与有效全局批次的区别。
学习目标
- 理解 micro batch、累积步数与有效全局批次之间的关系
- 正确缩放每个 micro batch 的 loss,并控制
zero_grad()与step()的调用时机 - 用实验验证梯度累积与一次处理等量大批次产生近似一致的参数更新
有效批次是怎样放大的
一次前向传播实际放入设备的样本数是 micro batch size,它直接决定激活值等中间结果占用多少显存。梯度累积不会让单次前向传播变大,而是让若干次反向传播生成的梯度继续累加在参数的 .grad 中。
单卡训练时,有效批次可以写成:
如果以后使用数据并行,且每张卡采用相同的 micro batch,则有效全局批次进一步变成:
例如每次只放 2 个样本,连续累积 4 次,单卡每次参数更新实际利用了 8 个样本,但峰值显存仍主要由一次 2 个样本的前向和反向过程决定。
loss 为什么要除以累积步数
PyTorch 默认会把新的反向梯度加到已有 .grad 上。如果连续执行 4 次 backward(),却直接对每个 micro batch 的平均 loss 求梯度,那么最终梯度相当于四个平均梯度的总和,数值约是目标大批次平均梯度的 4 倍。
因此在每个 micro batch 上执行反向传播前,应将 loss 除以累积步数。这样 4 次累加后的梯度等价于对完整有效批次取平均。optimizer.zero_grad() 只能在一个累积窗口开始前调用;如果每个 micro batch 都清零,前面累积的梯度会被直接丢弃。
验证累积更新与大批次更新
下面用两个初始参数完全相同的线性模型做对照。一边一次处理 8 个样本,另一边把相同数据拆成 4 个、每个 2 个样本的 micro batch。两边都只调用一次 optimizer.step()。
import copy
import torch


torch.manual_seed(7)

model_large = torch.nn.Linear(3, 1)
model_accum = copy.deepcopy(model_large)

optimizer_large = torch.optim.SGD(model_large.parameters(), lr=0.1)
optimizer_accum = torch.optim.SGD(model_accum.parameters(), lr=0.1)
criterion = torch.nn.MSELoss()

x = torch.randn(8, 3)
y = torch.randn(8, 1)

# 基准路径:8 个样本一次完成一次参数更新。
optimizer_large.zero_grad()
loss_large = criterion(model_large(x), y)
loss_large.backward()
optimizer_large.step()

micro_batch_size = 2
accumulation_steps = 4
optimizer_accum.zero_grad()

# 累积路径:每次只处理 2 个样本,第四次反向传播后才更新参数。
for start in range(0, 8, micro_batch_size):
    end = start + micro_batch_size
    loss = criterion(model_accum(x[start:end]), y[start:end])
    (loss / accumulation_steps).backward()

optimizer_accum.step()

same_update = all(
    torch.allclose(a, b, atol=1e-6, rtol=1e-6)
    for a, b in zip(model_large.parameters(), model_accum.parameters())
)

print(f"effective_batch_size={micro_batch_size * accumulation_steps}")
print(f"optimizer_steps=1")
print(f"same_update={same_update}")
预期输出:
effective_batch_size=8
optimizer_steps=1
same_update=True
这里比较的不是两个 loss 打印值,而是更新后的模型参数。浮点运算顺序略有差异,因此使用 torch.allclose() 判断近似一致,而不是要求逐位完全相同。
放进训练循环时控制更新边界
实际 nanoGPT 风格训练循环的关键顺序是:先清空上一轮梯度,再连续执行若干次前向和反向传播,最后统一更新参数。学习率调度、梯度裁剪以及训练 step 计数通常都应围绕真正的参数更新,而不是每个 micro batch 推进一次。
在多卡 DDP 中,若框架已经对各进程梯度执行平均,通常仍只按本地 accumulation_steps 缩放 loss,不再额外除以设备数量。真正需要记住的是两个独立旋钮:micro batch 控制单次显存压力,而 micro batch、累积步数和设备数共同决定一次参数更新看到的有效全局批次。