
大模型原理与训练 / 系统课时
用 DDP 扩到多张 GPU
用 DDP 扩到多张 GPU
这一节把单卡训练改成 PyTorch DistributedDataParallel:每张 GPU 对应一个训练进程,各进程读取不同数据分片,并在反向传播时同步梯度。完成后,你会得到一个可用 torchrun 启动的最小多卡训练程序,并能读懂 rank、local rank 与 world size。
学习目标
- 说明 DDP 为什么采用“一进程一卡”,以及
rank、local_rank、world_size分别表示什么。 - 用
torchrun启动两张 GPU 上的训练进程,并让数据按进程切分。 - 判断梯度同步发生在什么位置,以及梯度累积时如何避免多余同步。
DDP 真正负责什么
DDP 不会把一个 Python 进程里的 batch 自动切到多张卡。常见模式是每张 GPU 启动一个进程,每个进程持有完整模型副本,只处理属于自己的 micro batch。world_size 是总进程数,rank 是全局进程编号,local_rank 是当前节点内对应的 GPU 编号。
反向传播期间,DDP 会把各进程产生的梯度按 bucket 组织并执行 All-Reduce。同步完成后,每个模型副本看到的梯度一致,因此随后执行同样的 optimizer.step(),参数仍保持一致。
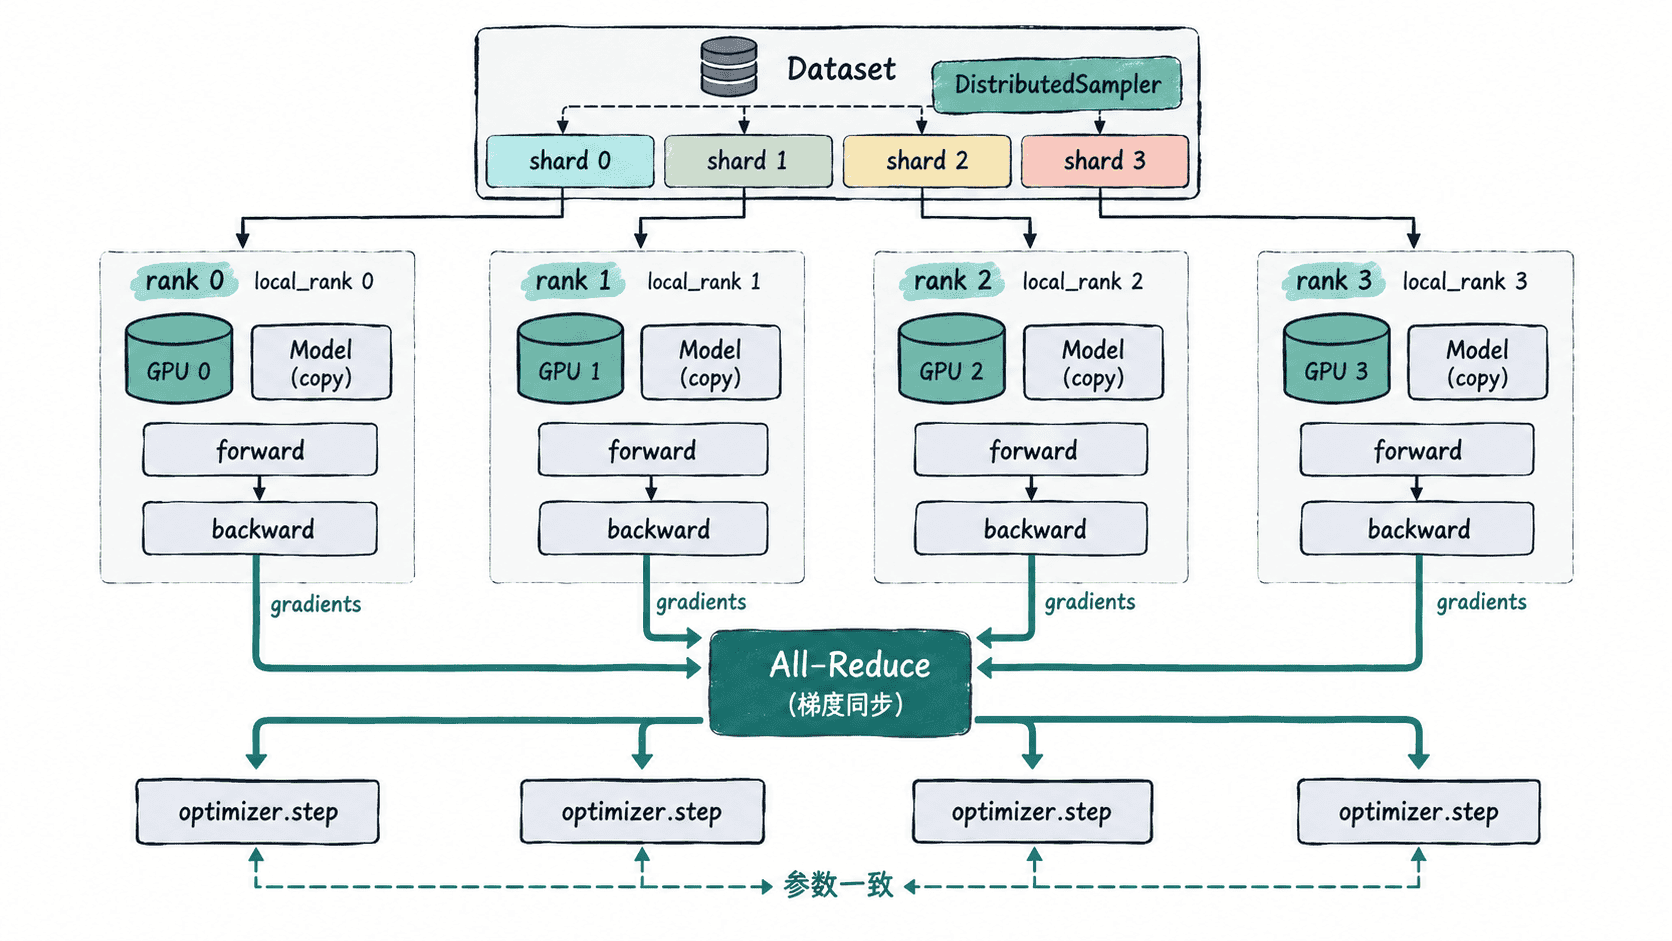
只有模型参数和梯度保持同步,并不代表每个进程必须读取完全相同的数据。训练数据应通过 DistributedSampler 或等价逻辑分片,否则多张 GPU 会重复计算同一批样本,吞吐提升了却没有扩大有效数据量。
跑通两张 GPU 的最小训练
下面的示例只做一次优化步骤,重点验证进程初始化、GPU 绑定、数据分片与梯度同步。将内容保存为 ddp_demo.py。
import os

import torch
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel as DDP
from torch.utils.data import DataLoader, DistributedSampler, TensorDataset


def main():
    dist.init_process_group(backend='nccl')

    rank = dist.get_rank()
    world_size = dist.get_world_size()
    local_rank = int(os.environ['LOCAL_RANK'])
    torch.cuda.set_device(local_rank)
    device = torch.device('cuda', local_rank)

    torch.manual_seed(0)
    dataset = TensorDataset(
        torch.randn(64, 4),
        torch.randn(64, 1),
    )
    sampler = DistributedSampler(
        dataset,
        num_replicas=world_size,
        rank=rank,
        shuffle=False,
    )
    loader = DataLoader(dataset, batch_size=8, sampler=sampler)

    model = torch.nn.Linear(4, 1).to(device)
    model = DDP(model, device_ids=[local_rank])
    optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

    x, y = next(iter(loader))
    x, y = x.to(device), y.to(device)

    optimizer.zero_grad(set_to_none=True)
    loss = torch.nn.functional.mse_loss(model(x), y)
    loss.backward()  # DDP 在 backward 期间同步各 rank 的梯度
    optimizer.step()

    for current_rank in range(world_size):
        if rank == current_rank:
            print(
                f'rank={rank} local_rank={local_rank} '
                f'world_size={world_size}',
                flush=True,
            )
        dist.barrier()

    if rank == 0:
        print('ddp step finished', flush=True)

    dist.destroy_process_group()


if __name__ == '__main__':
    main()
在至少有两张可用 CUDA GPU 的机器上执行:
torchrun --standalone --nproc_per_node=2 ddp_demo.py预期输出
rank=0 local_rank=0 world_size=2
rank=1 local_rank=1 world_size=2
ddp step finished
如果显卡编号、可见设备或进程启动方式不同,实际 local_rank 映射也可能不同;单机 torchrun 默认会为每个本地进程设置 LOCAL_RANK。
梯度累积时只同步最后一次 backward
如果一个参数更新要累积多个 micro batch,直接每次调用 loss.backward() 都会触发 DDP 梯度同步,通信量会被累积步数放大。更高效的做法是:前几个 micro step 使用 model.no_sync() 跳过 All-Reduce,只在最后一个 micro step 正常 backward,再执行一次参数更新。
这个优化不改变数学上的全局 batch,只减少中间同步。前提是每个 rank 使用相同的累积步数,并且所有进程按相同节奏进入最终同步,否则容易出现进程等待甚至死锁。
出错时先检查进程身份和数据分片
遇到卡住、只使用一张卡或结果异常时,先按固定顺序检查:torchrun 是否真的启动了预期数量的进程;每个进程的 LOCAL_RANK 是否绑定到不同 GPU;world_size 是否等于总进程数;数据加载器是否按 rank 分片。
当每个 rank 都能独立完成 forward/backward,且同步后执行同样的 optimizer step,DDP 才真正把单卡训练扩展成等价的多卡数据并行训练。