
大模型原理与训练 / 系统课时
在小数据集上继续训练模型
在小数据集上继续训练模型
继续训练不是把预训练阶段原样再跑一遍,而是从已有检查点出发,用更小的学习率和有限步数适配目标语料,同时监控原语料能力是否明显退化。本节用一个可运行的字符级 MiniGPT 演示检查点恢复、微调、验证和遗忘检测。
学习目标
- 从预训练检查点恢复模型,并用较小学习率继续训练
- 同时观察目标语料 Loss 与原语料 Loss,识别快速拟合和遗忘
- 根据验证 Loss 决定训练步数,而不是盲目增加 epoch
先明确继续训练的目标
小数据集微调最常见的目标是让模型快速吸收某一类表达或领域词汇。数据少意味着梯度会反复看到相同样本,训练 Loss 往往下降很快;如果学习率仍保持预训练阶段的量级,模型也更容易破坏原有参数。
因此至少同时保留两份评估数据:一份来自目标语料,用来判断是否学会新分布;另一份来自原有或通用语料,用来观察是否发生明显遗忘。只看训练 Loss,无法区分“真正适配”与“把小数据背下来”。
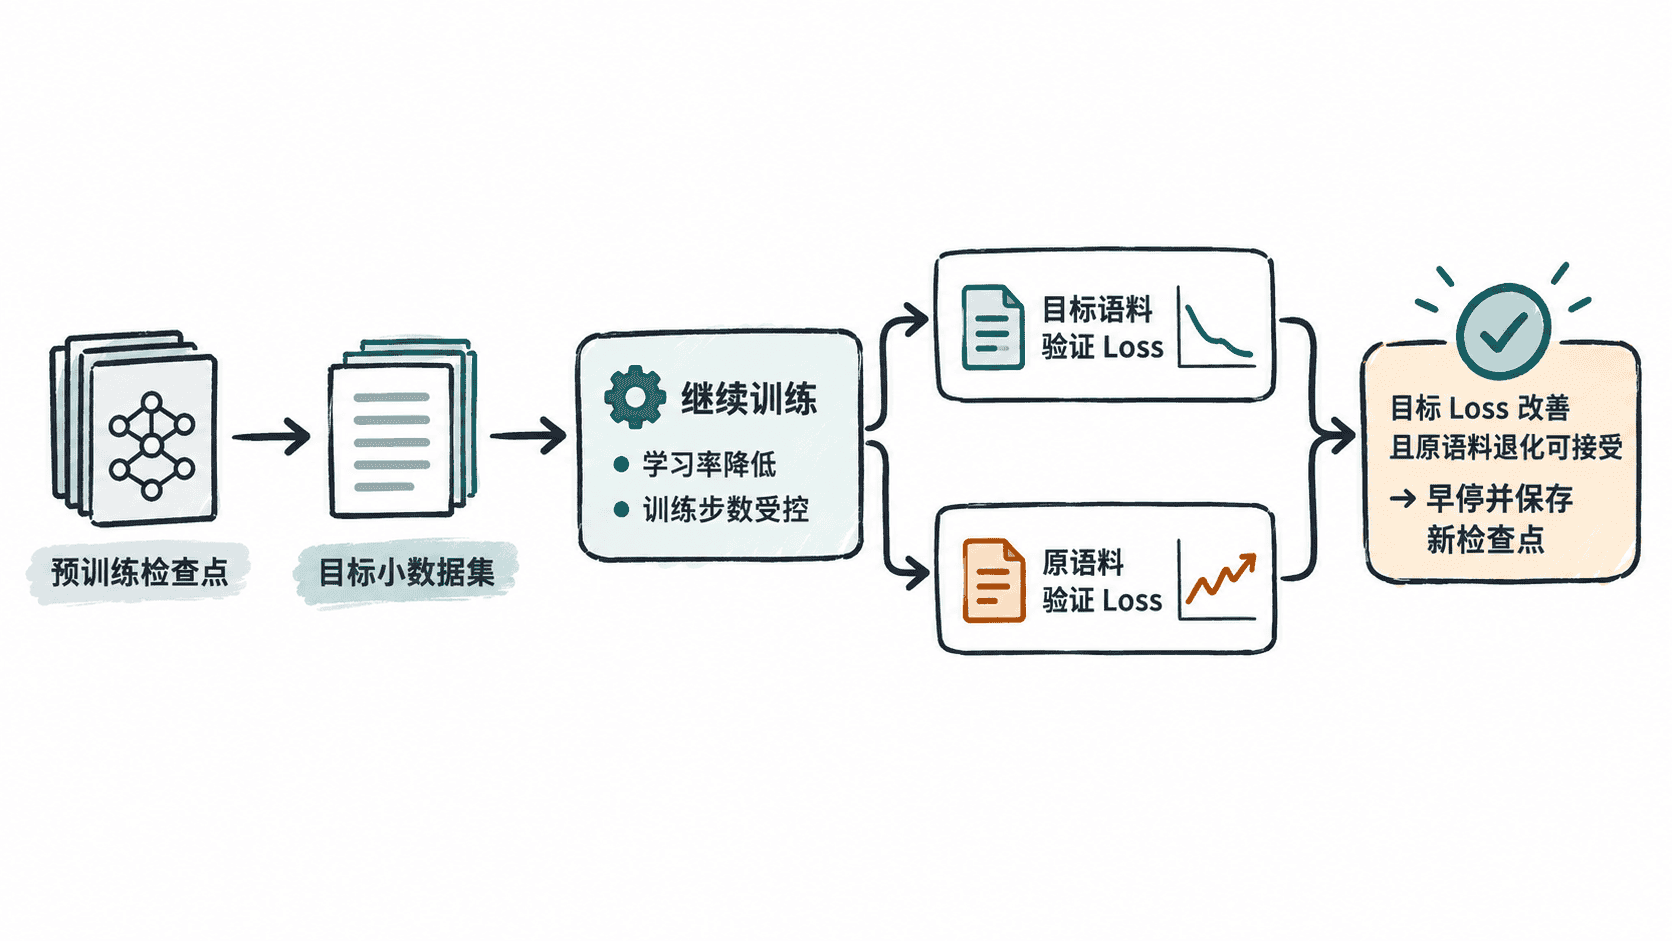
用较小学习率恢复检查点
在真实 nanoGPT 工程里,检查点通常保存模型权重、迭代步数和优化器状态。继续训练时可以恢复模型权重,再用较小学习率重新创建优化器;这样更容易控制目标语料对原参数的扰动。下面的独立脚本会在本地没有 base.pt 时先创建一个最小预训练检查点,再从它继续训练。
import os
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(7)
device = "cuda" if torch.cuda.is_available() else "cpu"
chars = "".join(chr(i) for i in range(32, 127)) + "\n"
stoi = {ch: i for i, ch in enumerate(chars)}
block_size = 48

def encode(text):
    return torch.tensor([stoi.get(ch, stoi["?"]) for ch in text], dtype=torch.long)

base_text = (
    "language models predict the next token from prior context. "
    "attention mixes information from earlier positions. "
) * 160
domain_text = (
    "sev1 ticket: database timeout. action: rollback and inspect latency. "
    "sev2 ticket: cache miss spike. action: warm the cache and monitor. "
) * 80

def get_batch(text, batch_size=16):
    data = encode(text)
    starts = torch.randint(0, len(data) - block_size - 1, (batch_size,))
    x = torch.stack([data[i:i + block_size] for i in starts]).to(device)
    y = torch.stack([data[i + 1:i + block_size + 1] for i in starts]).to(device)
    return x, y

class MiniGPT(nn.Module):
    def __init__(self, vocab_size, n_embd=64, n_head=4, n_layer=2):
        super().__init__()
        self.tok = nn.Embedding(vocab_size, n_embd)
        self.pos = nn.Embedding(block_size, n_embd)
        self.blocks = nn.ModuleList([
            nn.TransformerEncoderLayer(
                d_model=n_embd,
                nhead=n_head,
                dim_feedforward=256,
                dropout=0.0,
                batch_first=True,
                norm_first=True,
            )
            for _ in range(n_layer)
        ])
        self.norm = nn.LayerNorm(n_embd)
        self.head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx, targets=None):
        _, t = idx.shape
        pos = torch.arange(t, device=idx.device)
        h = self.tok(idx) + self.pos(pos)
        # 上三角 -inf 遮住未来位置,避免训练时偷看答案。
        mask = torch.full((t, t), float("-inf"), device=idx.device)
        mask = torch.triu(mask, diagonal=1)
        for block in self.blocks:
            h = block(h, src_mask=mask)
        logits = self.head(self.norm(h))
        loss = None if targets is None else F.cross_entropy(
            logits.reshape(-1, logits.size(-1)),
            targets.reshape(-1),
        )
        return logits, loss

@torch.no_grad()
def eval_loss(model, text, batches=10):
    model.eval()
    losses = []
    for _ in range(batches):
        x, y = get_batch(text)
        _, loss = model(x, y)
        losses.append(loss.item())
    return sum(losses) / len(losses)

def train(model, text, lr, steps, phase):
    model.train()
    optimizer = torch.optim.AdamW(model.parameters(), lr=lr)
    for step in range(steps + 1):
        x, y = get_batch(text)
        _, loss = model(x, y)
        optimizer.zero_grad(set_to_none=True)
        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        if step % 20 == 0:
            print(f"{phase} step={step} loss={loss.item():.4f}")

model = MiniGPT(len(chars)).to(device)
if os.path.exists("base.pt"):
    model.load_state_dict(torch.load("base.pt", map_location=device))
    print("base checkpoint: loaded")
else:
    train(model, base_text, lr=2e-3, steps=120, phase="base")
    torch.save(model.state_dict(), "base.pt")
    print("base checkpoint: created")

before_domain = eval_loss(model, domain_text)
before_base = eval_loss(model, base_text)
# 小数据继续训练把学习率降低一个数量级,减少对原参数的冲击。
train(model, domain_text, lr=2e-4, steps=80, phase="finetune")
after_domain = eval_loss(model, domain_text)
after_base = eval_loss(model, base_text)
torch.save(model.state_dict(), "finetuned.pt")

print(f"domain loss: {before_domain:.4f} -> {after_domain:.4f}")
print(f"base loss:   {before_base:.4f} -> {after_base:.4f}")
print("saved: finetuned.pt")
预期输出如下,Loss 数值会因设备、随机采样和 PyTorch 版本不同而变化;重点是目标语料 Loss 明显下降,并把原语料 Loss 的变化作为遗忘信号。
base step=0 loss=<LOSS>
...
base checkpoint: created
finetune step=0 loss=<LOSS>
...
domain loss: <LOSS> -> <LOWER_LOSS>
base loss:   <LOSS> -> <LOSS>
saved: finetuned.pt
如果目录里已经存在本例生成的 base.pt,程序会直接打印 base checkpoint: loaded 并进入微调。真实项目也应把恢复的检查点、是否恢复优化器、微调学习率和最佳验证步数写进实验记录,否则很难复现结果。
观察快速拟合与遗忘
小数据微调最值得看的不是单个 Loss,而是两条评估曲线的相对变化。目标语料训练 Loss 快速下降是正常现象;如果目标验证 Loss 先下降后回升,说明已经开始记忆训练样本。若原语料验证 Loss 同时持续恶化,则说明模型正在遗忘预训练分布。
降低学习率、减少训练步数、增加权重衰减或混入少量通用语料,都能减轻遗忘。最先尝试的通常是降低学习率和提前停止,因为这两项最容易验证,也不会改变目标数据本身。
如何决定何时停止
每隔固定步数同时记录目标验证 Loss 和原语料验证 Loss。目标验证 Loss 仍在下降且原语料退化很小,可以继续;目标验证 Loss 连续多次没有改善,应停止并回滚到最佳检查点;原语料 Loss 突然显著变差,则应优先降低学习率或缩短训练。
对小数据集而言,几十到几百个更新步就可能足够。真正要保存的不是“最后一次训练结果”,而是验证指标最合适的那个检查点。这样才能把继续训练变成可控的分布适配,而不是一次不可逆的参数覆盖。