
大模型原理与训练 / 系统课时
用配置驱动不同规模实验
用配置驱动不同规模实验
本节把模型规模、数据路径和训练超参数从源码中抽离出来,建立“基础配置 + 实验配置 + 命令行覆盖 + 有效配置快照”的最小机制。这样切换 tiny、small 等实验时无需改训练代码,也能准确追溯一次运行到底用了什么参数。
学习目标
- 能把模型、数据和训练参数放入独立配置文件
- 能通过命令行覆盖少量参数,同时阻止未知字段静默生效
- 能在每次运行时保存最终有效配置,保证实验可追踪
配置的核心是把变化从代码中拿出去
直接在 train.py 里修改 n_layer、batch_size 或 learning_rate,短期看很快,但几次实验后就很难回答“这个结果对应哪组参数”。配置驱动的目标不是增加一层抽象,而是让训练代码保持稳定,让实验差异以数据形式被记录。
最小可用方案可以分成四层:训练代码提供默认值;实验文件描述一组可复用参数;命令行只覆盖本次临时变化;程序启动后把合并得到的最终配置写入输出目录。真正用于追踪实验的是最后这份“有效配置”,而不是某个单独配置文件。
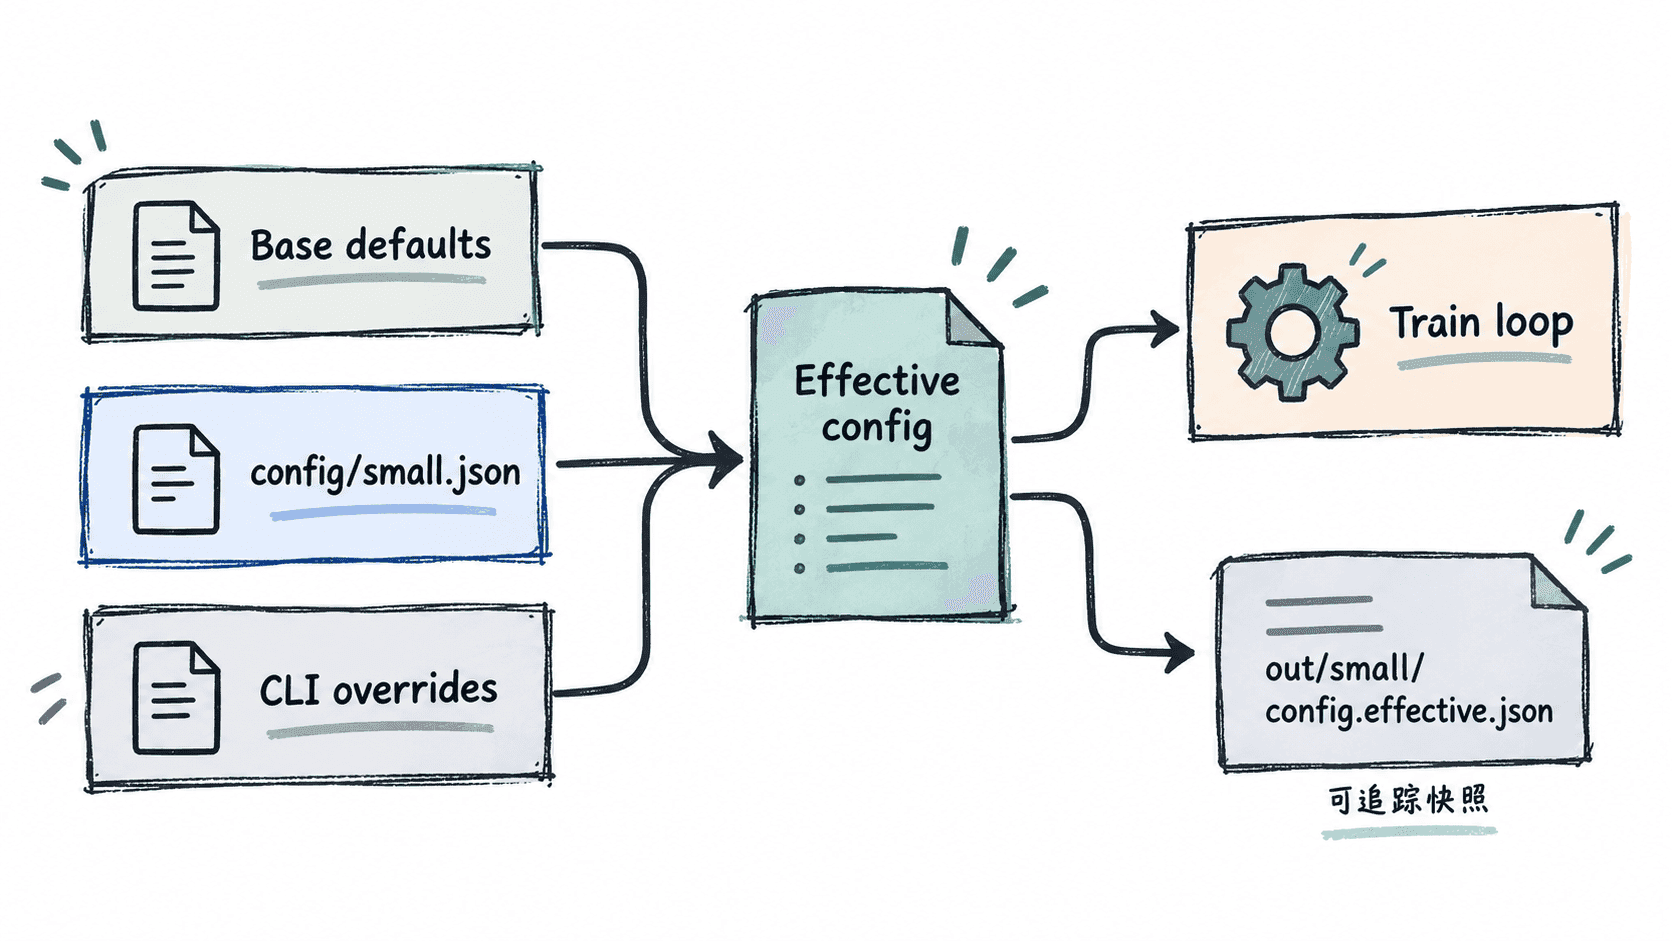
建立一份可复用实验配置
下面用 JSON 保存一个 small 规模实验。字段只描述会变化的实验参数,不把训练流程本身塞进配置。
{
  "experiment_name": "small",
  "dataset": "data/openwebtext",
  "n_layer": 6,
  "n_head": 6,
  "n_embd": 384,
  "batch_size": 32,
  "block_size": 256,
  "learning_rate": 0.0006,
  "max_iters": 20000
}
这份文件建议保存为 config/small.json。模型规模相关字段决定网络形状,数据与训练字段控制一次实验的输入和优化过程。后续新增 tiny 或 medium 规模时,新增配置文件即可,不需要复制一份新的训练脚本。
在启动时合并并校验配置
下面的完整程序读取实验配置,允许使用 --set key=value 做少量覆盖,并拒绝未知键。它还会把最终有效配置写到独立输出目录,避免“命令行改过但没有记录”的情况。
import argparse
import json
from pathlib import Path

# 训练代码提供稳定默认值,实验文件只覆盖差异。
DEFAULTS = {
    "experiment_name": "base",
    "dataset": "data/openwebtext",
    "n_layer": 4,
    "n_head": 4,
    "n_embd": 256,
    "batch_size": 16,
    "block_size": 256,
    "learning_rate": 3e-4,
    "max_iters": 10000,
}

def parse_scalar(raw: str):
    for caster in (int, float):
        try:
            return caster(raw)
        except ValueError:
            pass
    lowered = raw.lower()
    if lowered in {"true", "false"}:
        return lowered == "true"
    return raw

def load_effective_config(config_path: Path, overrides: list[str]) -> dict:
    config = DEFAULTS.copy()
    file_config = json.loads(config_path.read_text(encoding="utf-8"))

    # 拒绝未知字段,避免拼写错误被静默忽略。
    unknown = set(file_config) - set(DEFAULTS)
    if unknown:
        raise KeyError(f"unknown config keys: {sorted(unknown)}")
    config.update(file_config)

    # 命令行覆盖只作用于已声明字段。
    for item in overrides:
        key, value = item.split("=", 1)
        if key not in DEFAULTS:
            raise KeyError(f"unknown override key: {key}")
        config[key] = parse_scalar(value)

    return config

parser = argparse.ArgumentParser()
parser.add_argument("--config", type=Path, default=Path("config/small.json"))
parser.add_argument("--set", action="append", default=[])
args = parser.parse_args()

config = load_effective_config(args.config, args.set)
out_dir = Path("out") / str(config["experiment_name"])
out_dir.mkdir(parents=True, exist_ok=True)

# 将最终有效配置与训练产物放在同一实验目录。
snapshot = out_dir / "config.effective.json"
snapshot.write_text(
    json.dumps(config, indent=2, ensure_ascii=False) + "\n",
    encoding="utf-8",
)

print(f"experiment={config['experiment_name']}")
print(f"n_layer={config['n_layer']}, n_embd={config['n_embd']}")
print(f"batch_size={config['batch_size']}")
print(f"snapshot={snapshot}")
预期输出
experiment=small
n_layer=6, n_embd=384
batch_size=32
snapshot=out/small/config.effective.json
运行时可以只覆盖本次想试验的字段,而不修改 config/small.json:
python train_config.py --config config/small.json --set batch_size=24预期输出
experiment=small
n_layer=6, n_embd=384
batch_size=24
snapshot=out/small/config.effective.json
out/small/config.effective.json 中会记录合并后的 batch_size 为 24。如果把 --set bacth_size=24 这样的拼写错误传进去,程序会直接报未知字段,而不是静默创建一个训练代码根本不会读取的新键。
不同规模实验应改哪些参数
模型规模通常由 n_layer、n_head、n_embd 和 block_size 决定;训练吞吐与显存压力更多受 batch_size、梯度累积和序列长度影响。扩大模型时不要只把所有数字按比例放大,因为显存、每步计算量和稳定学习率不会线性变化。
为了保持实验可比较,建议每次只改变一组有明确目的的参数。例如比较模型规模时,固定数据集和评估方式;比较吞吐时,固定模型结构,只调整 batch 和累积步数。配置文件负责“声明差异”,实验命名负责让输出目录和日志能对应到这份差异。
让配置成为实验事实来源
运行开始后,应把最终有效配置与检查点、日志和评估结果放在同一个实验目录。这样即使原始配置文件后来被修改,也能从 config.effective.json 还原当次训练使用的参数。
如果项目继续扩大,可以再加入配置继承、类型校验或专门的配置库;但无论工具多复杂,都要守住同一个原则:源码描述训练机制,配置描述实验差异,输出目录保存当次真正生效的配置。做到这一点,批量切换模型规模才不会牺牲可追踪性。