
大模型原理与训练 / 系统课时
用 Embedding 表示 Token 与位置
用 Embedding 表示 Token 与位置
这一课把离散的 Token ID 变成 Transformer 能处理的连续向量,并同时注入顺序信息。你会实现 Token Embedding 与 Position Embedding,观察两者的张量形状,并理解为什么相同 Token 出现在不同位置时最终表示仍然不同。
学习目标
- 用
nn.Embedding把 Token ID 映射到可学习的连续向量。 - 为序列位置建立独立的可学习位置向量。
- 正确相加 Token 与位置表示,并检查输入长度边界。
两类 Embedding 各自负责什么
Token ID 只是整数标签,本身没有“距离”或“语义大小”的含义。nn.Embedding(vocab_size, n_embd) 相当于一张 V × C 的可学习查找表:输入某个 Token ID,就取出对应的一行 C 维向量。训练开始时这些向量通常是随机的,语义关系是在优化过程中逐渐形成的。
仅有 Token Embedding 还不够。Transformer 的矩阵运算不会自动知道第 0 个 Token 和第 3 个 Token 谁先谁后,所以需要额外提供位置信息。最小 nanoGPT 风格实现通常再建一张 block_size × n_embd 的 Position Embedding 表,用位置编号 0...T-1 查出位置向量。
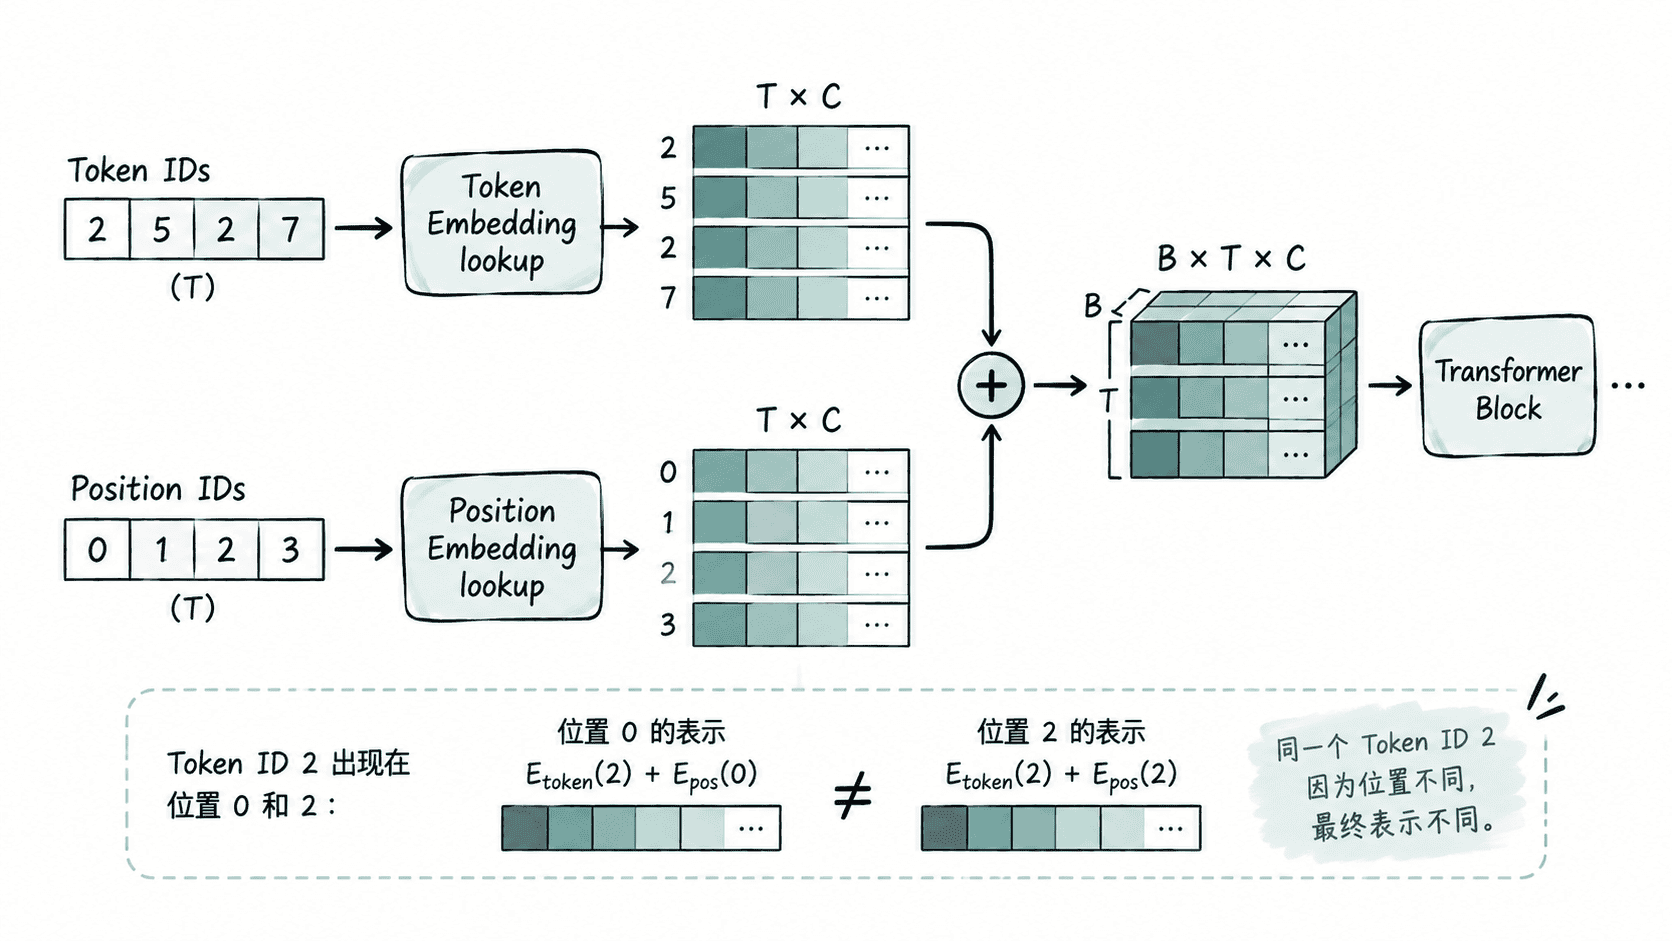
最终送入后续 Transformer Block 的表示,是两张表查到的向量逐位置相加:Token Embedding 表示“是什么”,Position Embedding 表示“在哪里”。
实现输入嵌入层
下面的完整示例封装了两种 Embedding,并显式检查序列长度是否超过 block_size。位置编号通过 torch.arange(T) 生成,同一个批次中的所有样本共享位置表,因此不需要为每个 batch 重复创建位置 ID。
import torch
import torch.nn as nn

torch.manual_seed(42)

class InputEmbedding(nn.Module):
    def __init__(self, vocab_size, n_embd, block_size):
        super().__init__()
        self.block_size = block_size
        self.token_embedding = nn.Embedding(vocab_size, n_embd)
        self.position_embedding = nn.Embedding(block_size, n_embd)

    def forward(self, idx):
        batch, time = idx.shape
        if time > self.block_size:
            raise ValueError(
                f'sequence length {time} exceeds block_size {self.block_size}'
            )

        # Token 向量按 Token ID 查表;位置向量按 0..T-1 查表。
        token_emb = self.token_embedding(idx)
        position_ids = torch.arange(time, device=idx.device)
        position_emb = self.position_embedding(position_ids)

        # position_emb 的 T×C 会沿 batch 维自动广播。
        return token_emb + position_emb

layer = InputEmbedding(vocab_size=10, n_embd=6, block_size=8)
idx = torch.tensor([
    [2, 5, 2, 7],
    [1, 1, 3, 4],
])

x = layer(idx)

print('input shape:', tuple(idx.shape))
print('token embedding reused:', torch.equal(
    layer.token_embedding(idx[0, 0]),
    layer.token_embedding(idx[0, 2]),
))
print('position ids:', torch.arange(idx.size(1)).tolist())
print('embedding shape:', tuple(x.shape))
预期输出
input shape: (2, 4)
token embedding reused: True
position ids: [0, 1, 2, 3]
embedding shape: (2, 4, 6)
idx 的形状是 B × T = 2 × 4,查表后多出嵌入维度 C = 6,因此结果是 2 × 4 × 6。同一个 Token ID 2 在位置 0 和位置 2 查到的 Token Embedding 完全相同,但它们随后会叠加不同的位置向量,所以最终输入表示不同。
广播为什么成立
token_emb 的形状是 B × T × C,而 position_emb 是 T × C。PyTorch 从末尾维度开始对齐:T 对齐 T,C 对齐 C,缺失的 batch 维被视为 1,因此位置矩阵会自动广播到每个样本。
这种写法比手工构造 B × T 的位置 ID 更简洁,也准确表达了语义:同一批次中,第 0 个位置使用同一条位置向量,第 1 个位置也一样。只有 Token 内容随样本变化。
什么时候这两张表还不够
Token 与位置相加只完成了“把离散序列变成带位置信息的连续表示”,还没有让不同位置互相交换信息。此时每个位置仍然只是“当前 Token 向量 + 当前位置向量”,看不到前文内容。
下一步真正改变表示的是因果自注意力:它会基于这些输入向量计算 Query、Key、Value,并让当前位置在遮罩约束下聚合此前位置的信息。也就是说,Embedding 负责准备坐标,自注意力才负责建立 Token 之间的上下文关系。