
大模型原理与训练 / 系统课时
堆叠 Transformer Block
堆叠 Transformer Block
单个 Transformer Block 只能完成一次“注意力混合 + 前馈变换”。完整 GPT 需要把多个结构相同但参数独立的 Block 串联起来,使每一层都在上一层表示上继续提炼信息。本节将用统一配置对象约束层数、隐藏维度和注意力头数,并验证堆叠后张量形状保持不变。
学习目标
- 使用
nn.ModuleList按n_layer创建多个参数独立的 Transformer Block - 理解
n_embd、n_head与单头维度之间的约束关系 - 验证深层堆叠前后序列长度和隐藏维度保持一致
结构参数必须先满足约束
GPT 的每个 Block 输入和输出都保持形状 (B, T, C),其中 C = n_embd。多头注意力会把隐藏维度切成 n_head 份,因此单头维度为:
所以必须满足 n_embd % n_head == 0。n_layer 决定网络深度,但不会改变张量最后一维;否则不同 Block 之间无法直接串联。
例如 n_embd=64、n_head=4 时,每个头处理 16 维;若改成 n_head=6,64 无法整除 6,应在模型构造阶段直接拒绝。
用 ModuleList 堆叠 Block
下面的最小实现使用 PyTorch 自带的 nn.MultiheadAttention 作为注意力核心,重点展示如何统一配置并逐层执行。每个 Block 都由独立对象创建,因此不会意外共享参数。
from dataclasses import dataclass

import torch
import torch.nn as nn


@dataclass
class GPTConfig:
    n_layer: int = 4
    n_embd: int = 64
    n_head: int = 4
    dropout: float = 0.1


class Block(nn.Module):
    def __init__(self, cfg: GPTConfig):
        super().__init__()
        assert cfg.n_embd % cfg.n_head == 0, "n_embd must be divisible by n_head"

        self.ln_1 = nn.LayerNorm(cfg.n_embd)
        self.attn = nn.MultiheadAttention(
            embed_dim=cfg.n_embd,
            num_heads=cfg.n_head,
            dropout=cfg.dropout,
            batch_first=True,
        )
        self.ln_2 = nn.LayerNorm(cfg.n_embd)
        self.mlp = nn.Sequential(
            nn.Linear(cfg.n_embd, 4 * cfg.n_embd),
            nn.GELU(),
            nn.Linear(4 * cfg.n_embd, cfg.n_embd),
            nn.Dropout(cfg.dropout),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        t = x.size(1)
        # True 表示该位置不可见,构造上三角因果遮罩。
        causal_mask = torch.triu(
            torch.ones(t, t, dtype=torch.bool, device=x.device),
            diagonal=1,
        )

        norm_x = self.ln_1(x)
        attn_out, _ = self.attn(
            norm_x,
            norm_x,
            norm_x,
            attn_mask=causal_mask,
            need_weights=False,
        )
        x = x + attn_out
        x = x + self.mlp(self.ln_2(x))
        return x


class GPTBackbone(nn.Module):
    def __init__(self, cfg: GPTConfig):
        super().__init__()
        self.blocks = nn.ModuleList(
            [Block(cfg) for _ in range(cfg.n_layer)]
        )
        self.ln_f = nn.LayerNorm(cfg.n_embd)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        for block in self.blocks:
            x = block(x)
        return self.ln_f(x)


cfg = GPTConfig()
model = GPTBackbone(cfg)

x = torch.randn(2, 16, cfg.n_embd)
y = model(x)

print(y.shape)
print(len(model.blocks))
print(cfg.n_embd // cfg.n_head)
预期输出
torch.Size([2, 16, 64])
4
16
第一行证明 4 个 Block 堆叠后仍保持 (B, T, C) 形状,第二行验证实际层数,第三行给出单头维度。
深度网络的数据流
每层都会读取上一层的完整表示,再通过残差连接把更新结果写回同一维度。层与层之间参数互不共享,因此“堆叠 6 层”不是把同一个 Block 调用 6 次,而是创建 6 组独立参数。
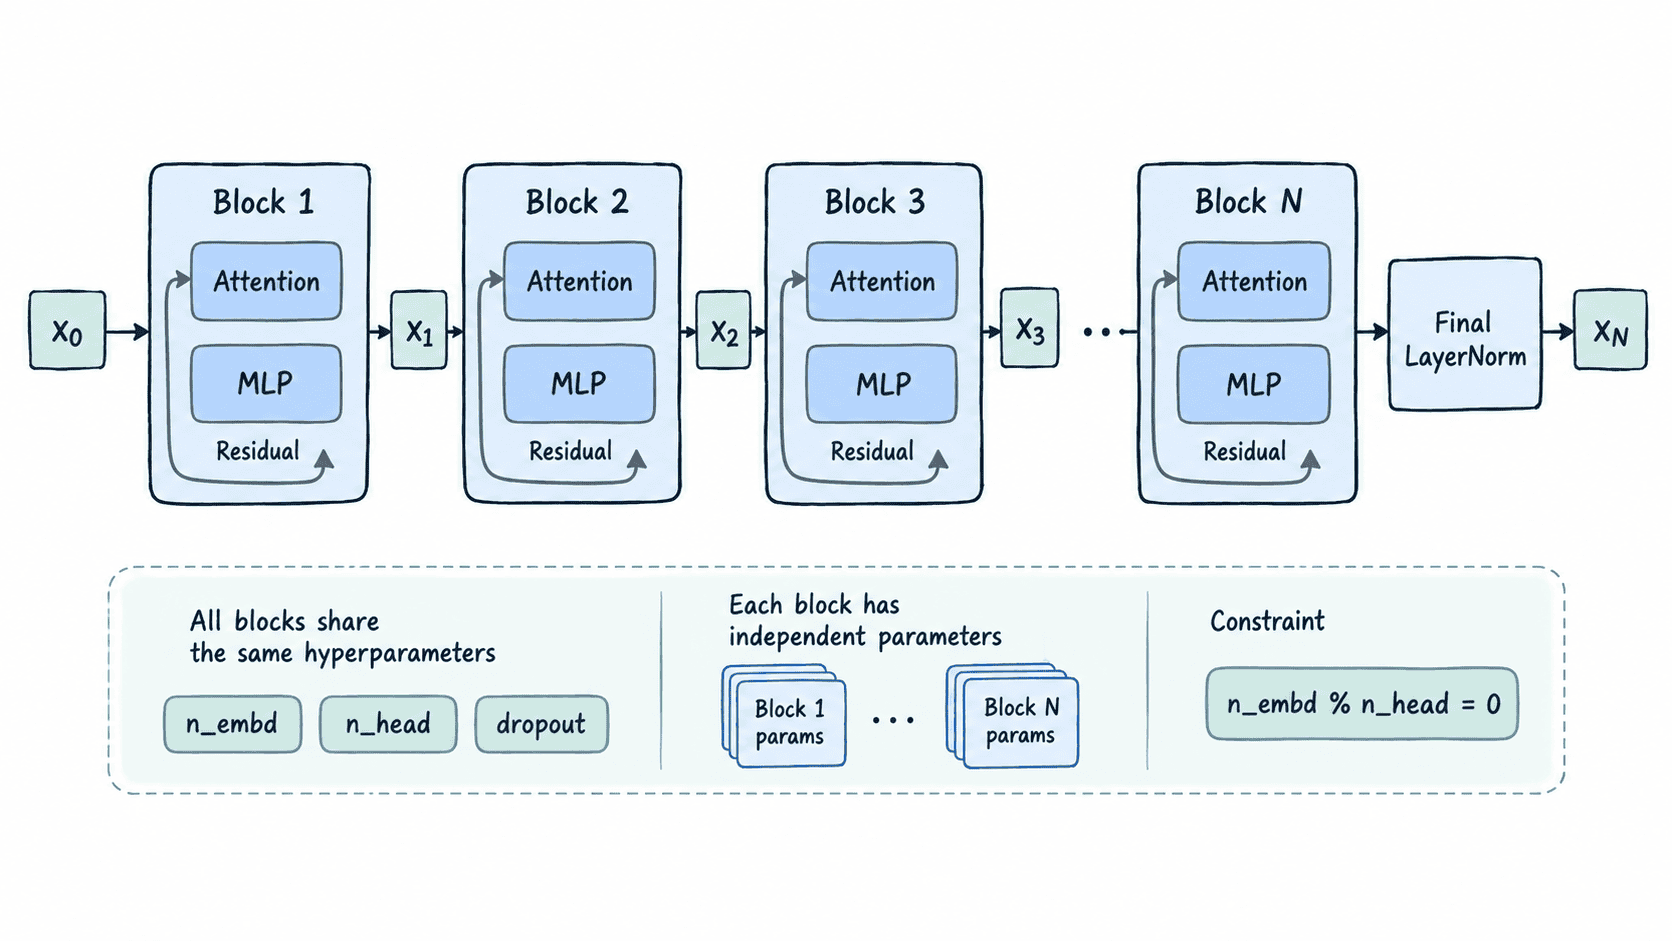
nn.ModuleList 会把内部 Block 正确注册为子模块,使优化器、state_dict()、设备迁移和 train() / eval() 都能递归处理这些层。如果把 Block 放进普通 Python 列表,参数不会被 PyTorch 模块系统完整追踪,这是实现深层网络时常见的隐蔽错误。
调整超参数时看约束链
n_layer 增大主要增加网络深度和计算量;n_embd 增大不仅扩大残差流,还会同步放大注意力投影和 MLP;n_head 决定把隐藏维度分成多少个子空间,但必须整除 n_embd。
当输入输出维度统一、头数约束在构造期检查、所有 Block 都通过 ModuleList 注册后,网络深度就能安全扩展;后续无论接词嵌入、最终 LayerNorm 还是语言模型头,都可以继续沿用同一个隐藏维度。