
大模型原理与训练 / 系统课时
读懂参数量与训练成本
读懂参数量与训练成本
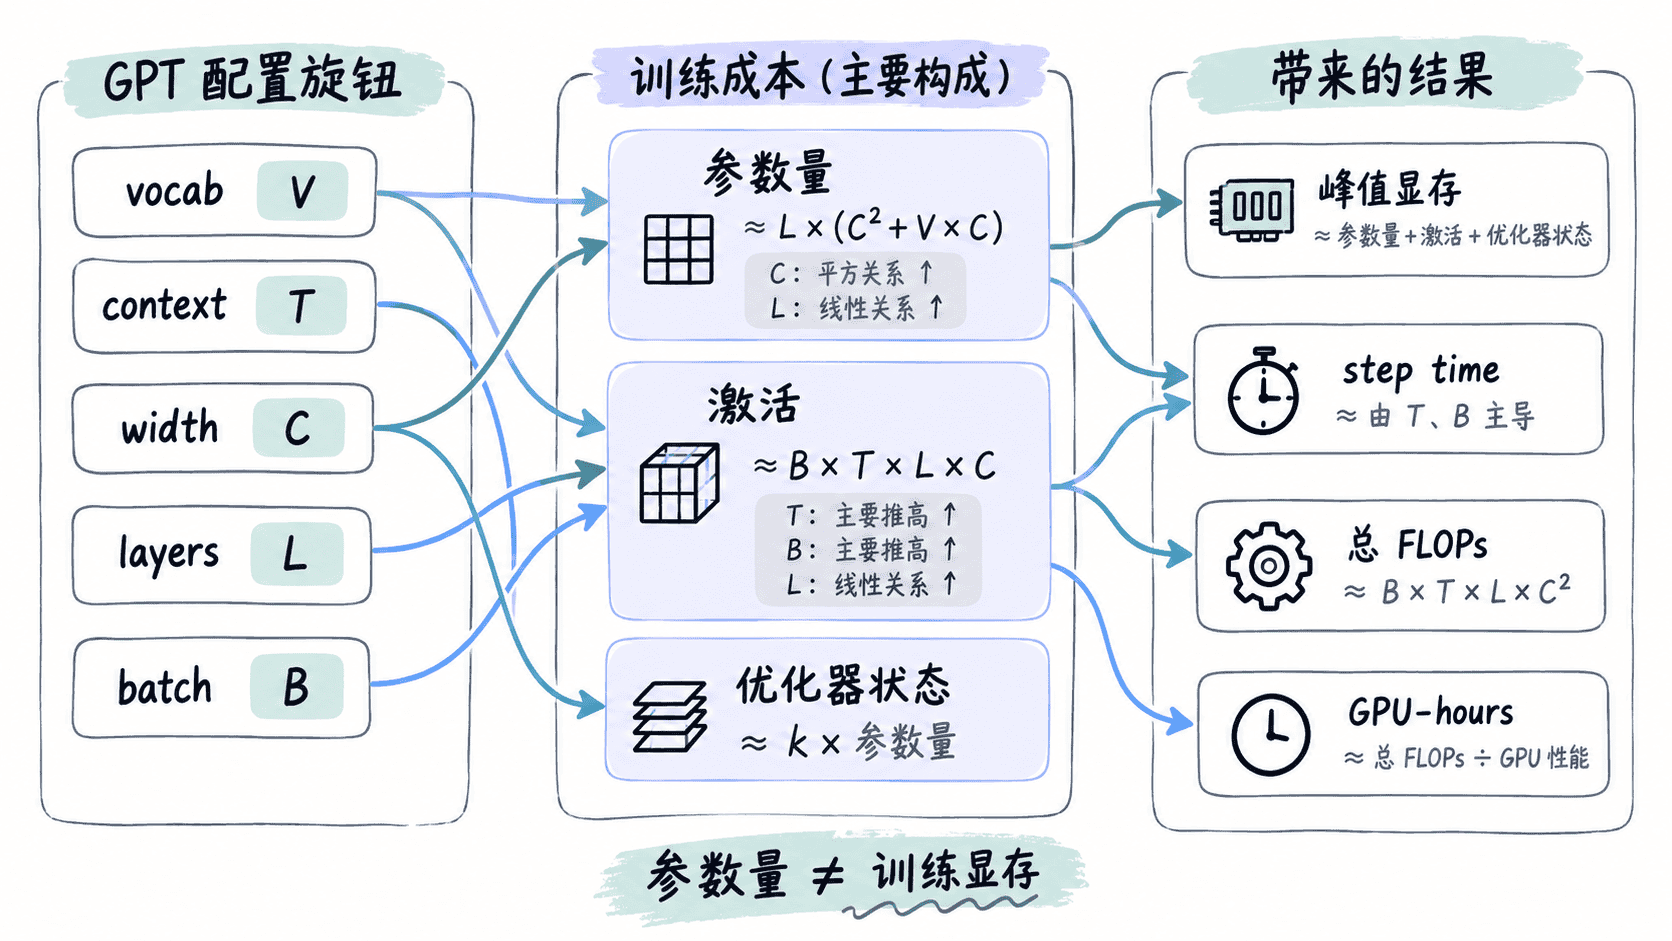
参数量不是一个孤立的模型指标:它同时影响权重显存、梯度与优化器状态,还会和层数、宽度、序列长度一起决定每步计算量。本节用一个 GPT 配置把这些成本拆开,并给出可复用的估算方法。
学习目标
- 能从词表、模型宽度、层数和上下文长度估算 GPT 参数量。
- 能把权重、梯度、AdamW 状态与激活显存分开核算。
- 能用训练 token 数与有效吞吐估算总计算量和 GPU-hours。
先把参数量拆成可解释的部分
设词表大小为 、上下文长度为 、隐藏维度为 、Transformer 层数为 。对采用 GPT-2 式注意力、MLP 扩展倍数为 4,并且输入词嵌入与输出头共享权重的模型,主导项可近似写成 。
其中每层注意力的 Q、K、V 和输出投影约占 ,两层 MLP 约占 。LayerNorm 和 bias 只贡献较小的一阶项,所以做容量规划时通常先忽略。这个近似式最重要的结论是:层数对参数量近似线性增长,而宽度对每层参数量近似平方增长。
用配置快速估算
下面的脚本按主导项估算一个接近 GPT-2 small 尺度的配置,同时把常见训练静态显存和训练 FLOPs 换算成容易比较的单位。
from dataclasses import dataclass

@dataclass(frozen=True)
class GPTConfig:
    vocab_size: int = 50304
    block_size: int = 1024
    n_layer: int = 12
    n_embd: int = 768

def estimate_cost(cfg: GPTConfig, train_tokens: int) -> None:
    embedding = cfg.vocab_size * cfg.n_embd
    position = cfg.block_size * cfg.n_embd
    blocks = cfg.n_layer * 12 * cfg.n_embd**2
    params = embedding + position + blocks

    # 2 B/param 只表示低精度权重本身;训练时还要另算梯度与优化器状态。
    low_precision_weight_gib = params * 2 / 1024**3
    fp32_adam_train_gib = params * 16 / 1024**3
    train_flops = 6 * params * train_tokens

    print(f"parameters≈{params:,} ({params / 1e6:.2f}M)")
    print(f"BF16/FP16 weight-only≈{low_precision_weight_gib:.3f} GiB")
    print(f"FP32 params+grads+Adam≈{fp32_adam_train_gib:.3f} GiB")
    print(f"1B tokens training≈{train_flops / 1e15:.1f} PFLOP")

estimate_cost(GPTConfig(), train_tokens=1_000_000_000)
预期输出
parameters≈124,354,560 (124.35M)
BF16/FP16 weight-only≈0.232 GiB
FP32 params+grads+Adam≈1.853 GiB
1B tokens training≈746.1 PFLOP
这里的 16 B/param 按常见 FP32 参数、FP32 梯度以及 AdamW 的两个 FP32 一阶/二阶矩状态估算,不包含激活、CUDA 临时缓冲区、通信缓冲区和框架开销。实际 nanoGPT 模型还会有 LayerNorm、bias 等小项,因此精确统计应以 sum(p.numel() for p in model.parameters()) 为准。
训练 FLOPs 使用的是稠密 Decoder-only Transformer 常见的粗略规则 ,其中 是训练 token 数。它适合做数量级预算,而不是替代 profiler;长上下文下注意力计算、稀疏结构或特殊算子都会让实际值偏离这个近似。
宽度、深度和上下文分别推高什么
| 改动 | 参数量影响 | 训练时主要代价 |
|---|---|---|
n_embd 从 变为 |
每层主导项约变为 4 倍 | 矩阵乘计算显著增加,激活也变大 |
n_layer 从 变为 |
Transformer 块参数约变为 2 倍 | 激活保存量和前后向计算近似翻倍 |
block_size 从 变为 |
除位置嵌入外几乎不变 | 普通激活约线性增长,标准注意力的 项可能接近 4 倍 |
| batch 从 变为 | 不变 | 每步 token 数与激活近似翻倍 |
因此“124M 参数能不能训”不能只看 124M。短序列、小 batch 时,参数、梯度和 AdamW 状态可能是主要静态项;长序列训练时,激活和注意力临时张量往往更快把显存吃满。
把显存与时间换成实验预算
先把显存拆成静态项和动态项:参数、梯度、优化器状态主要随 变化;激活主要随 batch、、、 和是否启用 activation checkpointing 变化。混合精度主要压低激活与部分算子的存储/带宽压力,并不保证把整个训练显存直接减半。
总训练时间可以从吞吐反推:若训练集总计 个 token,实测吞吐为 tokens_per_second,则单次训练墙钟时间约为 。多卡成本再乘并行 GPU 数并除以 3600,得到 GPU-hours;若使用云 GPU,再乘每 GPU-hour 的实际单价即可。
做模型缩放时,先用参数公式判断宽度和深度带来的静态成本,再用固定 batch 与序列长度跑几十个稳定 step 测真实峰值显存和吞吐。这样得到的数量感,比只看“参数量多少 M”更能指导可运行的 nanoGPT 配置。