
大模型原理与训练 / 系统课时
从字符编码切换到 BPE Token
从字符编码切换到 BPE Token
字符级 Tokenizer 实现简单,但同一段文本往往会被展开成更长序列。切换到 GPT-2 风格的字节级 BPE 后,可以直接使用固定词表把文本编码为整数 ID,并用真实数据比较序列长度、词表规模和二进制存储是否仍兼容 nanoGPT。
学习目标
- 解释字符级编码与 BPE 在词表规模和序列长度上的核心差异
- 使用
tiktoken完成 GPT-2 BPE 的编码、解码与往返验证 - 将文本预处理为 nanoGPT 可读取的
train.bin与val.bin
BPE 改变了什么
字符级编码通常只把训练语料中出现过的字符映射为 ID,因此词表很小,但一个单词会拆成很多位置。GPT-2 使用字节级 BPE:先保证任意字节都能表示,再把训练中高频出现的相邻模式合并为更长 Token。结果是词表变大,而常见文本通常需要更少的序列位置。
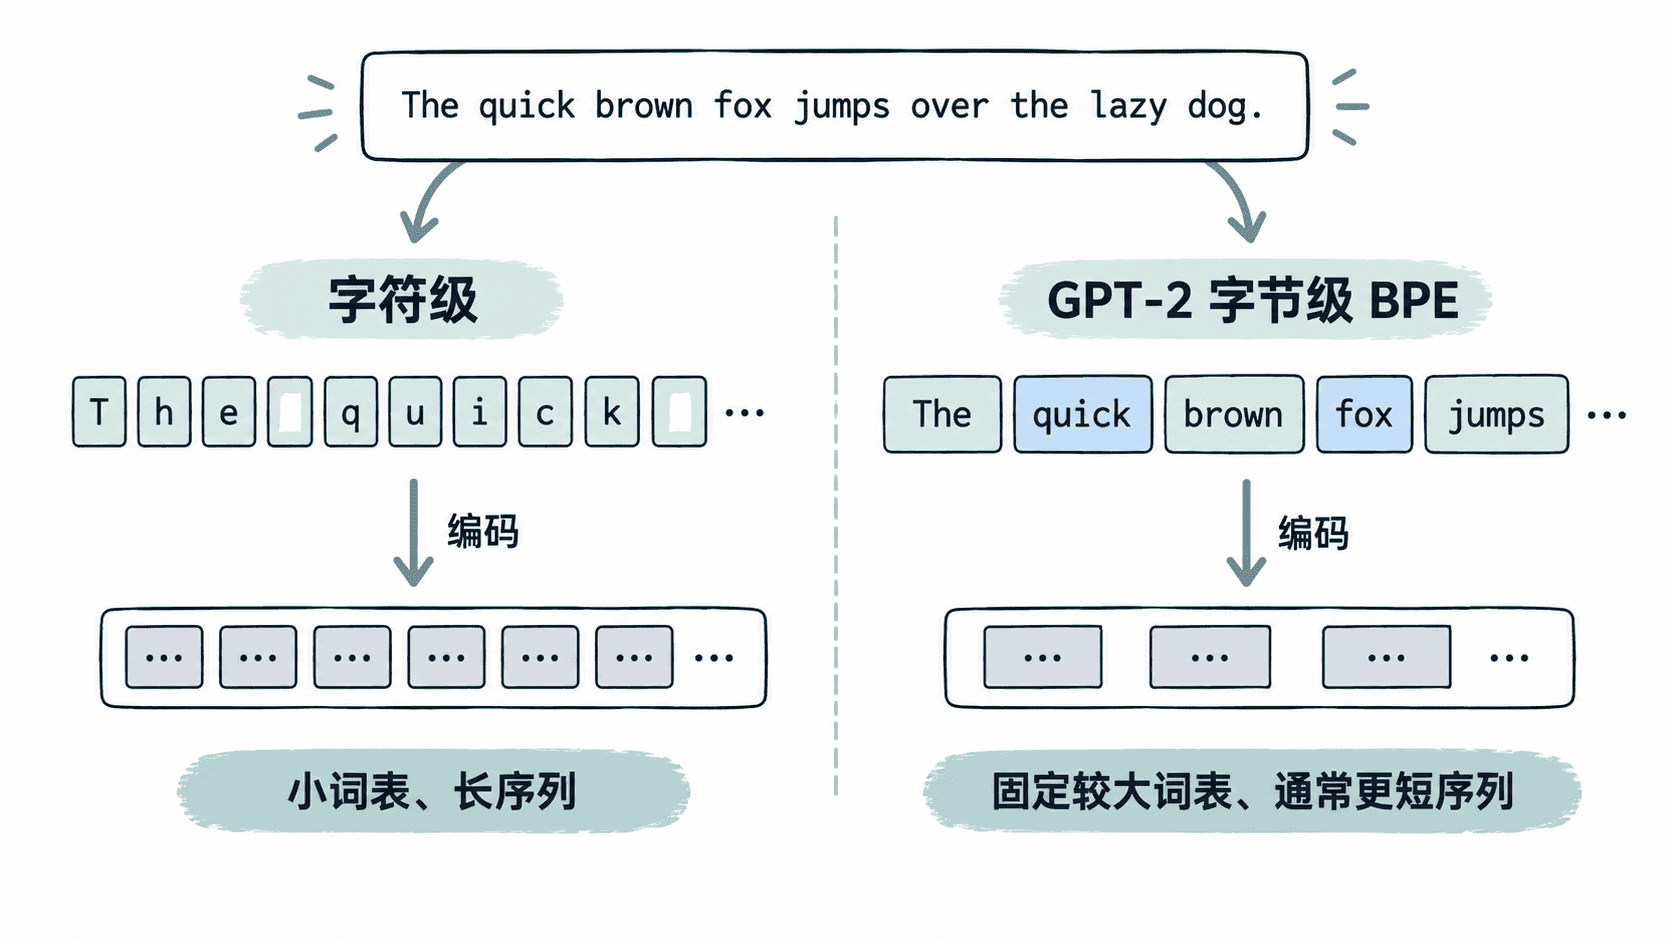
这种“通常更短”不是对所有语言和文本都成立。Tokenizer 的合并规则来自其训练分布;例如用 GPT-2 Tokenizer 处理分布差异很大的多语言文本,某些片段仍可能被拆得很细。因此迁移时要在自己的语料上测 Token 数,而不是只凭词表大小判断收益。
GPT-2 BPE 的词表大小是 50257。它远大于一个小型字符集,但 Token ID 仍能放进 uint16;这意味着 nanoGPT 常见的二进制 Token 文件格式可以继续使用。若以后换成词表大于 65536 的 Tokenizer,就不能继续无条件使用 uint16,否则会发生 ID 溢出。
先验证编码和解码
安装 tiktoken 与预处理脚本需要的 NumPy,并立即做一次导入验证。
python -m pip install -q tiktoken numpy && python -c "import tiktoken, numpy; print('tokenizer ready')"预期输出
tokenizer ready下面的完整脚本使用 GPT-2 编码器验证往返解码,并直接比较一段英文的字符位置数与 BPE Token 数。
import tiktoken

text = "the transformer transforms transformer tokens efficiently"
enc = tiktoken.get_encoding("gpt2")
token_ids = enc.encode_ordinary(text)

print("roundtrip_ok:", enc.decode(token_ids) == text)
print("bpe_shorter_than_chars:", len(token_ids) < len(text))
预期输出
roundtrip_ok: True
bpe_shorter_than_chars: True
encode_ordinary 只做普通文本编码,不把输入字符串解释成特殊 Token。训练语料若需要显式的文档结束标记,应单独设计边界策略,而不是让原始文本里的特殊字符串被意外当成控制 Token。
生成 nanoGPT 的二进制 Token
准备一个 UTF-8 的 input.txt,下面脚本按字符位置先切成训练集和验证集,再分别做 BPE 编码,最后写成 uint16 的 train.bin 与 val.bin。对正式大语料,应该按文档或样本边界切分,避免把同一文档的一部分泄漏到验证集。
from pathlib import Path

import numpy as np
import tiktoken

source = Path("input.txt")
text = source.read_text(encoding="utf-8")
cut = int(len(text) * 0.9)

enc = tiktoken.get_encoding("gpt2")
train_ids = enc.encode_ordinary(text[:cut])
val_ids = enc.encode_ordinary(text[cut:])

max_id = max(max(train_ids, default=0), max(val_ids, default=0))
assert max_id <= np.iinfo(np.uint16).max

np.asarray(train_ids, dtype=np.uint16).tofile("train.bin")
np.asarray(val_ids, dtype=np.uint16).tofile("val.bin")

probe = text[:200]
print("char_vocab:", len(set(text)))
print("bpe_vocab:", enc.n_vocab)
print("char_tokens:", len(text))
print("bpe_tokens:", len(train_ids) + len(val_ids))
print("roundtrip_ok:", enc.decode(enc.encode_ordinary(probe)) == probe)
预期输出
char_vocab: <CHAR_VOCAB>
bpe_vocab: 50257
char_tokens: <CHAR_TOKENS>
bpe_tokens: <BPE_TOKENS>
roundtrip_ok: True<CHAR_VOCAB>、<CHAR_TOKENS> 和 <BPE_TOKENS> 由你的 input.txt 决定。判断迁移效果时重点看 bpe_tokens / char_tokens,它直接影响在相同文本量下需要处理的序列位置数;不要拿 50257 与字符词表大小单独比较后就断言训练一定更快,因为更大的输出词表也会增加嵌入层和最终 logits 计算量。
接回模型配置
下面是片段示例,依赖你的 nanoGPT 模型配置文件。模型的 vocab_size 必须覆盖 Tokenizer 可能产生的全部 ID;直接使用 GPT-2 BPE 时,最直观的配置是 50257。
# 片段示例:放入当前 nanoGPT 的模型配置上下文中
vocab_size = 50257切换后,block_size 表示的是 BPE Token 数,不再是字符数。原先“256 个字符”的上下文与“256 个 BPE Token”的上下文覆盖的原文长度通常不同,因此训练前应重新检查上下文长度、每步 Token 数和显存占用。只要编码与解码能往返、二进制 ID 未溢出、模型词表覆盖 0 到 50256,字符级到 BPE 的数据通路就完成了。