
大模型原理与训练 / 系统课时
认清 GPT 训练到底在预测什么
认清 GPT 训练到底在预测什么
GPT 训练的核心不是“记住一句话”,而是在给定一段上下文后,反复预测下一个 Token。把这个目标看清楚,就能把输入切片、logits、概率分布和交叉熵损失串成一条完整训练链路。
学习目标
- 能把一段 Token 序列拆成上下文与下一个 Token 的监督样本
- 理解 logits、softmax 概率与正确 Token 之间的关系
- 解释交叉熵损失为何能推动模型提高正确下一个 Token 的概率
预测目标不是整句
假设文本被分词后得到 [我, 喜欢, 猫, <EOS>]。自回归训练会把同一条序列转换成多个“已知前缀,预测后继”的位置:看到 我 预测 喜欢,看到 我, 喜欢 预测 猫,再看到更长上下文预测 <EOS>。
实际训练通常一次处理固定长度的 Token 块。输入序列记为 x,目标序列记为 y,两者只错开一个位置。例如 x=[t0,t1,t2] 时,y=[t1,t2,t3]。因此模型在每个位置都承担一次“预测下一个 Token”的任务,而不是只在序列末尾预测一次。
从上下文到损失
每个位置经过 Transformer 后会得到一个隐藏向量,再通过词表投影层产生长度等于词表大小的 logits。logits 不是概率,可以是任意实数;对它应用 softmax 后,才得到所有候选 Token 的概率分布。
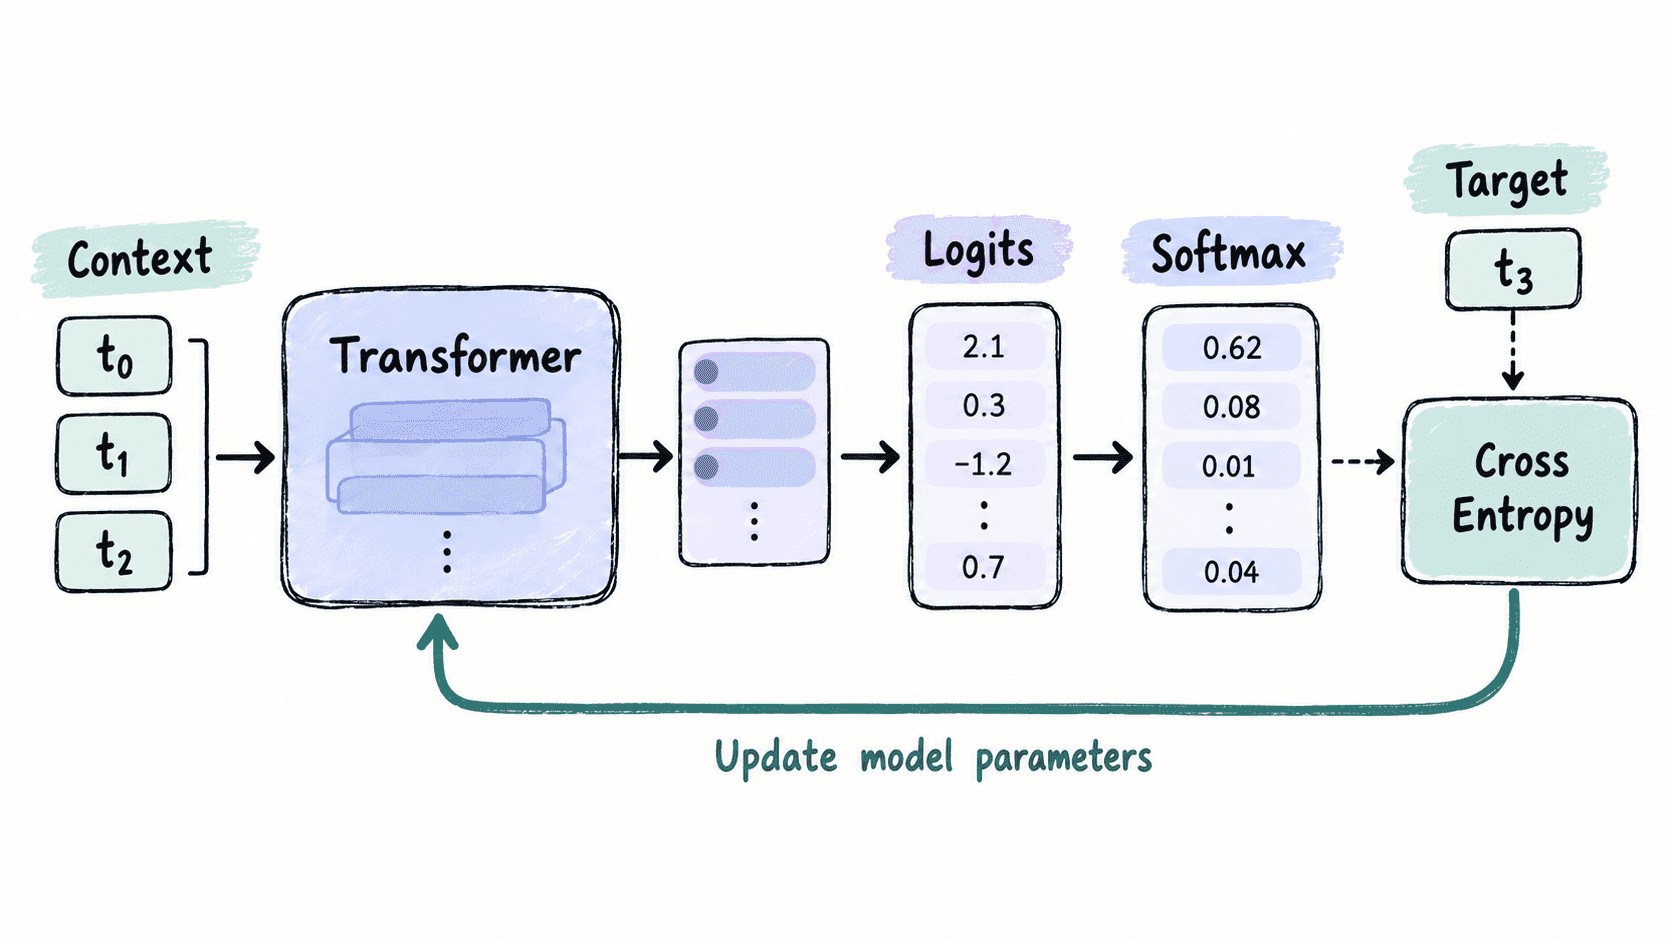
如果正确目标 Token 是 y,模型给它的概率是 p(y),单个位置的损失可以直观写成 。正确 Token 概率越接近 1,损失越小;概率越低,损失越大。训练时对批次内多个位置的损失求平均,再通过反向传播调整参数。
因此,交叉熵并不是单独存在的指标,它直接把“正确答案是哪一个 Token”与“模型当前把多少概率分给它”连接起来。模型真正学到的是:在类似上下文中,怎样重新分配词表上的概率质量。
训练与生成的差别
训练时,目标 Token 已经存在于数据中,所以每个位置都能直接计算损失;一次前向计算就能同时监督多个位置。生成时没有现成答案,模型只能取当前概率分布中的一个 Token,把它追加到上下文,再继续预测下一步。
这也解释了为什么训练数据要做右移目标,而生成循环却要逐 Token 运行。二者使用的是同一个“给上下文预测下一个 Token”的模型,只是一个有标准答案用于计算损失,另一个把预测结果继续喂回模型。
看懂一条训练日志
当训练日志里的 loss 持续下降,最直接的含义是:在训练样本的真实下一个 Token 上,模型平均分配了更高概率。但较低的训练 loss 不等于生成质量一定更好,还需要用验证集 loss 和实际生成结果检查是否过拟合。
后续实现 nanoGPT 时,只要始终抓住“输入右移得到目标、模型输出 logits、交叉熵比较 logits 与目标 Token”这条主线,就不容易在张量形状和训练目标上迷失。