
大模型原理与训练 / 系统课时
推导 Query Key Value 计算
推导 Query Key Value 计算
这一节把固定平均升级为内容相关的自注意力:每个位置先生成 Query、Key、Value,再用 Query 与所有可见 Key 的匹配程度决定读取权重,最后对 Value 做加权求和。完成后,你可以从张量形状直接读懂 nanoGPT 中单头注意力的核心计算。
学习目标
- 解释 Query、Key、Value 在内容相关读取中的不同职责。
- 推导缩放点积注意力从线性投影到加权求和的完整计算。
- 根据张量形状检查因果遮罩、Softmax 与矩阵乘法是否放在正确维度。
Query Key Value 分别做什么
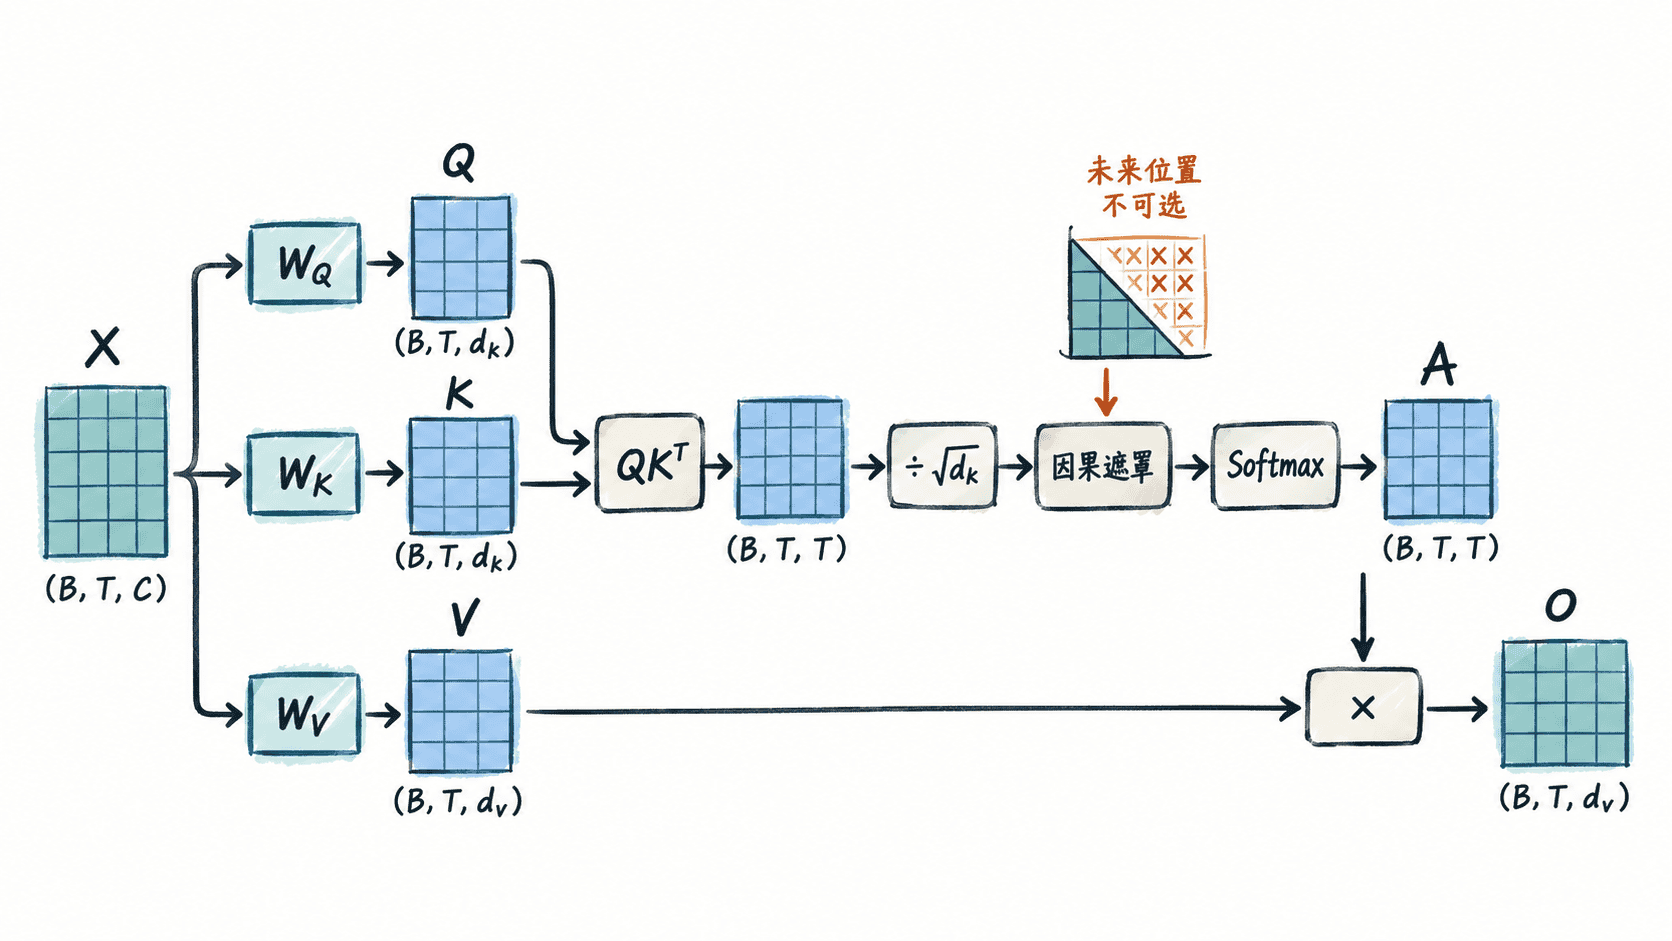
对输入 做三次独立线性投影:
可以把它们理解成三种角色:Query 表示“当前位置想找什么”,Key 表示“每个位置可供匹配的特征”,Value 表示“匹配后真正要取走的信息”。因此,相关性由 Query 和 Key 决定,而最终被汇聚的是 Value。
推导缩放点积注意力
先计算每个 Query 与所有 Key 的点积,得到两两位置之间的相关性分数:
除以 是为了抑制维度变大后点积幅度随之增大的问题,避免 Softmax 过早进入极端饱和区域。随后把未来位置的分数替换为负无穷,再沿最后一个维度做 Softmax:
于是每一行 都是一组和为 1 的读取权重,而且只有当前位置与历史位置可能获得非零概率。最后执行:
这一步与上一节的均值聚合形式完全一致,区别只在于 不再是预先写死的平均矩阵,而是由当前输入内容动态计算出来。
用最小张量验算
下面让 Query 和 Key 直接等于输入,只给 Value 一个固定投影,这样可以把注意力权重和最终输出同时看清楚。
import math
import torch

torch.set_printoptions(precision=4, sci_mode=False)

x = torch.tensor([
    [1.0, 0.0],
    [0.0, 1.0],
    [1.0, 1.0],
])

q = x
k = x
wv = torch.tensor([[1.0, 2.0], [3.0, 4.0]])
v = x @ wv

scores = q @ k.T / math.sqrt(q.size(-1))
mask = torch.tril(torch.ones(3, 3, dtype=torch.bool))
scores = scores.masked_fill(~mask, float("-inf"))
weights = torch.softmax(scores, dim=-1)
out = weights @ v

print("attention weights:")
print(weights)
print("output:")
print(out)
预期输出
attention weights:
tensor([[1.0000, 0.0000, 0.0000],
        [0.3302, 0.6698, 0.0000],
        [0.2483, 0.2483, 0.5035]])
output:
tensor([[1.0000, 2.0000],
        [2.3395, 3.3395],
        [3.0070, 4.5105]])
第一行只能读取自己,所以权重必为 [1, 0, 0]。第二行只能在前两个位置之间分配概率;第三行可以读取全部三个位置,并因为第三个 Key 与当前 Query 的点积更大而给它更高权重。
用形状检查实现是否正确
单头情况下,若 ,则 Q @ K.transpose(-2, -1) 的结果必须是 ,因为每个位置都要与序列中的每个 Key 比较。遮罩和 Softmax 都作用在这个位置对位置的矩阵上。
Value 可以使用维度 ,因此 ,最终 会回到 。如果你的注意力分数不是 ,或 Softmax 没有沿 Key 所在的最后一维归一化,通常说明转置或维度选择出了问题。
Q/K 决定“读谁”,V 决定“读到什么”,因果遮罩决定“允许读谁”。把这三层职责分开后,nanoGPT 中看似紧凑的几行注意力代码就可以按矩阵形状逐步验证,而不再只是记公式。