
大模型原理与训练 / 系统课时
从零复现完整 nanoGPT 项目
从零复现完整 nanoGPT 项目
本节把分散的环节串成一条可验收链路:从原始文本建立字符词表,构造 GPT,完成训练与评估,保存并重新加载检查点,最后生成文本。重点不是追求大模型效果,而是验证数据、模型、优化、恢复和生成五个环节能闭环工作。
学习目标
- 从原始文本完成编码、训练集与验证集构造
- 训练一个最小 GPT,并保存模型、优化器、步数和配置
- 重新加载检查点继续训练,再用模型执行自回归生成
明确最终验收链路
一个最小但完整的 nanoGPT 项目至少要能证明七件事:原始文本可编码,batch 形状正确,模型能计算 loss,loss 能反向传播,验证集可评估,检查点能恢复,恢复后的模型能继续生成。
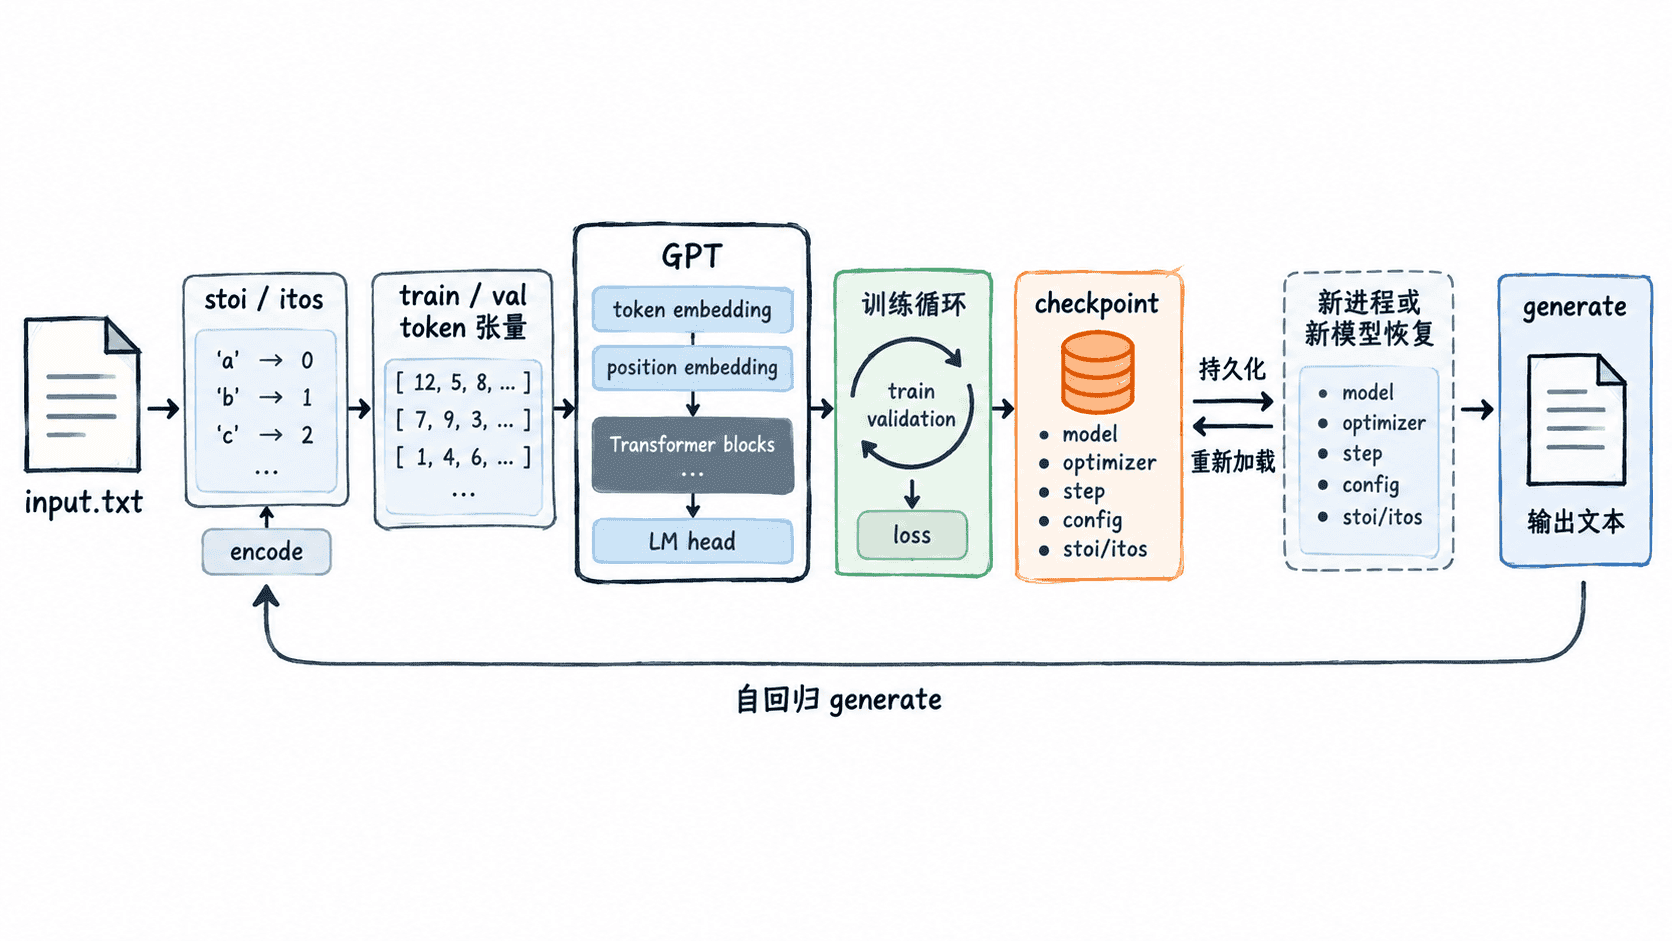
这条链路里最容易漏掉的是检查点元数据。只保存 model.state_dict() 可以用于推理,却不足以可靠恢复训练;要继续优化,还需要优化器状态、当前 step 和构造模型所需的结构配置。
运行一个最小完整实现
下面程序只依赖 PyTorch。若当前目录没有 input.txt,它会先创建一份演示原始文本;实际复现时直接用自己的 UTF-8 文本覆盖该文件即可。为了让 CPU 也能完成验证,模型规模和训练步数都刻意压小。
from pathlib import Path

import torch
import torch.nn as nn
from torch.nn import functional as F

torch.manual_seed(1337)
device = "cuda" if torch.cuda.is_available() else "cpu"

config = {
    "block_size": 64,
    "batch_size": 16,
    "n_embd": 64,
    "n_head": 4,
    "n_layer": 2,
    "learning_rate": 3e-3,
}

path = Path("input.txt")
if not path.exists():
    demo = "nanoGPT learns the next character from raw text. "
    path.write_text(demo * 400, encoding="utf-8")

text = path.read_text(encoding="utf-8")
chars = sorted(set(text))
stoi = {ch: i for i, ch in enumerate(chars)}
itos = {i: ch for ch, i in stoi.items()}
encode = lambda s: [stoi[ch] for ch in s]
decode = lambda ids: "".join(itos[i] for i in ids)

data = torch.tensor(encode(text), dtype=torch.long)
split = int(0.9 * len(data))
train_data, val_data = data[:split], data[split:]
config["vocab_size"] = len(chars)

def get_batch(split_name):
    source = train_data if split_name == "train" else val_data
    max_start = len(source) - config["block_size"] - 1
    if max_start <= 0:
        raise ValueError("corpus is shorter than block_size + 1")
    ix = torch.randint(max_start, (config["batch_size"],))
    x = torch.stack([source[i:i + config["block_size"]] for i in ix])
    y = torch.stack([source[i + 1:i + config["block_size"] + 1] for i in ix])
    return x.to(device), y.to(device)

class Head(nn.Module):
    def __init__(self, head_size):
        super().__init__()
        c = config["n_embd"]
        self.key = nn.Linear(c, head_size, bias=False)
        self.query = nn.Linear(c, head_size, bias=False)
        self.value = nn.Linear(c, head_size, bias=False)
        self.register_buffer(
            "tril",
            torch.tril(torch.ones(config["block_size"], config["block_size"])),
        )

    def forward(self, x):
        _, t, _ = x.shape
        k, q = self.key(x), self.query(x)
        weights = q @ k.transpose(-2, -1) * (k.size(-1) ** -0.5)
        weights = weights.masked_fill(self.tril[:t, :t] == 0, float("-inf"))
        weights = F.softmax(weights, dim=-1)
        return weights @ self.value(x)

class MultiHeadAttention(nn.Module):
    def __init__(self):
        super().__init__()
        head_size = config["n_embd"] // config["n_head"]
        self.heads = nn.ModuleList([Head(head_size) for _ in range(config["n_head"])])
        self.proj = nn.Linear(config["n_embd"], config["n_embd"])

    def forward(self, x):
        return self.proj(torch.cat([head(x) for head in self.heads], dim=-1))

class FeedForward(nn.Module):
    def __init__(self):
        super().__init__()
        c = config["n_embd"]
        self.net = nn.Sequential(nn.Linear(c, 4 * c), nn.GELU(), nn.Linear(4 * c, c))

    def forward(self, x):
        return self.net(x)

class Block(nn.Module):
    def __init__(self):
        super().__init__()
        c = config["n_embd"]
        self.sa = MultiHeadAttention()
        self.ffwd = FeedForward()
        self.ln1 = nn.LayerNorm(c)
        self.ln2 = nn.LayerNorm(c)

    def forward(self, x):
        x = x + self.sa(self.ln1(x))
        return x + self.ffwd(self.ln2(x))

class GPT(nn.Module):
    def __init__(self):
        super().__init__()
        v, c = config["vocab_size"], config["n_embd"]
        self.token_embedding = nn.Embedding(v, c)
        self.position_embedding = nn.Embedding(config["block_size"], c)
        self.blocks = nn.Sequential(*[Block() for _ in range(config["n_layer"])])
        self.ln_f = nn.LayerNorm(c)
        self.lm_head = nn.Linear(c, v)

    def forward(self, idx, targets=None):
        b, t = idx.shape
        tok = self.token_embedding(idx)
        pos = self.position_embedding(torch.arange(t, device=idx.device))
        logits = self.lm_head(self.ln_f(self.blocks(tok + pos)))
        loss = None
        if targets is not None:
            _, _, v = logits.shape
            loss = F.cross_entropy(logits.reshape(b * t, v), targets.reshape(b * t))
        return logits, loss

    @torch.no_grad()
    def generate(self, idx, max_new_tokens):
        for _ in range(max_new_tokens):
            idx_cond = idx[:, -config["block_size"]:]
            logits, _ = self(idx_cond)
            probs = F.softmax(logits[:, -1, :], dim=-1)
            next_id = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, next_id), dim=1)
        return idx

@torch.no_grad()
def estimate_loss(model, rounds=5):
    model.eval()
    losses = []
    for _ in range(rounds):
        xb, yb = get_batch("val")
        _, loss = model(xb, yb)
        losses.append(loss.item())
    model.train()
    return sum(losses) / len(losses)

def train_until(model, optimizer, start_step, end_step):
    model.train()
    for step in range(start_step, end_step):
        xb, yb = get_batch("train")
        _, loss = model(xb, yb)
        optimizer.zero_grad(set_to_none=True)
        loss.backward()
        optimizer.step()
        if (step + 1) % 20 == 0 or step + 1 == end_step:
            print(f"train step={step + 1} loss={loss.item():.4f}")
    return end_step

model = GPT().to(device)
optimizer = torch.optim.AdamW(model.parameters(), lr=config["learning_rate"])

step = train_until(model, optimizer, 0, 40)
val_before = estimate_loss(model)
torch.save(
    {
        "model": model.state_dict(),
        "optimizer": optimizer.state_dict(),
        "step": step,
        "config": config,
        "stoi": stoi,
        "itos": itos,
    },
    "ckpt.pt",
)
print(f"saved step={step} val_loss={val_before:.4f}")

checkpoint = torch.load("ckpt.pt", map_location=device)
model2 = GPT().to(device)
model2.load_state_dict(checkpoint["model"])
optimizer2 = torch.optim.AdamW(model2.parameters(), lr=config["learning_rate"])
optimizer2.load_state_dict(checkpoint["optimizer"])

start_step = int(checkpoint["step"])
print(f"resumed from step={start_step} on {device}")
step = train_until(model2, optimizer2, start_step, 50)
val_after = estimate_loss(model2)

start = torch.zeros((1, 1), dtype=torch.long, device=device)
generated = decode(model2.generate(start, 120)[0].tolist())
print(f"final step={step} val_loss={val_after:.4f}")
print("generated:", generated)
预期输出(loss 与生成文本会因设备和随机采样略有变化):
train step=20 loss=<LOSS>
train step=40 loss=<LOSS>
saved step=40 val_loss=<LOSS>
resumed from step=40 on <DEVICE>
train step=50 loss=<LOSS>
final step=50 val_loss=<LOSS>
generated: <GENERATED_TEXT>
第一次执行后,当前目录应同时出现 input.txt 与 ckpt.pt。其中 ckpt.pt 不只是推理权重,还包含优化器状态、恢复步数、配置和字符映射,因此新的模型实例可以从 step 40 接着训练,而不是重新从 step 0 开始。
对照每个阶段做验收
数据阶段先检查 len(train_data) 和 len(val_data) 都大于 block_size,否则随机切片无法形成完整训练样本。模型阶段要保证 n_embd % n_head == 0,并确认输出 logits 最后一维等于 vocab_size。
训练阶段不要求几十步就生成优美文本,但 loss 必须是有限数值,且反向传播不能报形状或设备错误。评估阶段必须切到 eval(),结束后再回到训练模式;本例没有 dropout,但保留这个习惯可以避免以后扩展模型时出现隐蔽差异。
恢复阶段以 resumed from step=40 为关键证据。如果只加载权重却把 step 重置为 0,或者忘了恢复优化器状态,那只是“热启动”,不是原训练状态的完整续跑。
替换成真实语料时关注边界
这个最小实现使用字符级 token,只是为了让预处理逻辑透明。换成真实 tokenizer 时,数据流仍然不变:原始文本先变成 token ID,再按 block_size + 1 切出输入和下一 token 标签。改变 tokenizer 后必须同步保存新的词表或 tokenizer 标识,并让 vocab_size 与模型输出层一致。
当真实语料更长、模型更大时,不要一次同时放大 block_size、batch 和层数。先保证这条最小链路可以训练、评估、保存、恢复、生成,再逐项扩大规模;这样一旦出错,你能明确知道是哪次变更破坏了闭环。