
计算机网络 / 系统课时
认识队头阻塞
认识队头阻塞
队头阻塞指前面的工作没有完成,导致本来可以继续处理的后续工作一起等待。HTTP/1.1 与 HTTP/2 都可能出现这种现象,但阻塞发生的层次不同:前者主要受请求与响应排队影响,后者仍会受到 TCP 丢包重传的跨流影响。
学习目标
- 区分 HTTP/1.1 请求排队与 HTTP/2 TCP 队头阻塞
- 用具体时序判断一个慢响应或一个丢失数据包会影响哪些请求
- 解释为什么 HTTP/2 多路复用能改善排队,却不能消除 TCP 丢包造成的阻塞
两种阻塞不要混为一谈
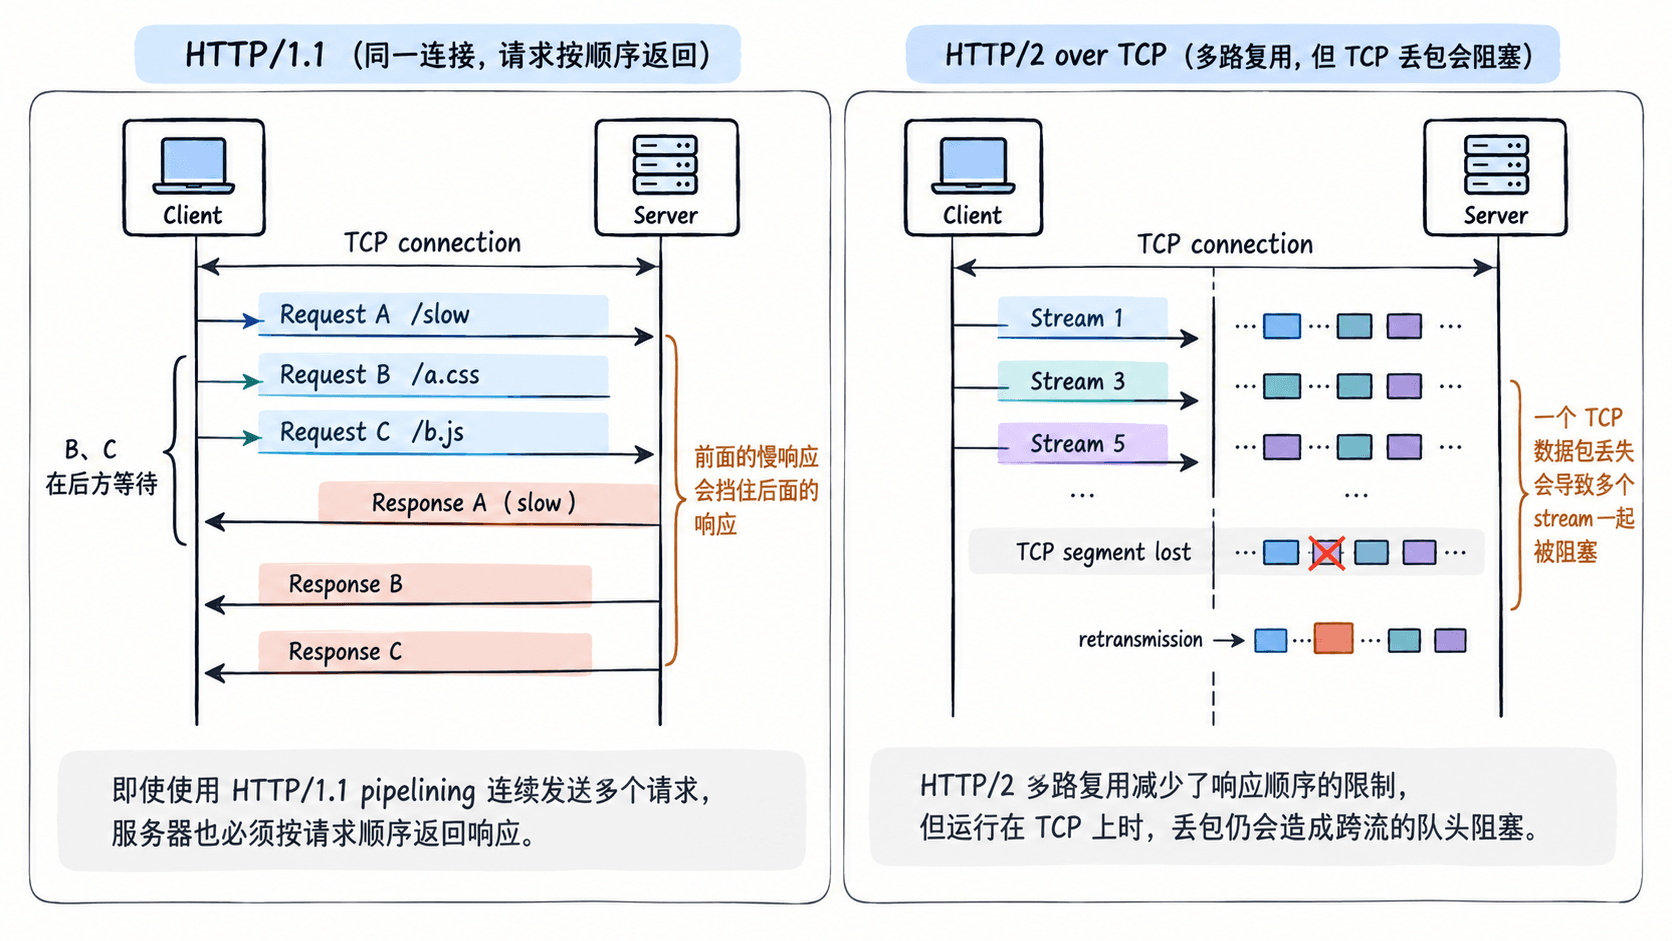
先把问题拆成应用层和传输层。HTTP/1.1 的一条连接在普通浏览器实践中通常一次处理一个正在等待响应的请求,后续请求可能排队;历史上的 HTTP/1.1 pipelining 虽允许连续发送多个请求,但服务器必须按请求顺序发送对应响应,因此前面的慢响应仍会挡住后面的响应。
HTTP/2 把一条连接拆成多个独立 stream,服务器可以交错发送不同 stream 的 frame,因此一个业务响应处理较慢时,不必强制其他 stream 等它先完整发送。不过 HTTP/2 通常运行在 TCP 上,TCP 对上层提供按字节顺序交付的数据流,一段 TCP 数据丢失后,后续已经到达的数据也要等待缺失部分重传完成。
HTTP/1.1 为什么容易排队
假设同一连接依次需要 /slow、/a.css、/b.js 三个响应,其中 /slow 在服务器端计算 800 ms,另外两个资源各需 40 ms。如果请求只能顺序完成,那么第二个资源最早要在约 800 ms 后才能开始返回,第三个还要继续等待,即使它们自身处理非常快。
浏览器常用多条 HTTP/1.1 连接缓解这个问题。假设同一 origin 有 12 个各需 100 ms 的独立资源,只有 1 条连接时,理想化顺序处理约需 1200 ms;若有 6 条连接且资源可以均匀并行,理想化处理部分可接近 200 ms。实际结果还会叠加握手、带宽竞争和服务器并发限制,因此增加连接只能缓解排队,不等于线性提速。
HTTP/2 改善了什么又留下什么
HTTP/2 的多路复用允许 Stream 1 正在等待数据库时,服务器继续发送 Stream 3 的 CSS 和 Stream 5 的图片数据。这样,请求之间不再因为 HTTP/1.1 的响应顺序约束而天然串行,单个连接就能承载大量并发 stream,也减少了依靠多条 TCP 连接制造并发的必要性。
但三个 stream 的 frame 最终都写入同一条 TCP 字节流。假设编号靠前的一段 TCP 数据在网络中丢失,后面的字节即使已经到达接收端,TCP 也必须先等待缺失数据重传,再按序交付给 HTTP/2。结果是多个原本独立的 stream 会同时出现延迟尖峰,这就是 HTTP/2 常说的 TCP 层队头阻塞。
HTTP/3 把传输改为 QUIC,并为不同 stream 提供独立的有序交付范围。某个 stream 的数据丢失时,通常只阻塞该 stream 的有序数据,不会因为全连接统一字节序而直接卡住其他 stream;不过所有 stream 仍共享网络路径和拥塞控制资源,因此丢包依旧可能影响整体吞吐。
用数字判断问题在哪一层
假设页面同时有三个请求 A、B、C。A 的服务端处理时间为 900 ms,B 和 C 都是 50 ms。如果 HTTP/1.1 抓包中看到 B、C 在 A 完成后才开始获得响应,而网络没有明显重传,应优先检查连接内请求排队、慢接口和并发连接数量,而不是先归因于丢包。
另一种情况是 HTTP/2 中三个 stream 都已开始传输,但它们几乎在同一时刻停顿 120 ms,抓包又能对应到 TCP Retransmission 或重复 ACK,随后多个 stream 同时恢复。这种模式更符合 TCP 层丢包造成的跨流阻塞。若只有一个 stream 长时间停顿而其他 stream 正常前进,则应继续检查该请求自己的后端处理、流控或应用逻辑。
实际分析时可以按这个顺序检查:先确认使用的是 HTTP/1.1、HTTP/2 还是 HTTP/3;再看慢请求是否只影响自身还是同时影响其他请求;最后结合 TCP 重传、RTT、服务端处理时间和连接并发度定位层次。只有先分清阻塞发生在哪一层,增加连接、升级协议或优化慢接口才不会治错问题。