
计算机网络 / 系统课时
梳理网页访问链路
梳理网页访问链路
在浏览器输入网址后,页面不会直接从服务器“出现”。浏览器要先确定目标主机地址,再建立可传输数据的连接,发送 HTTP 请求并接收响应,最后解析 HTML 及其引用的资源。理解这条链路后,遇到网页打不开或加载慢时就能判断问题卡在哪一段。
学习目标
- 能按顺序说明 DNS、连接建立、HTTP 请求与响应、页面渲染之间的关系。
- 能从 URL 判断协议、主机、端口和请求路径,并知道它们分别影响哪一步。
- 能使用浏览器开发者工具或
curl判断请求是否已经到达 HTTP 阶段。
从 URL 确定访问目标
以 https://example.com/products?id=42 为例,浏览器首先拆出几个实际参与访问的部分:协议是 HTTPS,主机名是 example.com,未显式写端口时 HTTPS 默认使用 TCP 443,路径和查询字符串组成 /products?id=42。URL 中的 #section 属于页面片段标识,不会作为 HTTP 请求目标发送给服务器。
可以先用下面的检查表判断一次访问真正要连接到哪里:
| URL 部分 | 示例 | 实际作用 |
|---|---|---|
| Scheme | https |
决定使用 HTTPS,并通常连接 443 端口 |
| Host | example.com |
交给 DNS 解析为 IP 地址 |
| Port | 443 |
决定连接目标端口;省略时使用协议默认值 |
| Path | /products |
进入 HTTP 请求行,请求服务器上的目标资源 |
| Query | id=42 |
随请求路径发送给服务器 |
从 DNS 到连接建立
浏览器知道主机名后,需要获得可连接的 IP 地址。它可能先命中浏览器、操作系统或本地网络中的 DNS 缓存;未命中时才继续向 DNS 解析器查询。拿到地址后,HTTP/1.1 和 HTTP/2 通常通过 TCP 建立连接;如果使用 HTTPS,还要在 TCP 连接上完成 TLS 握手,再传输 HTTP 数据。
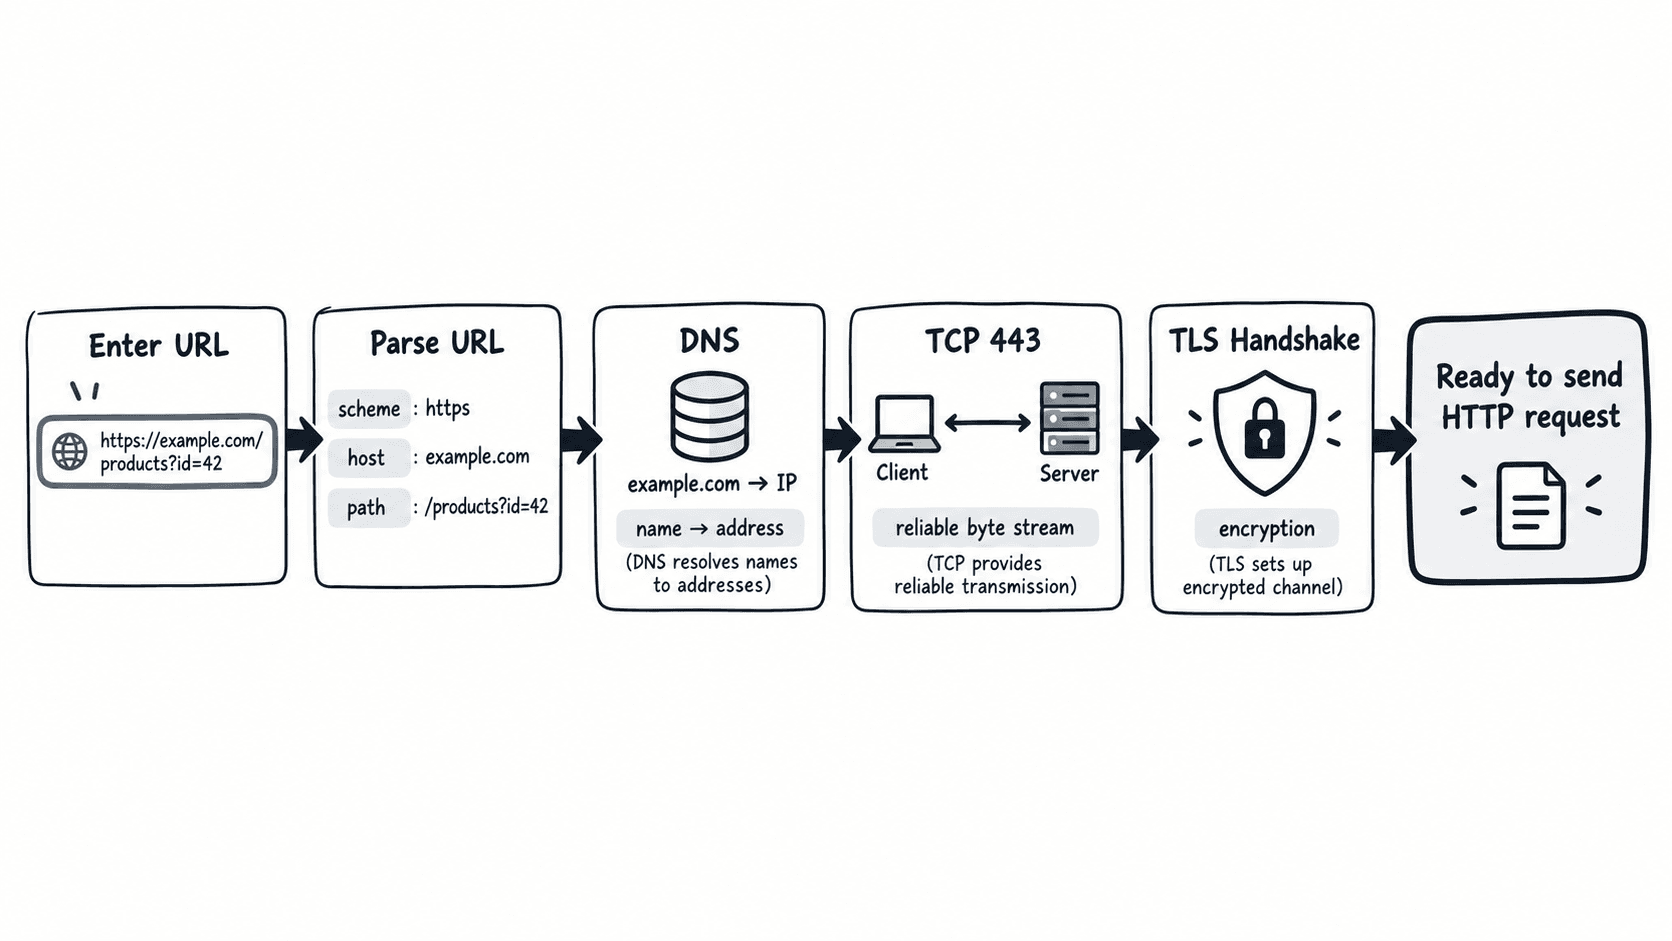
排查时可以按这个顺序切分问题:域名完全无法解析,先检查 DNS;能解析但目标端口连接失败,检查网络、防火墙或服务监听;已经建立连接但 HTTPS 握手失败,再检查证书、TLS 版本或代理。不要看到“网页打不开”就直接归因于 HTTP。
请求和响应如何完成一次 HTTP 交换
连接可用后,浏览器才发送 HTTP 请求。以 HTTP/1.1 为例,请求至少包含方法、请求目标和主机信息;服务器处理后返回状态码、响应头和响应体。一个 HTML 文档返回 200 OK 只说明这一次请求成功,不代表页面引用的 CSS、JavaScript、字体和图片也全部成功。
可以用 curl 单独验证 HTTP 响应头,绕开页面渲染逻辑:
curl -I --http1.1 https://example.com/预期输出会以成功状态行开头,其他响应头可能随服务端实现变化:
HTTP/1.1 200 OK如果这里已经得到 HTTP 状态码,就说明 DNS、底层连接以及 HTTPS 握手至少已经完成到能够交换 HTTP 数据的程度。若返回 404 Not Found,网络链路通常是通的,问题已经进入服务器资源或路由层面;若返回 500 Internal Server Error,则应优先检查服务端处理逻辑。
浏览器收到 HTML 后还要继续请求资源
浏览器收到 HTML 后会解析文档,并根据其中的 link、script、img 等引用继续发起请求。例如首页 HTML 为 30 KB,但它又引用 2 个 CSS、3 个 JavaScript 和 8 张图片,那么一次“打开网页”至少可能对应 14 次 HTTP 请求,而不是一次请求结束就完成显示。
实际检查时,在 Chrome 或 Edge 打开开发者工具后进入 Network,刷新页面,再观察每一行请求的 Status、Type、Size 和 Time。若主文档是 200,但某个脚本是 404,页面仍可能白屏或功能缺失;若所有请求都成功但脚本执行报错,则问题已经越过 HTTP 传输阶段,应转到 Console 检查前端运行错误。
把访问故障按 DNS、连接、HTTP、资源加载和前端执行逐层切开,比只盯着“页面有没有显示”更容易找到真正的失败位置。