
计算机网络 / 系统课时
控制请求体大小
控制请求体大小
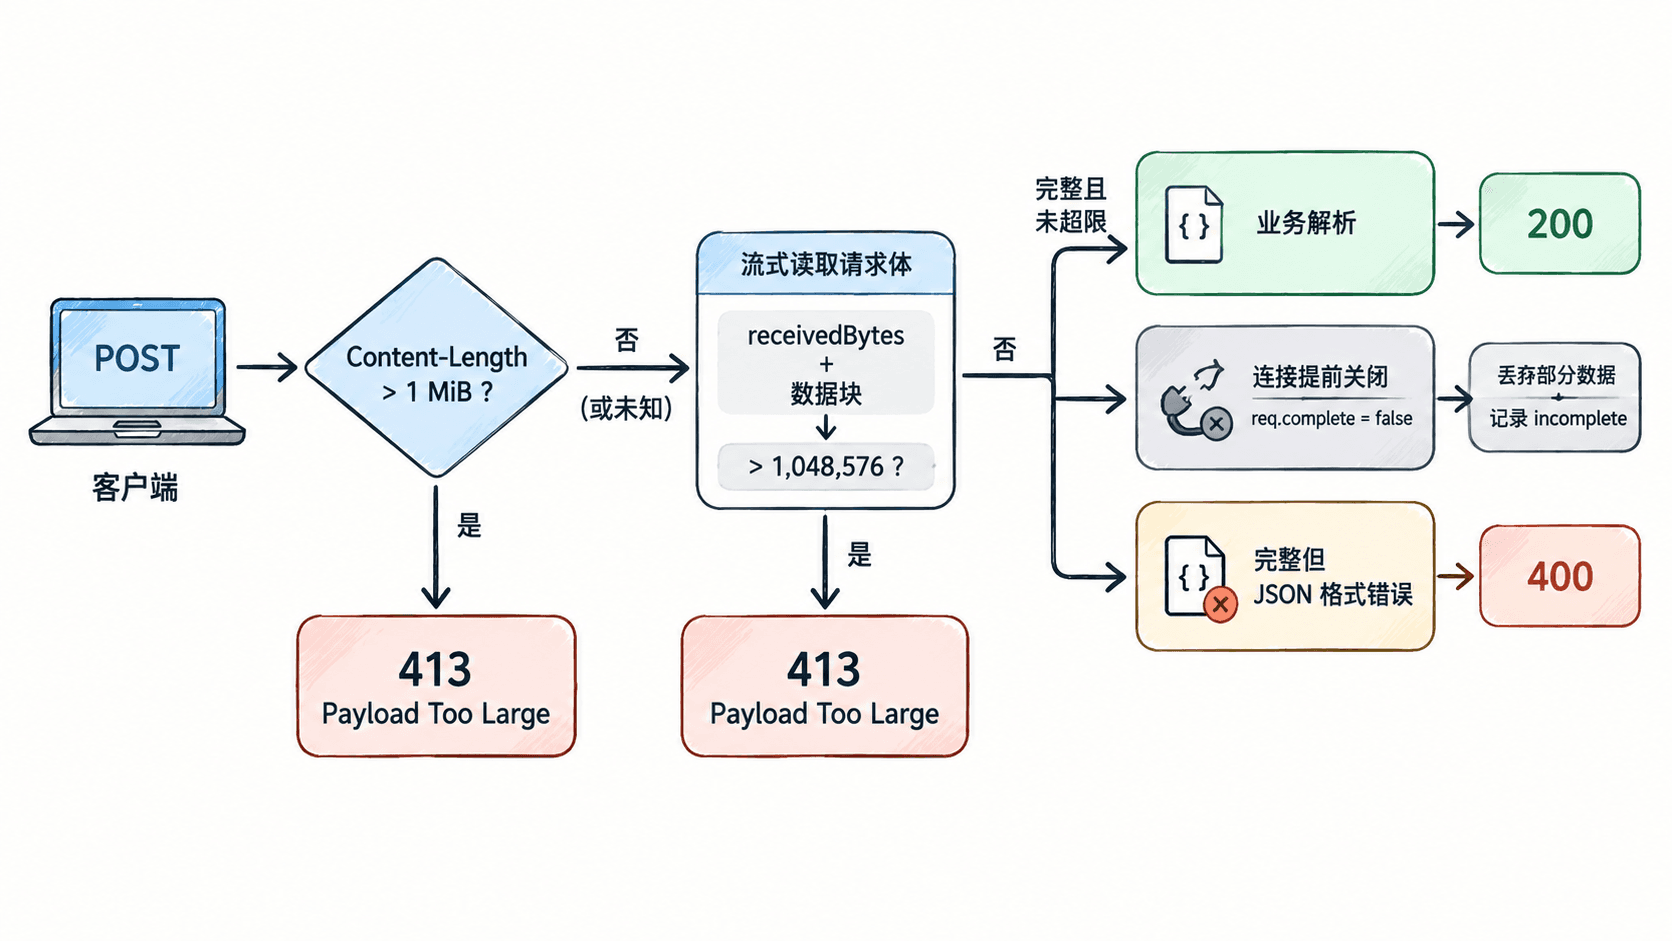
请求体限制要同时防住“声明得太大”和“实际传得太多”两种情况,还要把中途断线视为未完成请求而不是可处理数据。下面以 1 MiB 上限为例,给出可直接运行的服务端实现和超限、正常、中断三类验证方法。
学习目标
- 能在读取请求体前利用
Content-Length提前拒绝明显超限请求。 - 能在流式读取时累计实际字节数,处理未知长度或分块传输的请求。
- 能区分
413 Content Too Large、客户端中断和应用层格式错误的处理方式。
先确定限制与判定顺序
假设一个 JSON 接口最多接收 1 MiB,即 1,048,576 字节。第一道检查放在请求头:若合法的 Content-Length 已大于上限,立即返回 413,避免进入解析器。第二道检查必须放在读取循环里,因为请求可能没有 Content-Length,或者通过流式传输逐块到达。
| 情况 | 服务端动作 | 典型结果 |
|---|---|---|
Content-Length 明确且大于 1 MiB |
读取正文前拒绝 | 413 Content Too Large |
| 长度未知,累计读取超过 1 MiB | 停止缓存并返回超限 | 413 Content Too Large |
| 连接在完整请求体到达前关闭 | 丢弃已收数据并记录不完整请求 | 通常无法再可靠返回状态码 |
| 请求体完整但 JSON 语法错误 | 进入应用层解析后拒绝 | 常见为 400 Bad Request |
对于上传接口,代理层和应用层应使用一致或更严格的限制。例如 Nginx 可在 server 或 location 中设置 client_max_body_size 1m;;应用仍要保留自己的字节计数,避免绕过代理直连时失去保护。
location /upload {
    client_max_body_size 1m;
    proxy_pass http://127.0.0.1:18080;
}
配置生效后,用 nginx -t 检查语法,再执行重载;验证时发送超过 1 MiB 的请求,代理层应直接拒绝而不会把完整正文转发给上游。
在应用层同时检查声明长度和实际长度
下面的 Node.js 示例使用核心 http 模块,将请求体上限固定为 1 MiB。它先检查 Content-Length,随后在 data 事件中累计真实字节数;一旦超限,不再缓存后续块。close 时若 req.complete 为 false,说明 HTTP 请求没有完整接收。
import { createServer } from "node:http";

const MAX_BODY = 1024 * 1024;

createServer((req, res) => {
  if (req.method !== "POST") {
    res.writeHead(405, { "Allow": "POST" });
    return res.end("method not allowed\n");
  }

  const contentLength = req.headers["content-length"];
  if (contentLength !== undefined && Number(contentLength) > MAX_BODY) {
    res.writeHead(413, { "Connection": "close" });
    return res.end("body too large\n");
  }

  let receivedBytes = 0;
  let rejected = false;
  const chunks = [];

  req.on("data", (chunk) => {
    receivedBytes += chunk.length;

    // 长度未知时也以实际收到的字节数为准。
    if (receivedBytes > MAX_BODY) {
      if (!rejected) {
        rejected = true;
        res.writeHead(413, { "Connection": "close" });
        res.end("body too large\n");
      }
      return;
    }

    chunks.push(chunk);
  });

  req.on("end", () => {
    if (rejected) return;

    const body = Buffer.concat(chunks);
    res.writeHead(200, { "Content-Type": "text/plain" });
    res.end(`received ${body.length} bytes\n`);
  });

  req.on("close", () => {
    // 未完整接收时不得把 chunks 当作有效业务数据。
    if (!req.complete) {
      console.error(`incomplete request: received ${receivedBytes} bytes`);
    }
  });
}).listen(18080, () => console.log("listening on 18080"));
运行服务:
node body-limit-server.mjs预期输出:
listening on 18080保存代码为 body-limit-server.mjs 后,发送 5 字节正文:
printf 'hello' | curl -sS -o /tmp/body.txt -w '%{http_code}\n' --data-binary @- http://localhost:18080/
cat /tmp/body.txt
预期输出:
200
received 5 bytes
验证超限与中途断线
先发送 1,048,577 字节,比限制多 1 字节。即使客户端没有可提前利用的长度,应用层累计计数也会触发 413,而且 chunks 不会继续增长。
python3 -c 'import sys; sys.stdout.buffer.write(b"x" * 1048577)' | curl -sS -o /tmp/body.txt -w '%{http_code}\n' --data-binary @- http://localhost:18080/
cat /tmp/body.txt
预期输出:
413
body too large
要模拟“不完整请求”,可以声明 10 字节正文,只发送 3 字节后直接关闭 TCP 连接:
python3 - <<'PY'
import socket

s = socket.create_connection(("127.0.0.1", 18080))
s.sendall(
    b"POST / HTTP/1.1\r\n"
    b"Host: localhost\r\n"
    b"Content-Length: 10\r\n"
    b"\r\n"
    b"abc"
)
s.close()
PY
预期结果是客户端不会拿到正常业务响应,而服务端终端记录类似:
incomplete request: received 3 bytes这里的关键不是给中断连接“补一个状态码”,而是保证部分正文不会进入业务逻辑、不会落库,也不会被误当成一次成功上传。
生产环境还要限制读取成本
仅限制最终缓存大小还不够。大文件接口应同时设置反向代理大小上限、请求读取超时和应用层字节计数;JSON 等小请求可以采用更低阈值,例如 1 MiB,图片上传可以单独放宽到 10 MiB 或业务允许值,避免所有路由共用一个过大的全局上限。
如果客户端会上传大文件,可配合 Expect: 100-continue:服务器在只看请求头时就发现 Content-Length 超限,可以直接回最终 413,客户端无需先发送完整正文。对于无法预知长度的流式请求,则仍必须按实际收到的字节累计判断。