
计算机网络 / 系统课时
理解内容长度与分块传输
理解内容长度与分块传输
HTTP/1.1 连接可以连续承载多条消息,因此接收方必须准确知道当前正文在哪里结束。本节用 Content-Length、Transfer-Encoding: chunked 和关闭连接三种边界方式,建立一套可按顺序执行的判断规则。
学习目标
- 能根据 HTTP/1.1 首部和状态码判断消息正文的结束位置。
- 能解释
Content-Length统计的是字节数而不是字符数。 - 能手工还原一个 chunked 正文,并识别首部冲突带来的风险。
先判断消息是否允许带正文
不要先看到 Content-Length 就开始读正文。HTTP/1.1 的响应边界先受请求方法和状态码约束:HEAD 的响应、所有 1xx、204、304 响应都在首部后的空行处结束,不包含消息正文;CONNECT 的成功 2xx 响应则在首部后切换为隧道。
| 场景 | 接收方怎么判断边界 |
|---|---|
HEAD 的响应 |
首部后的空行即消息结束,即使存在 Content-Length 也不读取正文 |
1xx、204、304 响应 |
不允许消息正文,首部结束即消息结束 |
CONNECT 的 2xx 响应 |
首部结束后进入隧道,后续字节不再按普通 HTTP 消息正文解析 |
| 其他普通请求或响应 | 再检查 Transfer-Encoding、Content-Length 等边界信息 |
HEAD 响应里的 Content-Length 可以表示对应 GET 响应本来会有多大,但它不意味着当前消息真的带了这些字节。完整优先级可对照 RFC 9112 的消息体长度规则。
已知长度时用 Content-Length
当消息没有 Transfer-Encoding 时,Content-Length: N 表示接收方应读取恰好 N 个八位字节。下面是片段示例,假设连接上传输的是 HTTP/1.1 明文格式,正文 Hello 正好是 5 个字节。
HTTP/1.1 200 OK
Content-Type: text/plain
Content-Length: 5

Hello
这里的长度不是“字符个数”。UTF-8 中汉字通常占多个字节,在 Linux、macOS 或 WSL 中可以直接检查字符串的字节数。
printf '你好' | wc -c预期输出:
6如果实际只收到 4 个字节而连接就断开,这条消息是不完整的;如果发送方声明 5 个字节却多发数据,接收方也不能把多余字节随意当成下一条响应处理,否则会破坏消息边界。
未知长度时用 chunked
服务器无法提前知道最终长度时,HTTP/1.1 可以使用 Transfer-Encoding: chunked。每个块先写十六进制长度,再写该块数据;长度为 0 的终止块表示正文结束,因此连接可以继续复用,不必靠断开连接来标记结尾。
下面是片段示例。为便于阅读,代码块中的换行表示 HTTP/1.1 线上的 CRLF;4 和 5 分别是两个块的十六进制字节数,解码后的正文是 Wikipedia,共 9 字节。
HTTP/1.1 200 OK
Content-Type: text/plain
Transfer-Encoding: chunked

4
Wiki
5
pedia
0
发送 Transfer-Encoding 的消息不应再发送 Content-Length。如果接收方同时看到两者,应把它视为可疑的报文分帧冲突;规范要求 Transfer-Encoding 在边界判断上优先,而转发方在继续转发前需要移除收到的 Content-Length。这类歧义也是 HTTP 请求走私的重要诱因之一。
按固定优先级找消息边界
实际排查时按同一顺序判断,不要根据“看起来像完整 HTML”来猜边界:先处理无正文响应和 CONNECT 隧道,再处理 Transfer-Encoding,然后检查 Content-Length。请求既没有长度也没有传输编码时正文长度为 0;普通响应两者都没有时,才退回到“读到服务器关闭连接”为止。
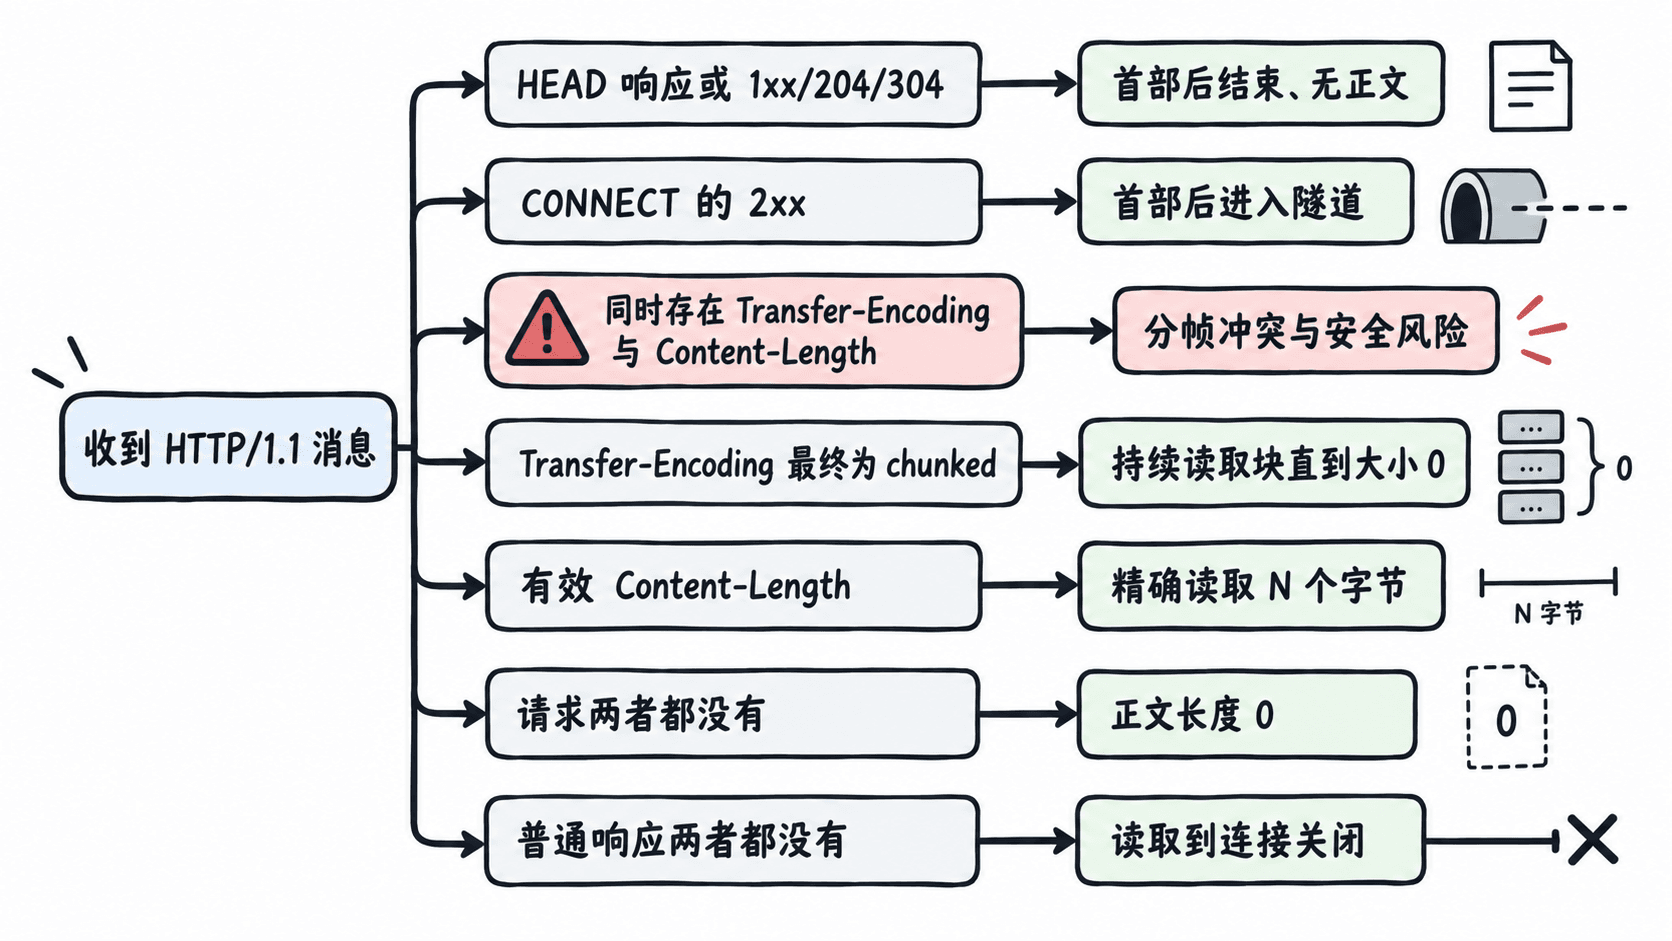
如果 Transfer-Encoding 存在但最终编码不是 chunked,请求无法可靠确定边界,应按错误处理;响应则只能靠连接关闭确定结束。关闭连接分帧无法区分“正常结束”和“网络中断导致的截断”,所以实际系统应优先使用明确的长度或分块边界。