
计算机网络 / 系统课时
认识 URL 结构
认识 URL 结构
URL 不只是浏览器地址栏里的一串文字,它精确描述了“用什么协议、访问哪台主机、哪个端口、哪个资源,以及附带什么参数”。把 URL 拆成固定组成部分后,阅读接口地址、排查跳转错误和分析 HTTP 请求都会容易很多。
学习目标
- 能从完整 URL 中识别协议、主机、端口、路径、查询参数和片段。
- 能判断省略端口时实际使用的默认端口,并区分路径与查询参数。
- 能解释
#后的片段为什么通常不会随 HTTP 请求发送给服务器。
从一个完整 URL 拆开
以 https://api.example.com:8443/v1/users?limit=20&sort=name#result 为例,可以按从左到右的顺序拆成六部分。实际 URL 不一定六项全部出现,但各部分的位置和分隔符是确定的。
| 部分 | 示例 | 作用 |
|---|---|---|
| 协议 Scheme | https |
指定访问资源采用的协议 |
| 主机 Host | api.example.com |
指定目标服务器的域名或 IP 地址 |
| 端口 Port | 8443 |
指定目标主机上的服务端口 |
| 路径 Path | /v1/users |
指定服务器上的资源位置 |
| 查询 Query | limit=20&sort=name |
向资源附带键值参数 |
| 片段 Fragment | result |
定位客户端文档内部位置或状态 |
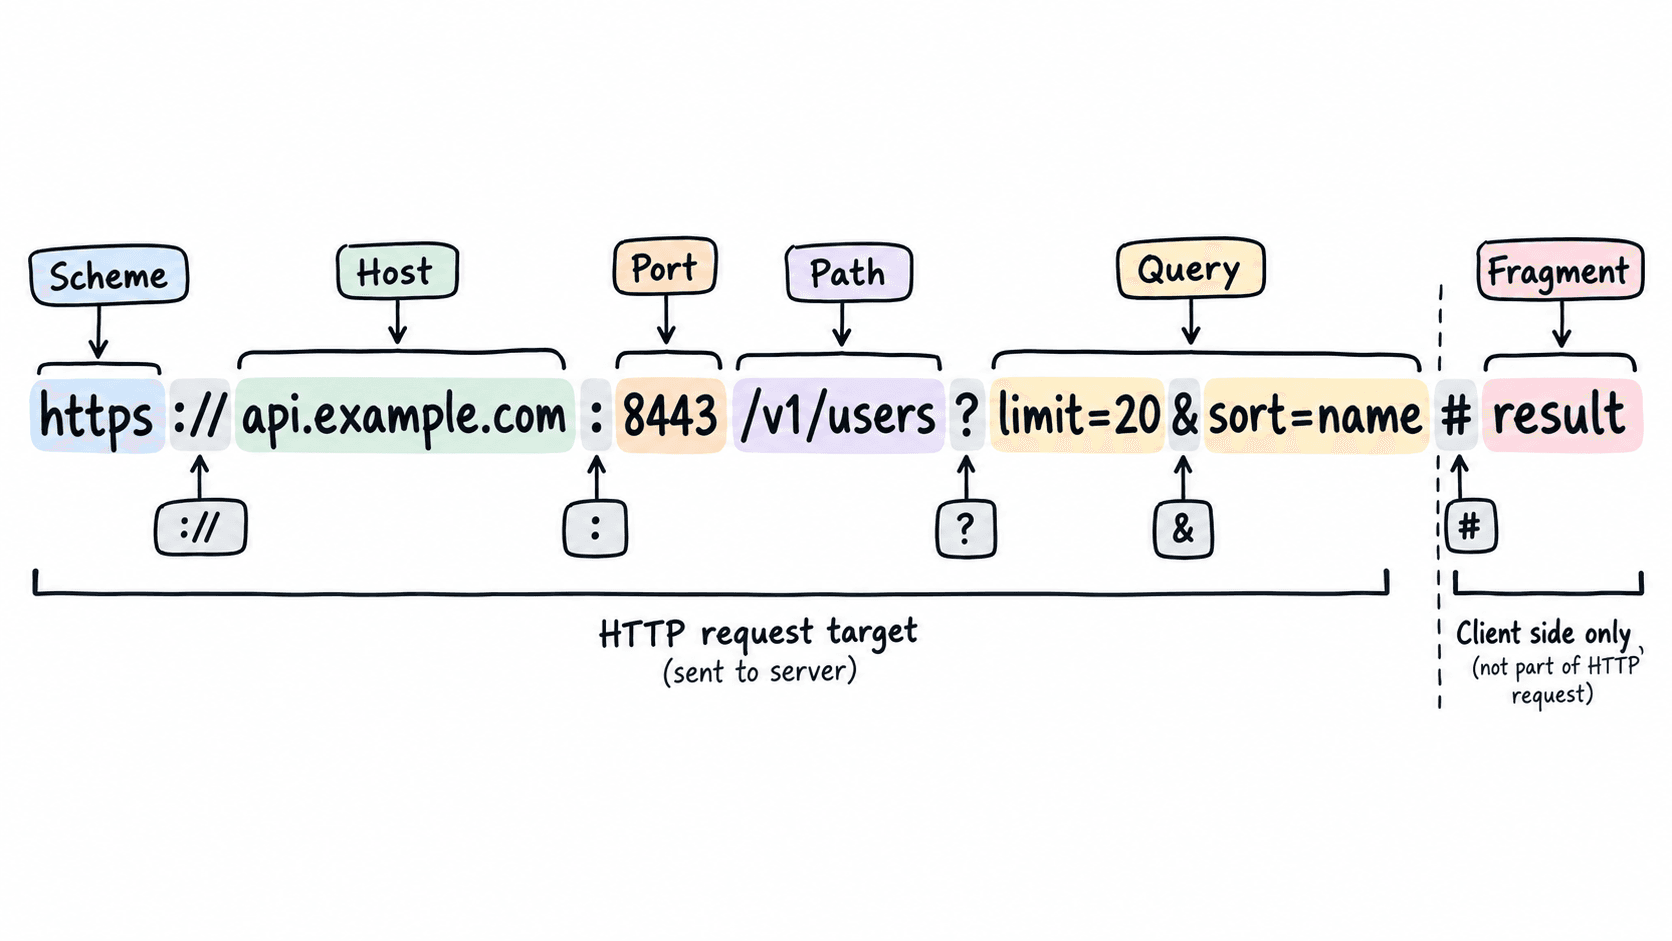
判断时不要从字符串长度猜,而要看分隔符::// 前通常是协议,主机后的 :数字 是显式端口,第一个 / 开始进入路径,? 后进入查询字符串,# 后则进入片段。
协议、主机和端口确定连接目标
http://example.com/ 没有显式写端口时,HTTP 默认使用端口 80;https://example.com/ 默认使用 443。如果写成 https://example.com:8443/,浏览器会连接 8443,不会再使用 443。
协议、主机和有效端口共同决定一个 Web Origin。例如 https://example.com 与 https://example.com:8443 的端口不同,因此属于不同源;http://example.com 与 https://example.com 的协议不同,也属于不同源。
路径定位资源
路径从主机之后的 / 开始,到 ? 或 # 之前结束。例如 https://example.com/products/42 的路径是 /products/42,而 https://example.com/products/42?view=full 的路径仍然只是 /products/42。
在传统网站中,路径可能接近服务器文件结构;在现代 Web API 中,它更多表示路由。例如 /users/42/orders 可以表示“用户 42 的订单”,并不意味着服务器磁盘上真的存在 users/42/orders 目录。
对于 https://example.com 这种没有显式路径的地址,HTTP 请求资源时通常使用根路径 /。因此排查服务端路由时,应把“空白地址栏路径”和实际请求中的 / 联系起来看。
查询参数和片段不要混淆
查询字符串从 ? 开始,多个参数通常用 & 分隔。地址 https://example.com/search?q=http&limit=10 中,查询部分是 q=http&limit=10,可以拆出 q=http 与 limit=10 两项。
查询参数会参与发往服务器的请求目标,服务端可以据此筛选、分页或排序。参数值包含空格、中文、& 等特殊字符时需要 URL 百分号编码,因此实际地址中可能看到 %20、%E4%... 这样的内容。
片段从 # 开始。例如 https://example.com/guide#install 中,install 用于客户端定位页面中的某个位置。浏览器发起 HTTP 请求时,通常请求的是 /guide,不会把 #install 作为请求目标发送给服务器。
用固定顺序检查任意 URL
拿到陌生 URL 时,可以按固定顺序检查:先找 :// 确定协议,再确认主机;检查主机后是否存在显式 :端口;随后读取路径;遇到 ? 后转为查询参数;遇到 # 后剩余内容全部视为片段。
例如 http://127.0.0.1:8080/api/items?page=2#debug 可以得到协议 http、主机 127.0.0.1、端口 8080、路径 /api/items、查询 page=2、片段 debug。只要按这个顺序拆解,即使 URL 很长,也能快速判断每段内容真正影响的是连接、服务器资源还是客户端状态。