
计算机网络 / 系统课时
处理字符编码
处理字符编码
HTTP 传输的是字节,乱码通常发生在“发送端按一种编码写成字节,接收端却按另一种编码解释”这一环。本课用 UTF-8 的实际字节、Content-Type 的 charset 参数和一个可复现的错误解码示例,建立可直接用于排查的顺序。
学习目标
- 能说明 Unicode 字符、UTF-8 字节与 HTTP 消息体之间的关系。
- 能正确设置文本响应的
Content-Type与charset。 - 能根据典型乱码现象判断是错误解码、字节损坏还是重复转码。
文本从字符到字节
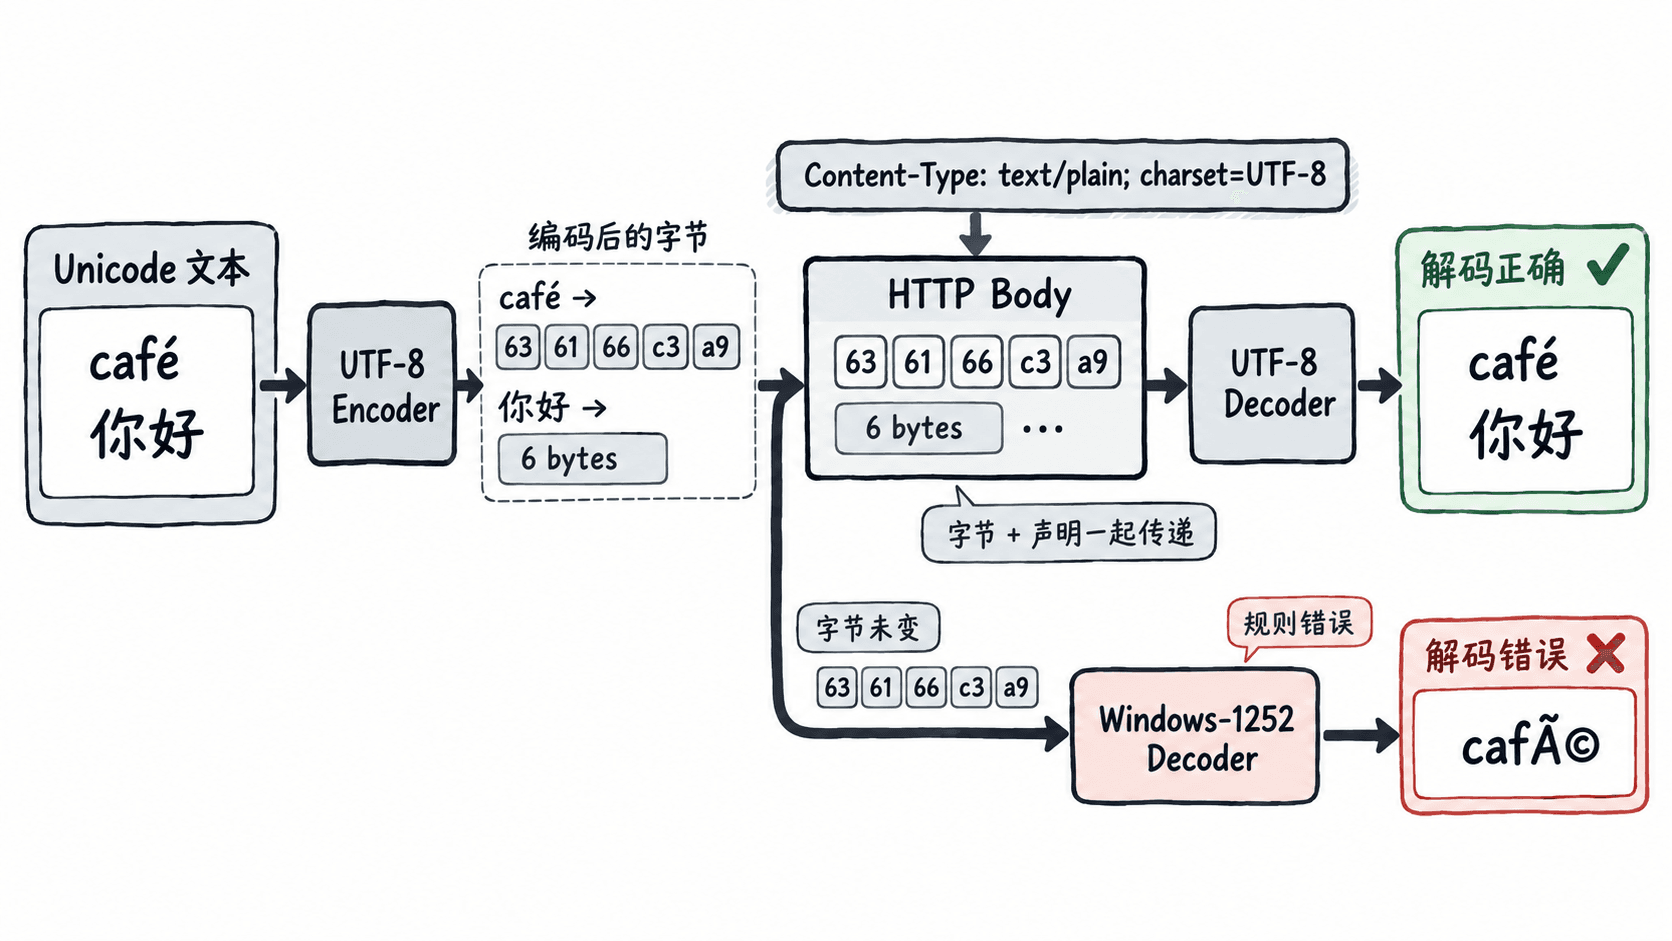
字符在程序内部是抽象文本,发到网络前必须编码成字节。以 café 为例,UTF-8 中 é 编码为十六进制 c3 a9,整个字符串是 63 61 66 c3 a9。同一组字节只要用相同编码解码,就能得到原文。
python3 -c 's="café"; b=s.encode("utf-8"); print(b.hex()); print(b.decode("utf-8"))'预期输出:
636166c3a9
café
UTF-8 是变长编码:ASCII 字符通常占 1 字节,常见汉字通常占 3 字节。例如 你好 有 2 个字符,但 UTF-8 消息体占 6 字节,因此不能用“字符数”手工填写 Content-Length;实际项目应让 HTTP 框架根据最终字节自动计算。
charset 在 HTTP 中放哪里
对允许 charset 参数的文本媒体类型,响应应把实际编码写进 Content-Type。下面表示消息体按 UTF-8 编码:
HTTP/1.1 200 OK
Content-Type: text/plain; charset=UTF-8

你好
JSON 是一个重要边界:开放系统间传输的 JSON 文本应使用 UTF-8,application/json 本身没有定义 charset 参数。通常直接发送 Content-Type: application/json 并确保实际字节是 UTF-8,比额外依赖 charset 更兼容。
请求体同样遵守这一规则:Content-Type 描述当前消息体的格式和可用参数,而不是客户端想要的响应格式。现代 HTTP 中 Accept-Charset 已被弃用,不应把它当作解决乱码的常规手段。
用错误解码复现乱码
最常见的乱码并不是网络把字节“改坏了”,而是接收端选错了解码器。把 UTF-8 的 café 字节按 Windows-1252 解码,会得到典型的 café;再按 UTF-8 解码则恢复正常。
python3 -c 'b="café".encode("utf-8"); print(b.decode("cp1252")); print(b.decode("utf-8"))'预期输出:
café
café
看到 é、ñ 一类模式时,优先怀疑 UTF-8 字节被当成 Windows-1252 或近似单字节编码解释。看到 � 则说明解码器遇到了无法按当前编码解释的字节并使用替换字符,排查重点应转向实际字节是否完整以及声明编码是否正确。
按字节链路排查乱码
排查不要先改页面字体,因为字体缺字与编码错误是两类问题。按“生产字节 → HTTP 声明 → 接收端解码”逐段确认,能最快定位责任点。
- 在发送端确认真实编码。Java 可使用
StandardCharsets.UTF_8,Python 可显式.encode("utf-8");不要依赖不明确的平台默认编码。 - 检查响应
Content-Type。普通文本或 HTML 需要确保charset与实际字节一致;JSON 则确认消息体本身是 UTF-8。 - 保存原始响应字节后再解码,避免浏览器或编辑器先替你“猜编码”。如果同一份字节用 UTF-8 能还原、用其他编码出现乱码,问题就在解码选择。
- 检查是否发生二次转码。例如已经是 UTF-8 字节,却先按 Windows-1252 解成错误字符串,再重新编码为 UTF-8,会把乱码固化,之后只改响应头无法恢复原文。
Accept 与字符编码不要混为一谈:Accept 主要协商媒体类型,而文本最终怎样从字节还原,取决于媒体类型规则、Content-Type 中适用的 charset 参数以及实际传输的字节是否一致。