
计算机网络 / 系统课时
区分 HTTP 与 TCP
区分 HTTP 与 TCP
HTTP 和 TCP 经常同时出现在抓包、日志和网络配置里,但它们解决的是不同问题。HTTP 规定客户端与服务器如何表达请求和响应,TCP 负责在两个端点之间可靠、有序地传输字节。把这两层分清后,才能正确理解连接失败、HTTP 状态码和连接复用分别属于哪一层。
学习目标
- 能说清 HTTP 与 TCP 的职责边界,不把 HTTP 状态码当成 TCP 状态。
- 能解释 HTTP/1.1、HTTP/2 为什么通常运行在 TCP 之上,以及连接如何被多个请求复用。
- 能识别 HTTP/3 使用 QUIC 而不是 TCP,避免把“HTTP 一定基于 TCP”当成绝对规则。
TCP 负责把字节可靠送到另一端
TCP 工作在传输层。客户端连接服务器时,需要目标 IP 和端口,例如访问传统 HTTPS 服务通常连接服务器的 TCP 443 端口。TCP 负责建立连接、按序交付字节、检测丢失并重传,但它并不知道这些字节代表 GET /、JSON、HTML 还是图片数据。
一个实用判断是:如果程序报 Connection refused、连接超时或连接被重置,通常还没有得到有效的 HTTP 响应;如果已经收到 404、401、500 等状态码,则底层传输至少已经成功把一份 HTTP 响应送回客户端。
| 现象 | 更接近哪一层 | 典型含义 |
|---|---|---|
| TCP 连接超时 | TCP/网络 | 无法及时建立到目标 IP:端口的连接 |
| Connection refused | TCP | 目标可达,但对应端口没有接受连接 |
| HTTP 404 | HTTP | 已收到服务器响应,但请求资源不存在 |
| HTTP 500 | HTTP | 已收到服务器响应,服务端处理请求时出错 |
HTTP 在连接上定义消息语义
HTTP 关注的是应用层消息。以 HTTP/1.1 为例,客户端可以在已经建立的 TCP 连接中发送 GET / HTTP/1.1 和请求头,服务器再返回 HTTP/1.1 200 OK、响应头和响应体。TCP 只负责传输这些字节,并不会解释 GET 或 200 的含义。
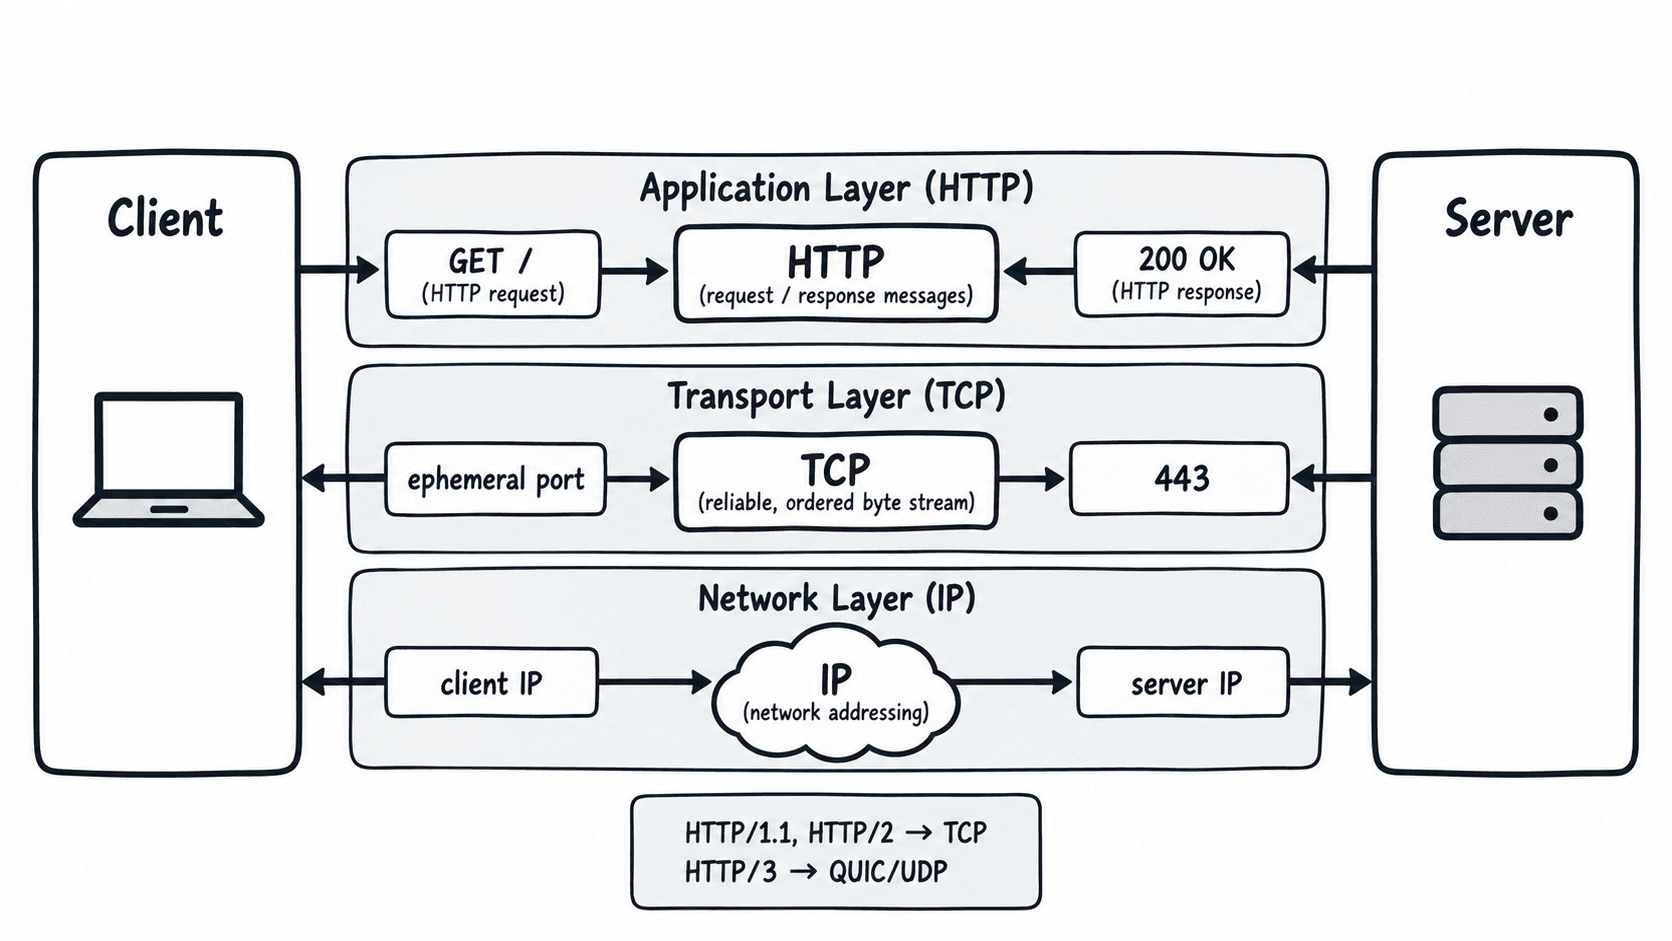
可以用 curl 的详细输出同时观察连接阶段和 HTTP 阶段:
curl --http1.1 -v https://example.com/ -o /dev/null预期结果中会先看到连接建立信息,再看到 HTTP 请求行和响应状态行;实际 IP、时间及部分 TLS 日志可能不同:
* Connected to example.com (<IP>) port 443
> GET / HTTP/1.1
< HTTP/1.1 200 OK
这里的 Connected 属于底层连接信息,而 GET 和 200 OK 属于 HTTP。排查日志时把这两类信息分开,可以避免在 TCP 尚未建立时去分析 HTTP 路由,也可以避免收到 404 后继续怀疑网络端口不通。
一个 TCP 连接可以承载多个 HTTP 请求
TCP 连接和 HTTP 请求并不是一一对应。HTTP/1.1 默认可以保持连接,在同一个 TCP 连接上连续发送多个请求;HTTP/2 更进一步,可以在一条 TCP 连接中并发复用多个逻辑流。假设页面要加载 HTML、CSS 和 8 张图片,共 10 个资源,并不意味着浏览器必须建立 10 条 TCP 连接。
在浏览器开发者工具的 Network 面板中,可以观察连接复用情况。以 Chromium 系浏览器为例,可在请求表头区域右键启用 Connection ID 或相关连接列;多个请求若使用相同连接标识,说明它们共享了底层连接。具体可见列会随浏览器版本变化,但判断标准始终是“请求数量”和“底层连接数量”不能直接画等号。
HTTP 不等于永远运行在 TCP 上
学习 HTTP/1.1 和 HTTP/2 时,说“HTTP 使用 TCP”在限定版本后是正确的;但不能把它扩展成所有 HTTP 版本的永久规则。HTTP/3 使用 QUIC,QUIC 运行在 UDP 之上,并在用户态提供可靠传输、多路复用和加密等能力,因此 HTTP/3 不再建立传统 TCP 连接。
实际分析协议时先看版本:看到 HTTP/1.1 或 h2,重点关注 TCP;看到 h3,应转而检查 QUIC 和 UDP。这样既能保留初学阶段清晰的分层模型,也不会在后续接触 HTTP/3 时产生“为什么抓不到 TCP 连接”的错误预期。