
计算机网络 / 系统课时
使用 GET 获取资源
使用 GET 获取资源
GET 用来请求服务器提供的资源表示,最常见的是读取详情、列表和搜索结果。本节会用真实请求理解查询参数、安全性、幂等性与缓存,并区分“重复发送 GET”与“响应内容一定不变”这两个容易混淆的概念。
学习目标
- 能使用 GET 和查询参数读取资源,并验证服务器实际收到的参数。
- 能解释 GET 的安全、幂等语义,以及它们不代表响应内容永远相同。
- 能根据缓存响应头判断浏览器或代理是否可以复用已有响应。
把筛选条件放在 URL 中
GET 通常把筛选、分页、排序等参数放在查询字符串中。例如资源集合 /articles 可以通过 limit=20、page=2 表达读取范围。查询参数会成为 URL 的一部分,因此不要把密码、访问令牌等敏感数据直接放进去,它们可能出现在浏览器历史、代理日志或服务器日志中。
下面的命令请求 httpbin,并只打印服务器解析后的查询参数。示例适用于安装了 curl 与 Python 3 的 Bash 环境。
curl -s "https://httpbin.org/get?limit=2&status=published" | python -c "import sys,json; print(json.dumps(json.load(sys.stdin)['args'], sort_keys=True))"预期输出:
{"limit": "2", "status": "published"}接口设计中建议把资源身份放在路径,例如 GET /articles/42,把过滤条件放在查询参数,例如 GET /articles?status=published&page=2。GET 请求体没有通用定义的语义,一些服务器、代理或框架可能忽略或拒绝它,因此不要依赖 GET 请求体传递查询条件。
理解安全、幂等与重复请求
HTTP 语义中,GET 是安全方法:客户端请求的目的只是读取信息,不应要求服务器因为这次请求而修改资源状态。服务器仍然可以记录访问日志、统计浏览量等附带行为,这并不会把 GET 变成“更新接口”。
GET 同时具有幂等语义:连续发送一次或多次相同 GET,请求本身对服务器资源产生的预期效果相同。但幂等不等于每次响应都相同。例如 GET /weather 在 10:00 与 10:05 可以返回不同温度,GET /articles?page=1 也可能因为新文章发布而返回不同列表。
可以用下面的检查标准审查接口:读取用户 42 应设计为 GET /users/42;把“删除用户”做成 GET /users/42/delete 则违反安全语义,因为爬虫、链接预取或缓存系统都可能自动发出 GET。
GET 为什么经常能够缓存
GET 响应可以被缓存,但是否真正缓存取决于响应头和缓存策略,而不是“只要是 GET 就一定缓存”。常见控制字段包括 Cache-Control、ETag 和 Last-Modified。例如 Cache-Control: max-age=60 表示响应在通常情况下可保持新鲜 60 秒;过期后客户端可以携带 If-None-Match 与服务器保存的 ETag 做条件请求。
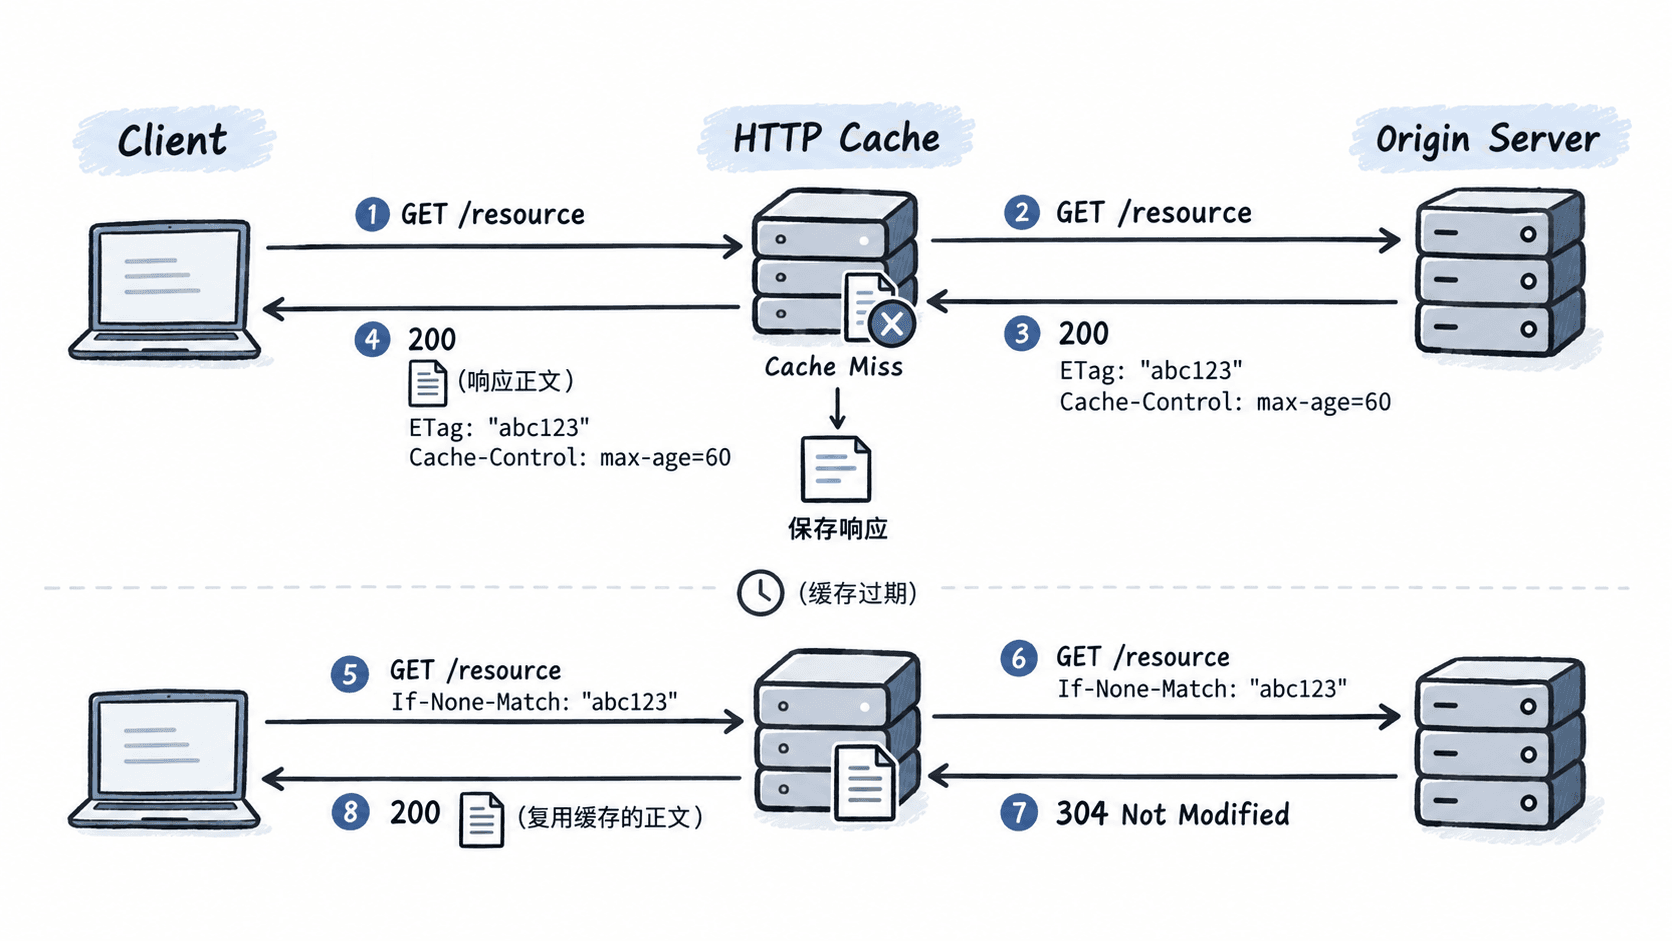
收到 304 Not Modified 时,服务器通常不重新发送完整资源正文,客户端继续使用已有缓存副本。如果接口返回用户私有数据,应结合业务要求设置 Cache-Control: private 或 no-store 等策略,不能仅凭 GET 方法判断数据是否适合共享缓存。