
Redis 与缓存 / 系统课时
理解 Redis 持久化目标
理解 Redis 持久化目标
本课先回答三个问题:要防止哪类数据丢失、最多允许丢多少、故障后多久恢复。明确这些目标后,才能正确组合持久化、副本切换与独立备份,而不是只开启某个配置项。
学习目标
- 识别进程、主机、磁盘和误操作等不同故障范围
- 使用 RPO 与 RTO 描述可验证的恢复目标
- 区分持久化、高可用和备份的职责
先识别故障范围
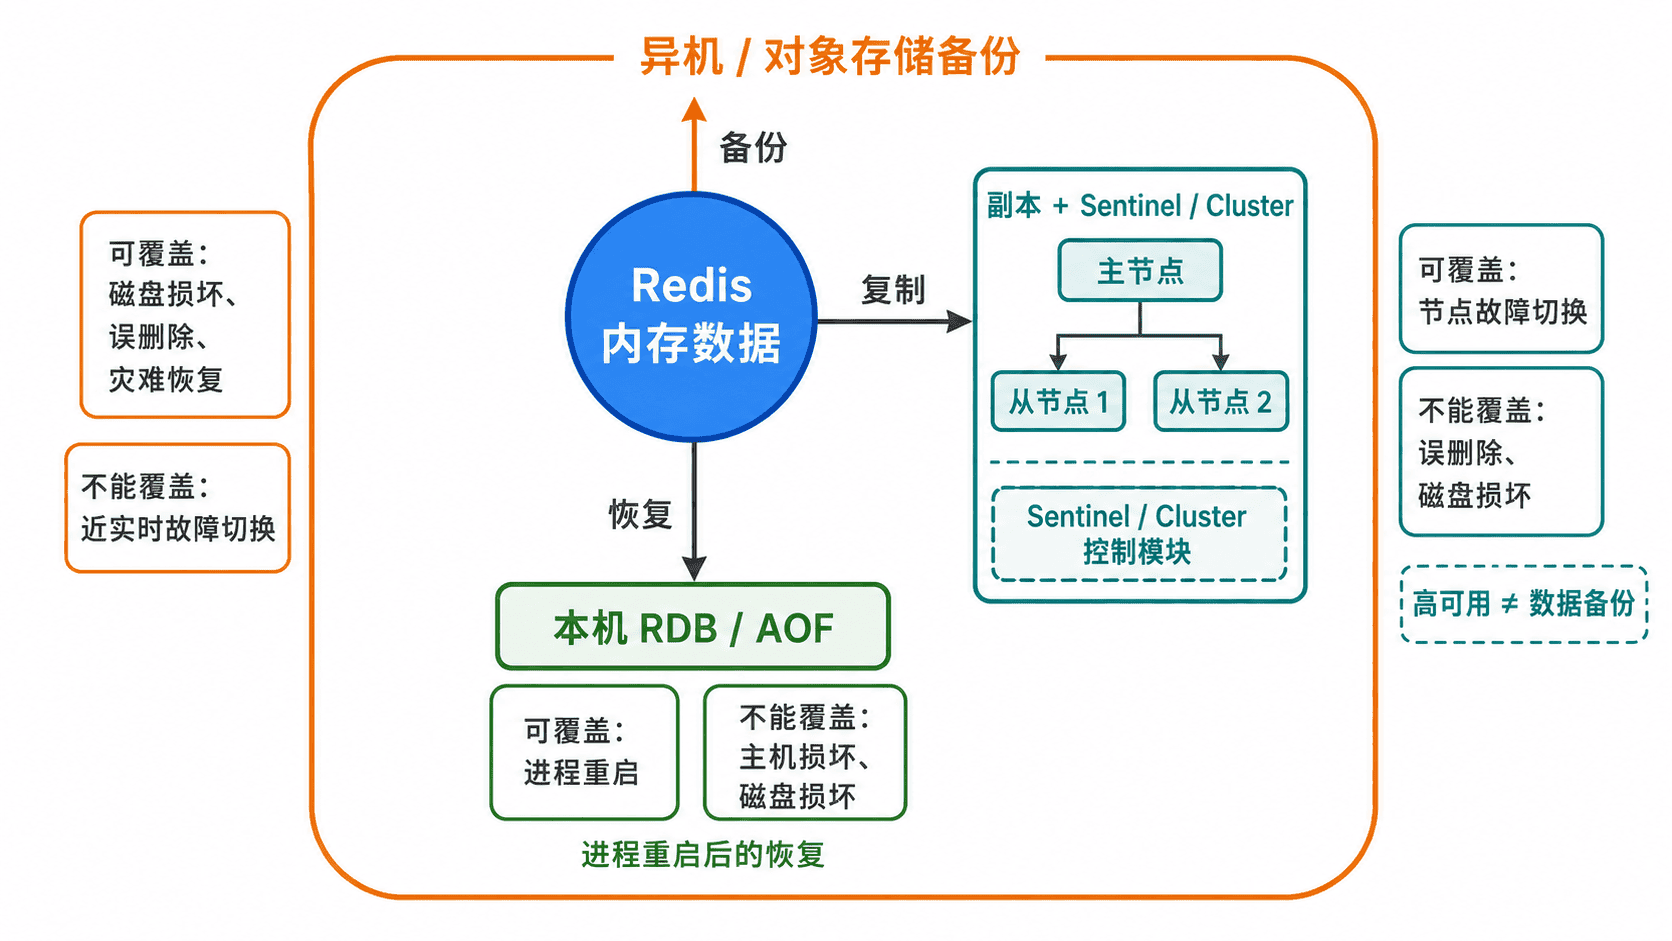
Redis 主要在内存中处理数据。未启用持久化时,进程退出或服务器重启会导致内存数据消失;启用本地持久化后,仍无法单独覆盖磁盘损坏、整机丢失、误删除或机房级故障。
故障范围不同,保护手段也不同。本机 RDB 或 AOF 主要用于重启恢复,副本与自动切换用于缩短节点故障停机,独立备份则用于回到较早且未受误操作影响的恢复点。
用 RPO 描述可丢数据量
RPO 是恢复点目标,表示故障后最多允许丢失多长时间的数据。例如 RPO 为 5 分钟,意味着恢复到最近有效持久化点时,业务可以接受最近不超过 5 分钟的写入缺失。
RPO 越小,通常需要更频繁的快照、更及时的 AOF 同步或更严格的复制确认,也会增加磁盘、网络和运维成本。设定目标时应同时考虑数据能否从数据库、消息系统或上游业务重新构建。
用 RTO 描述恢复时间
RTO 是恢复时间目标,表示从故障发生到服务恢复可用的最长时间。故障检测、主从切换、文件传输、数据加载、应用检查和人工审批都会占用 RTO。
高可用切换可以缩短停机时间,却不能保证新主节点与故障前完全一致。因此,RTO 与 RPO 必须分别设定和验证,不能用“切换很快”代替数据完整性评估。
区分三类保护能力
持久化把数据写入本地文件,用于进程重启后的加载;高可用通过副本和自动切换减少服务中断;备份保存独立时间点副本,用于磁盘损坏、误删除和灾难恢复。
复制会同步正确写入,也可能同步误删除,因此副本不是备份。可靠方案通常同时包含本地持久化、异机副本和独立备份,并通过恢复演练确认每一层都真正可用。
根据业务设定目标
可由数据库重建的缓存可以接受较大的 RPO,甚至不启用持久化,但必须验证集中回源时的数据库压力。会话、计数、队列或状态数据若难以重建,则应设置更小的 RPO,并准备明确的恢复步骤。
目标应写成可测试的数字,例如“最多丢失 1 分钟数据,10 分钟内恢复”,而不是“尽量不丢”。后续配置、监控和演练都应围绕这些数字验收。