
Redis 与缓存 / 系统课时
控制内存碎片
控制内存碎片
Redis 删除了数据,不代表进程 RSS 会立刻等量下降。本篇从 INFO memory 的几个关键指标出发,区分真正的分配器碎片、尚未归还操作系统的页,以及后台重写产生的临时 RSS 放大,并给出安全的处理顺序。
学习目标
- 读懂
mem_fragmentation_ratio、allocator_frag_ratio与allocator_rss_ratio - 区分删除后的碎片、分配器保留页和后台重写的 Copy-on-Write 开销
- 使用主动碎片整理和
MEMORY PURGE时知道各自解决什么问题
先把碎片拆成几层看
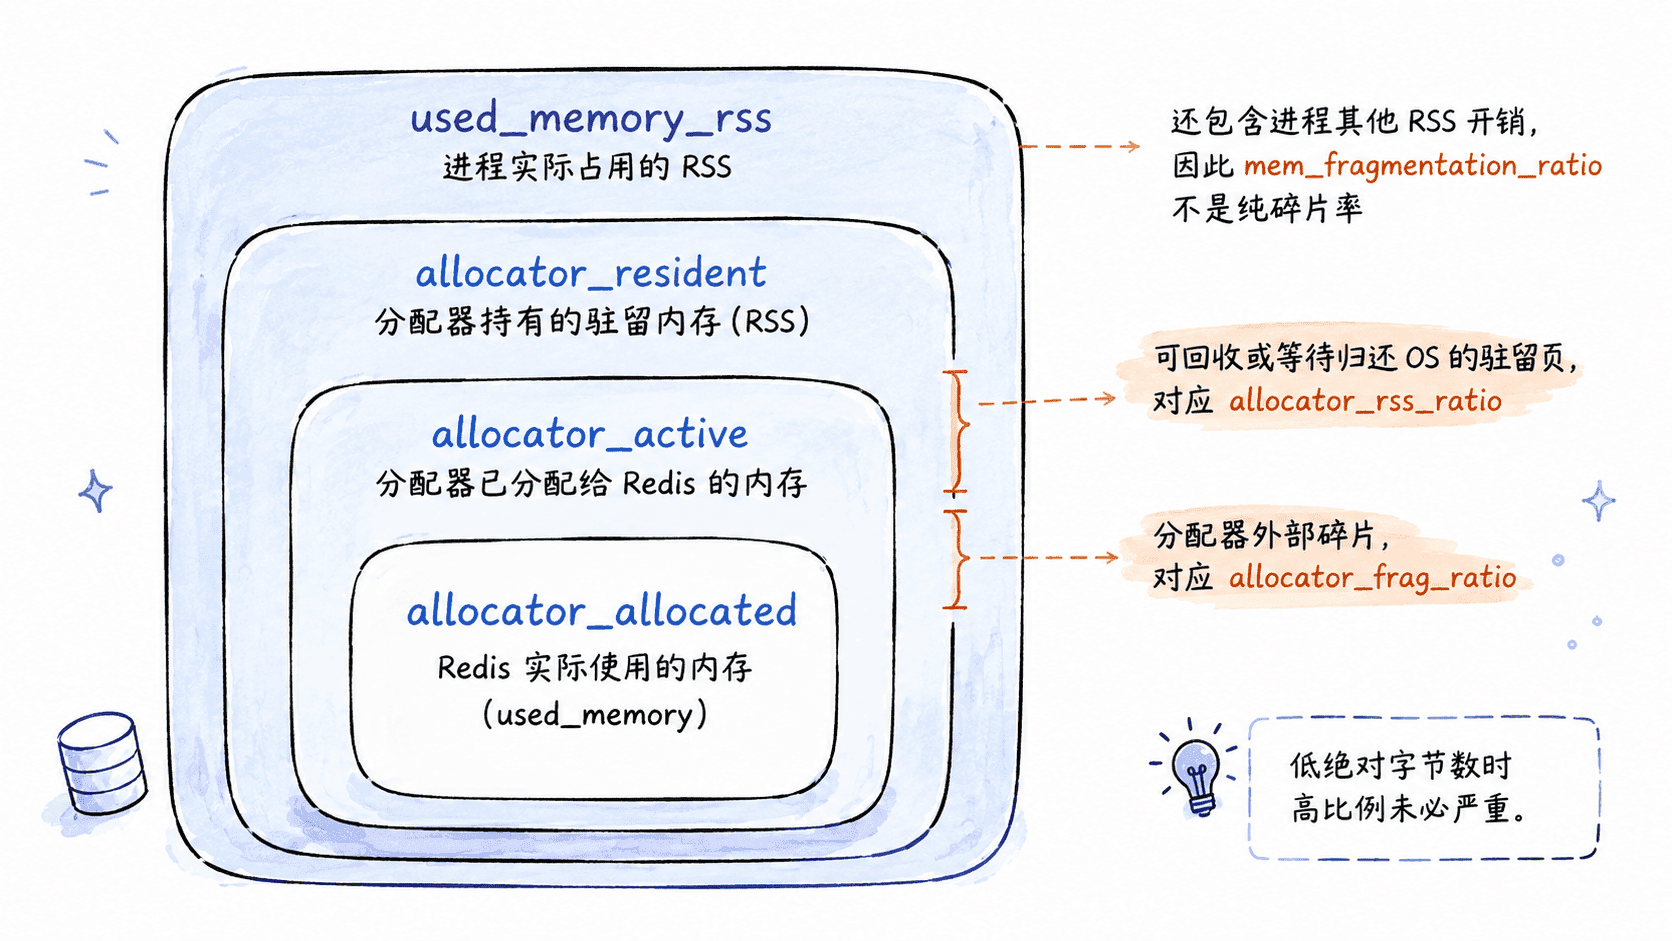
used_memory 接近 Redis 认为自己正在使用的内存,而 used_memory_rss 是操作系统看到的进程常驻集。mem_fragmentation_ratio 大致反映两者比例,但它还混入代码、栈、共享库等进程开销,所以不能把它直接等同于“纯碎片率”。
更精确地看分配器时,allocator_frag_ratio 对比 allocator_active 与 allocator_allocated,更接近外部碎片;allocator_rss_ratio 对比 allocator_resident 与 allocator_active,更适合判断分配器已经不用、但仍驻留在 RSS 中的页。
用 INFO memory 建立基线
先同时看比例和绝对字节数,不要只盯一个 ratio。下面的命令适合在 Linux/macOS 终端快速筛出关键字段:
redis-cli -h <HOST> -p <PORT> INFO memory | grep -E '^(used_memory|used_memory_rss|used_memory_peak|mem_fragmentation_ratio|mem_fragmentation_bytes|allocator_frag_ratio|allocator_frag_bytes|allocator_rss_ratio|allocator_rss_bytes|active_defrag_running):'预期输出:
used_memory:<VALUE>
used_memory_rss:<VALUE>
used_memory_peak:<VALUE>
mem_fragmentation_ratio:<VALUE>
mem_fragmentation_bytes:<VALUE>
allocator_frag_ratio:<VALUE>
allocator_frag_bytes:<VALUE>
allocator_rss_ratio:<VALUE>
allocator_rss_bytes:<VALUE>
active_defrag_running:<VALUE>
实际值会随数据集和负载变化。若数据集很小,几十 MB 的固定进程开销就可能让比例显得很高,因此判断时要同时看 mem_fragmentation_bytes 和 allocator_frag_bytes,并连续观察趋势。
删除和重写为何会让 RSS 看起来偏高
大量 TTL 过期、删除键、反复把对象从大值改成小值,会形成频繁的申请与释放。Redis 把内存交还给分配器后,分配器未必能立即把整页归还操作系统,于是 used_memory 已下降,而 RSS 仍保持较高。
另一方面,BGSAVE 或 BGREWRITEAOF 会 fork 子进程。后台任务期间主进程继续写数据时,Copy-on-Write 可能复制被修改的内存页,造成临时 RSS 放大。这不是同一类碎片问题。若异常只在持久化重写窗口出现,应同时检查持久化状态和写入速率,避免误把 COW 峰值当作长期碎片。
选择主动整理还是回收驻留页
如果 allocator_frag_bytes 持续较大,并且实例使用支持主动整理的分配器,可以开启 activedefrag。它会用额外 CPU 搬迁对象以降低碎片,因此应先在低峰期评估,再观察 CPU 和延迟变化。
redis-cli -h <HOST> -p <PORT> CONFIG SET activedefrag yes
redis-cli -h <HOST> -p <PORT> --raw CONFIG GET activedefrag
redis-cli -h <HOST> -p <PORT> --raw INFO memory | grep '^active_defrag_running:'
预期输出:
OK
activedefrag
yes
active_defrag_running:<VALUE>
active_defrag_running 为 0 时只表示当前没有在执行整理,并不代表配置未生效。运行时 CONFIG SET 是否会持久化取决于你的配置管理方式;生产环境应把最终配置纳入受控的 redis.conf 或部署配置,而不是只依赖一次在线修改。
如果主要问题是 allocator_resident 明显高于 allocator_active,可以在受控窗口尝试让分配器主动清理可归还页:
redis-cli -h <HOST> -p <PORT> MEMORY PURGE预期输出:
OKMEMORY PURGE 不是“整理所有碎片”的万能命令,它更偏向促使分配器释放可释放的脏页;真正的外部碎片仍要看 allocator_frag_ratio 和 allocator_frag_bytes。
用趋势而不是单点验收
有效的内存治理应同时满足:业务数据量稳定时 allocator_frag_bytes 不再持续扩大,RSS 与 used_memory 的差距逐步回落,而且主动整理没有把 CPU 或尾延迟推到不可接受的水平。
如果高 RSS 与后台重写严格同步,就优先治理写入峰值、重写窗口和内存余量;如果删除后长期保持较高 allocator_frag_bytes,再考虑主动碎片整理。把“碎片”“驻留页”和“Copy-on-Write”分开判断,才能避免用错手段。