
Redis 与缓存 / 系统课时
排查内存持续增长
排查内存持续增长
Redis 内存持续上涨时,先不要直接重启或清库。正确做法是区分“数据真的变多”“过期没有按预期发生”“少量大键膨胀”“客户端缓冲区堆积”与“RSS 因碎片居高不下”,再针对证据修复。
学习目标
- 用
INFO、redis-cli --memkeys和CLIENT LIST建立内存证据链 - 区分键数量增长、大键、客户端缓冲区与内存碎片
- 完成修复后的趋势验证,避免只看某一个瞬时指标
先确认增长发生在哪里
先同时看 Redis 逻辑分配内存、进程 RSS 和键空间。used_memory 更接近 Redis 已分配的内存,used_memory_rss 是操作系统看到的常驻内存;两者走势不同,排查方向也不同。
redis-cli -h <HOST> -p <PORT> INFO memory
redis-cli -h <HOST> -p <PORT> INFO keyspace
预期输出
# Memory
used_memory:<BYTES>
used_memory_rss:<BYTES>
used_memory_peak:<BYTES>
mem_fragmentation_ratio:<RATIO>
allocator_frag_ratio:<RATIO>
allocator_frag_bytes:<BYTES>
maxmemory:<BYTES>
maxmemory_policy:<POLICY>
# Keyspace
db0:keys=<COUNT>,expires=<COUNT>,avg_ttl=<MILLISECONDS><BYTES>、<COUNT> 等实际值会随实例变化。如果 used_memory 与键数量同步上升,优先查业务写入和 TTL;如果键数基本稳定但 used_memory 上升,优先查大值、集合膨胀和客户端缓冲区;如果 used_memory 稳定而 RSS 长期明显更高,则继续看分配器与碎片指标。
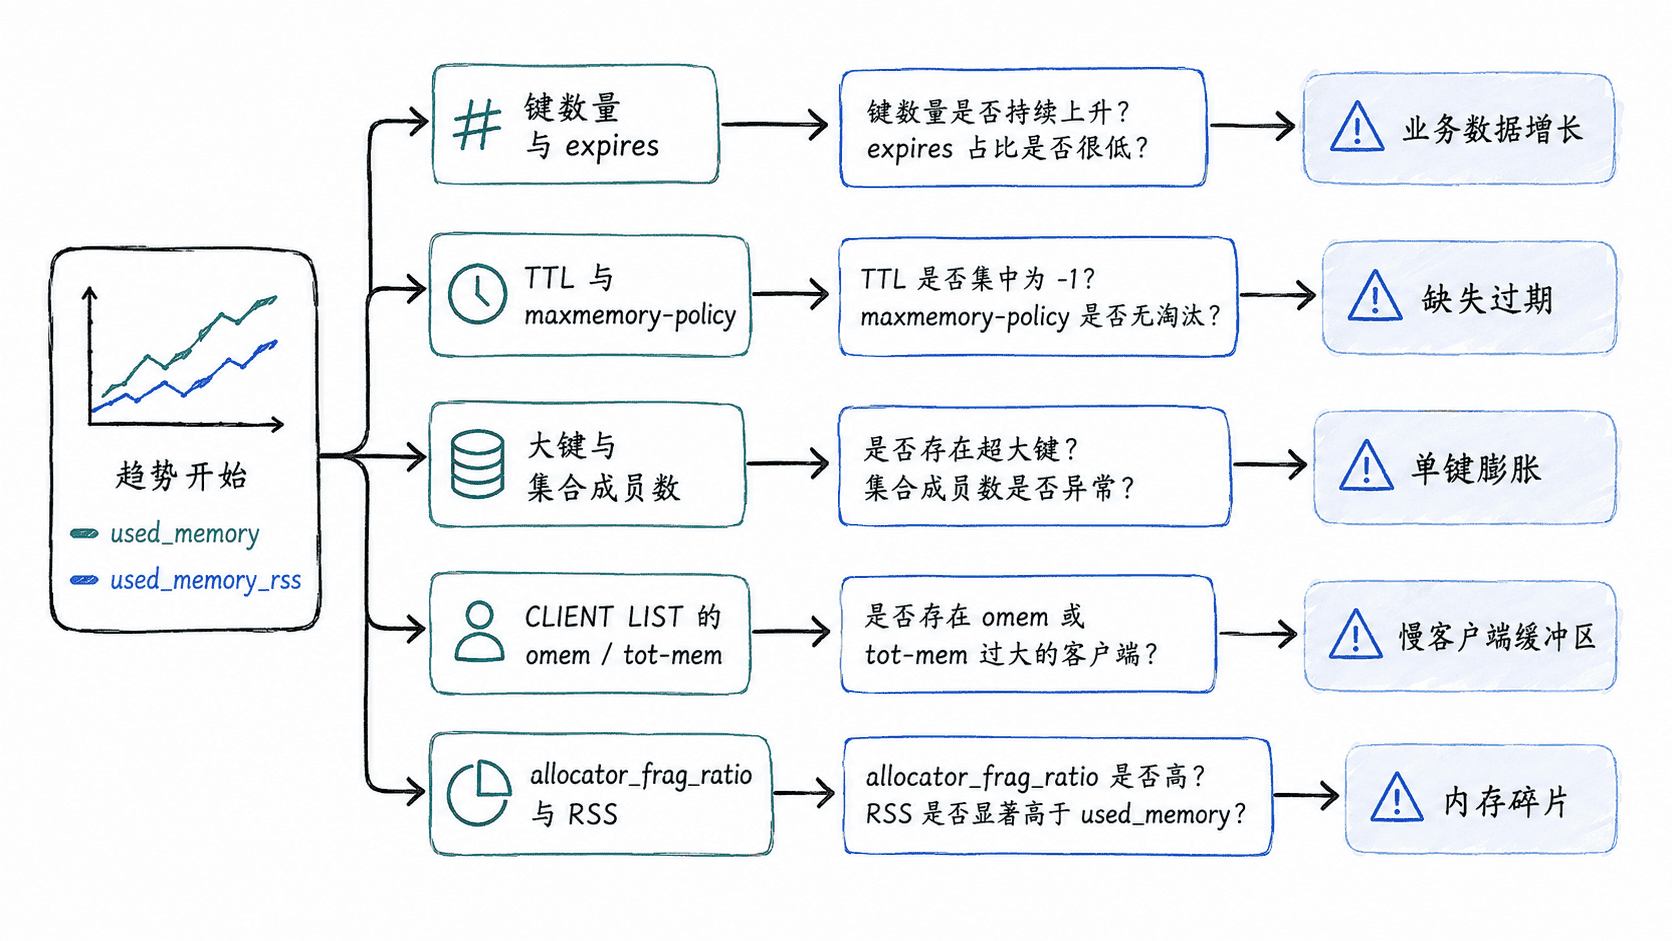
检查键数量与过期策略
INFO keyspace 中的 keys 是当前键数,expires 是设置了过期时间的键数。若业务明确要求缓存键都应过期,而 expires 长期明显少于对应键数,就要抽样检查 TTL <KEY>,确认是否出现永久键或写入时漏设 TTL。
同时检查 maxmemory 与 maxmemory-policy。maxmemory=0 在普通 64 位部署中表示没有 Redis 自身的内存上限;而 noeviction 到达上限后不会通过淘汰旧键释放空间。不要把“配置了 TTL”误认为“内存一定立刻下降”:过期删除和业务新增可能同时发生,应观察一段时间内键数、过期数和内存趋势。
找出大键与异常膨胀键
键数不变并不代表数据量不变。一个 Hash、List、Set、ZSet 或 Stream 可以在键名不变的情况下持续增加成员。可使用 --memkeys 通过扫描方式寻找内存占用较大的键;生产环境建议降低扫描速率,并优先在副本或低峰期执行。
redis-cli -h <HOST> -p <PORT> --memkeys -i 0.01预期输出
Keys sampled: <COUNT>
-------- summary -------
Biggest string found "<KEY>" has <BYTES> bytes
Biggest hash found "<KEY>" has <BYTES> bytes
...
发现候选键后,再用 MEMORY USAGE <KEY> SAMPLES 5 复核内存占用,并结合 HLEN、LLEN、SCARD、ZCARD、XLEN 等对应命令判断是值本身过大还是元素数量持续增长。不要在大数据集上用 KEYS * 做排查。
检查客户端缓冲区和碎片
当键空间解释不了增长时,执行 CLIENT LIST,重点关注 omem 和 tot-mem。某些消费者读取太慢、Pub/Sub 订阅端处理不及时或网络异常,会让服务端积压回复;如果少数连接的这些值持续变大,应先定位对应客户端,而不是删除业务数据。
碎片问题则看 allocator_frag_ratio、allocator_frag_bytes、used_memory_rss 与 used_memory_peak。如果业务曾出现内存高峰,随后 used_memory 已下降而 RSS 没有同步回落,可能是分配器尚未把页面归还给操作系统。此时应先确认趋势和可用内存压力,再评估 MEMORY PURGE、滚动重启或调整数据模型,不能仅凭一个 mem_fragmentation_ratio 数字下结论。
修复后至少重新采集同一组 INFO memory、INFO keyspace 和客户端指标,确认 used_memory、键数或异常客户端缓冲区停止持续上升。只有趋势被扭转,故障才算真正闭环。