
Redis 与缓存 / 系统课时
处理缓存穿透
处理缓存穿透
本课解决“查询不存在的数据却持续访问数据库”的问题。你将识别缓存穿透的典型表现,并组合参数校验、空值缓存和布隆过滤思想,减少没有业务价值的回源。
学习目标
- 区分缓存穿透与普通缓存未命中
- 使用空值缓存阻断重复无效查询
- 理解参数校验和布隆过滤的适用边界
什么是缓存穿透
缓存穿透发生在请求目标本来就不存在时。Redis 中没有对应键,每次请求都会继续访问数据库;请求量较大时,数据库会承受大量无法命中业务数据的查询。
它可能来自错误参数、过期链接、爬虫扫描或恶意构造。例如连续请求不存在的商品 ID,若应用对每个 ID 都查询数据库,就会形成稳定的回源压力。
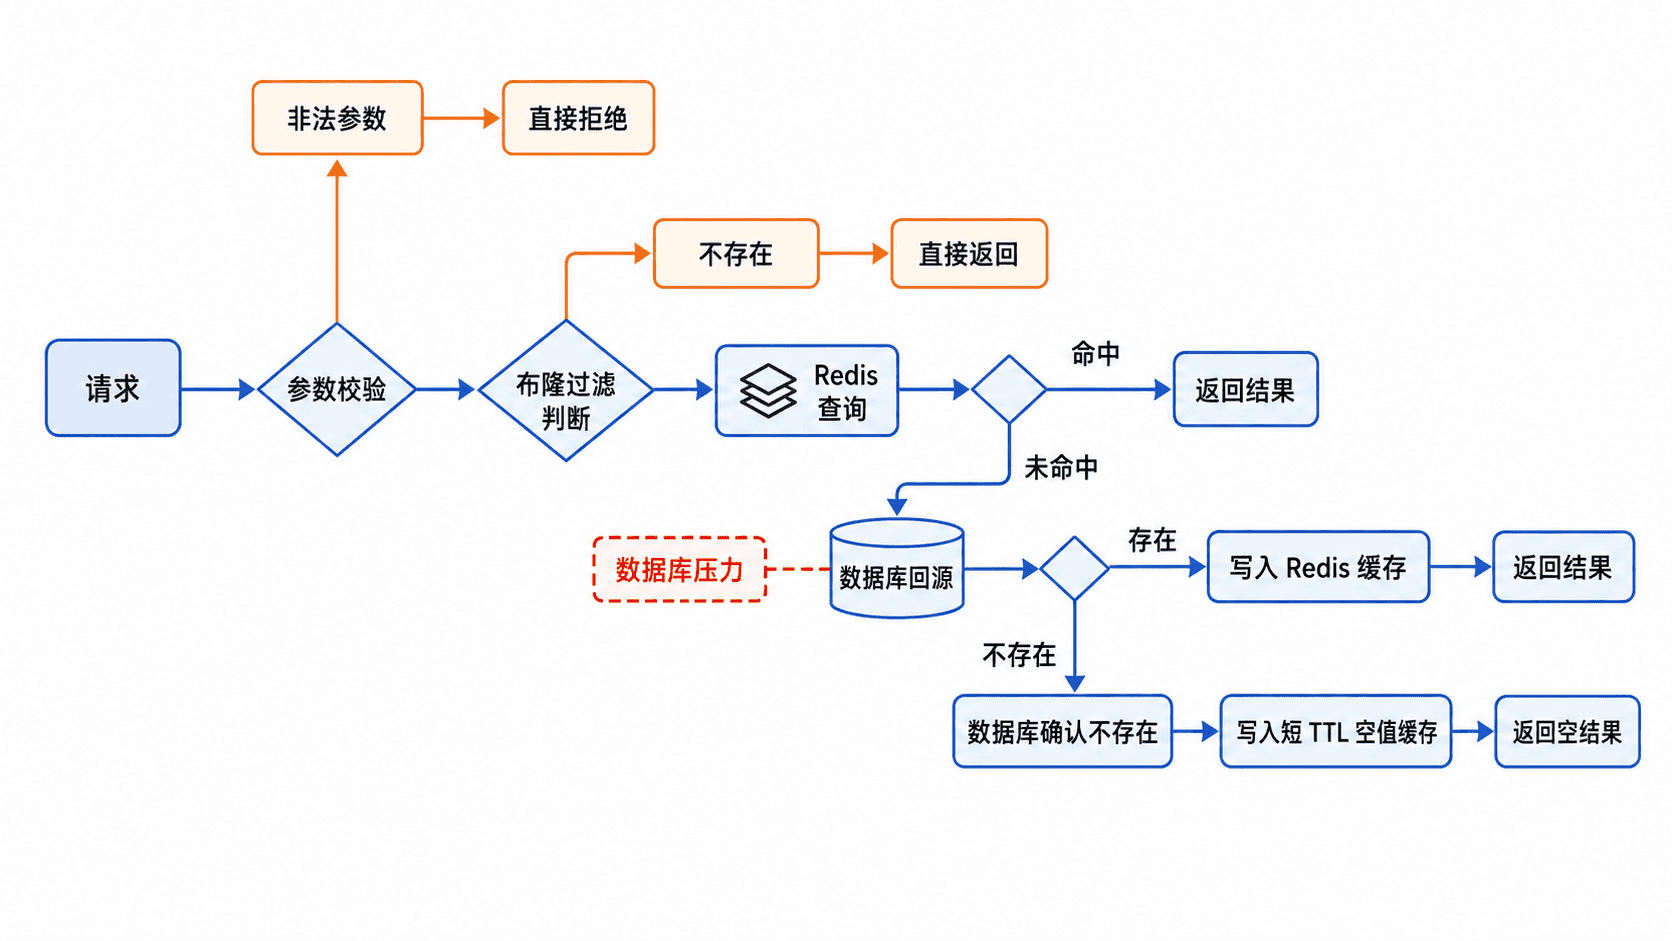
先做低成本拦截
最便宜的防护应放在最前面。应用可以校验 ID 类型、长度、取值范围和业务前缀,明显非法的请求无需访问 Redis,更不应进入数据库。
参数校验无法判断格式正确的 ID 是否真实存在,但可以过滤负数、越界值和随机字符串,因此应与后续策略组合使用。
使用短 TTL 空值缓存
数据库确认数据不存在后,可以在 Redis 中保存短 TTL 的空值标记。后续相同请求命中标记时直接返回不存在,避免反复查询数据库。
下面的可运行示例用字典模拟缓存和数据库,并统计回源次数。为简化演示,TTL 通过过期时间戳实现。
import time

NULL_MARKER = "__NULL__"
NULL_TTL_SECONDS = 60
database = {1001: {"id": 1001, "name": "Keyboard"}}
cache: dict[str, tuple[object, float]] = {}
db_query_count = 0

def cache_get(key: str) -> object | None:
    item = cache.get(key)
    if item is None:
        return None

    value, expires_at = item
    if expires_at <= time.time():
        cache.pop(key, None)
        return None
    return value

def get_product(product_id: int) -> dict | None:
    global db_query_count
    if product_id <= 0:
        raise ValueError("product_id must be positive")

    key = f"product:{product_id}"
    value = cache_get(key)
    if value == NULL_MARKER:
        return None
    if isinstance(value, dict):
        return value

    db_query_count += 1
    product = database.get(product_id)
    if product is None:
        cache[key] = (NULL_MARKER, time.time() + NULL_TTL_SECONDS)
        return None

    cache[key] = (product, time.time() + 300)
    return product

print(get_product(9999))
print(get_product(9999))
print(f"db queries: {db_query_count}")
预期输出:
None
None
db queries: 1
第一次查询不存在的商品会访问数据库并写入空值标记;60 秒内再次查询相同 ID 时直接返回。数据后来创建成功时,应主动删除对应空值键,避免新数据被旧标记暂时挡住。
布隆过滤的边界
布隆过滤器适合在访问数据库前判断“某个 ID 是否可能存在”。判断一定不存在时可以直接拒绝;判断可能存在时仍需继续查询,因为布隆过滤器可能产生假阳性。
它适合数据集合较大、随机无效请求较多的场景,但需要维护全量加载、增量更新和重建流程,不能替代数据库的最终判断。
组合防护
常见顺序是参数校验、布隆过滤判断、缓存查询、数据库回源,最后对不存在结果写入短 TTL 空值。对异常高频来源还应配合网关限流和监控告警。
防护重点不是让所有无效请求都进入 Redis,而是尽可能在更靠前、更便宜的层级结束请求。