
Redis 与缓存 / 系统课时
排查主从复制异常
排查主从复制异常
主从复制异常不要从“重启试试”开始,而要先确认复制链路是否仍连通、主从偏移量是否持续拉大,以及断线后为什么没能继续增量同步。完成本课后,你可以用 INFO replication 和积压缓冲区指标判断延迟、断链与全量同步的真正原因。
学习目标
- 根据复制状态和偏移量判断链路是否健康
- 判断复制积压缓冲区是否足以支撑部分重同步
- 按证据区分网络、配置与全量同步触发原因
先确认复制链路是否真的异常
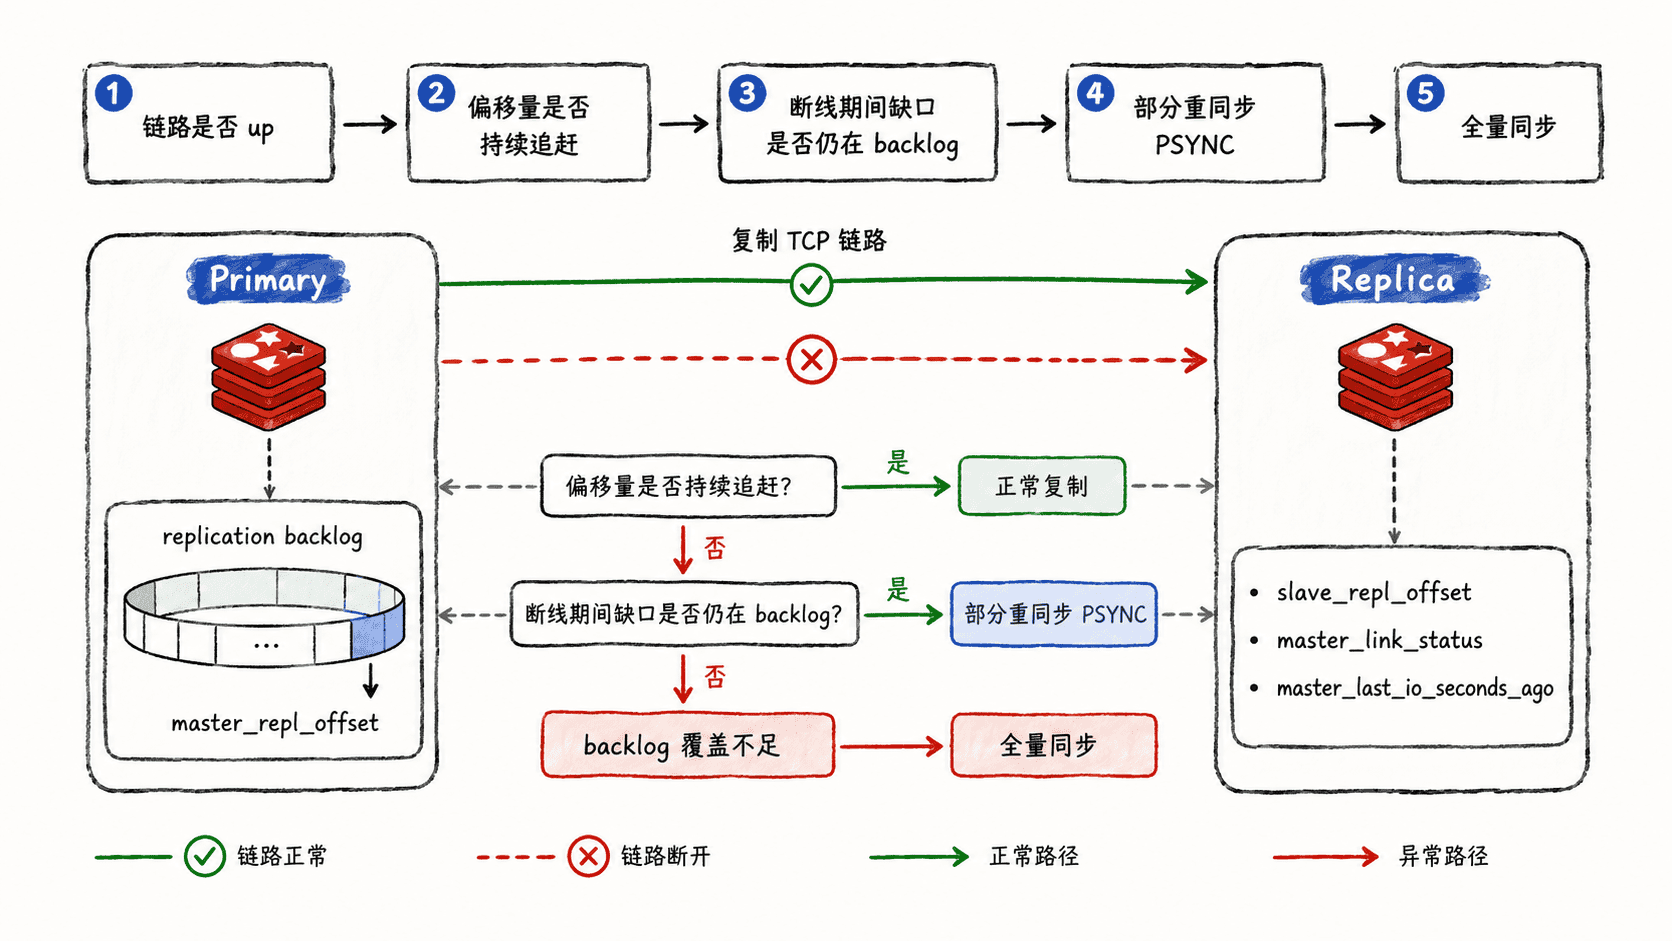
在副本节点执行 INFO replication,先看角色、上游地址、连接状态和最近一次收到主节点数据的时间。不要只盯着业务读延迟,因为副本可能仍在线,但复制流已经停住。
redis-cli -h <REPLICA_IP> -p <PORT> INFO replication预期输出(健康副本的关键字段,实际地址、偏移量和秒数会不同):
# Replication
role:slave
master_host:<PRIMARY_IP>
master_port:<PORT>
master_link_status:up
master_last_io_seconds_ago:<SECONDS>
master_sync_in_progress:0
slave_repl_offset:<OFFSET>
repl_backlog_active:1
repl_backlog_size:<BYTES>
repl_backlog_histlen:<BYTES>
master_link_status:down 说明复制连接已断;master_last_io_seconds_ago 持续增大,说明副本长时间没有收到主节点数据;master_sync_in_progress:1 表示正在执行同步,需继续观察同步是否完成,而不是立刻判定故障。
在主节点再执行同一命令,重点查看对应副本的 state、offset 和 lag。如果主节点的 master_repl_offset 持续增长,而某个副本的 offset 长时间不动,问题已经收敛到该副本或主从之间的网络路径。
用偏移量判断复制延迟
复制延迟本质上是“主节点已经产生的数据位置”和“副本已经应用到的位置”之间的差距。观察一次快照不够,应该间隔几秒重复检查:健康副本的 offset 会持续追赶主节点,而异常副本会停滞或差距不断扩大。
主节点 INFO replication 中的副本行通常类似 slave0:ip=...,port=...,state=online,offset=...,lag=...。lag 是主节点视角下的心跳延迟,不等同于业务数据落后量;判断数据复制是否真正落后,仍要结合 offset 的变化趋势。
检查积压缓冲区和全量同步原因
Redis 断线重连时会优先尝试部分重同步。主节点的 replication backlog 保存最近一段复制流;只要副本请求的旧 offset 仍在 backlog 覆盖范围内,并且复制 ID 能对应上,就可以继续增量发送。若断线太久导致缺口被覆盖,或者复制 ID 已不匹配,就会退化为全量同步。
可以在主节点检查积压缓冲区配置和当前占用:
redis-cli -h <PRIMARY_IP> -p <PORT> CONFIG GET repl-backlog-size
redis-cli -h <PRIMARY_IP> -p <PORT> INFO replication
预期输出中的关键部分:
1) "repl-backlog-size"
2) "<BYTES>"
repl_backlog_active:1
repl_backlog_size:<BYTES>
repl_backlog_first_byte_offset:<OFFSET>
repl_backlog_histlen:<BYTES>
如果副本断线期间主节点写入量很大,而 repl_backlog_size 太小,旧 offset 很快会被覆盖,重连后就更容易触发全量同步。此时应根据峰值写入速率和可接受断线窗口评估 backlog,而不是只因为看到一次全量同步就盲目扩大配置。
全量同步还可能由主节点重启、故障切换后复制 ID 变化、复制关系被重新配置等原因触发。判断时要结合最近的重启、故障转移和配置变更记录。
按根因修复并验证
如果副本指向了错误的主节点,可在确认目标无误后重新设置复制源:
redis-cli -h <REPLICA_IP> -p <PORT> REPLICAOF <PRIMARY_IP> <PORT>预期输出:
OK随后再次检查 INFO replication,确认 master_link_status:up,并观察副本 offset 是否持续增长。生产环境不要把 REPLICAOF 当成通用修复命令:网络不通、认证失败、主节点压力过高或 backlog 不足时,重新指向并不会消除根因。
如果链路仍为 down,继续检查主从端口、防火墙、TLS、ACL/认证和 Redis 日志;如果链路已恢复但频繁全量同步,则重点检查断线持续时间、写入速率与 backlog 容量。排障完成的标准不是“连接重新出现”,而是复制链路稳定、offset 能持续追赶,并且全量同步不再无故重复发生。