
Redis 与缓存 / 系统课时
排查 Redis 响应变慢
排查 Redis 响应变慢
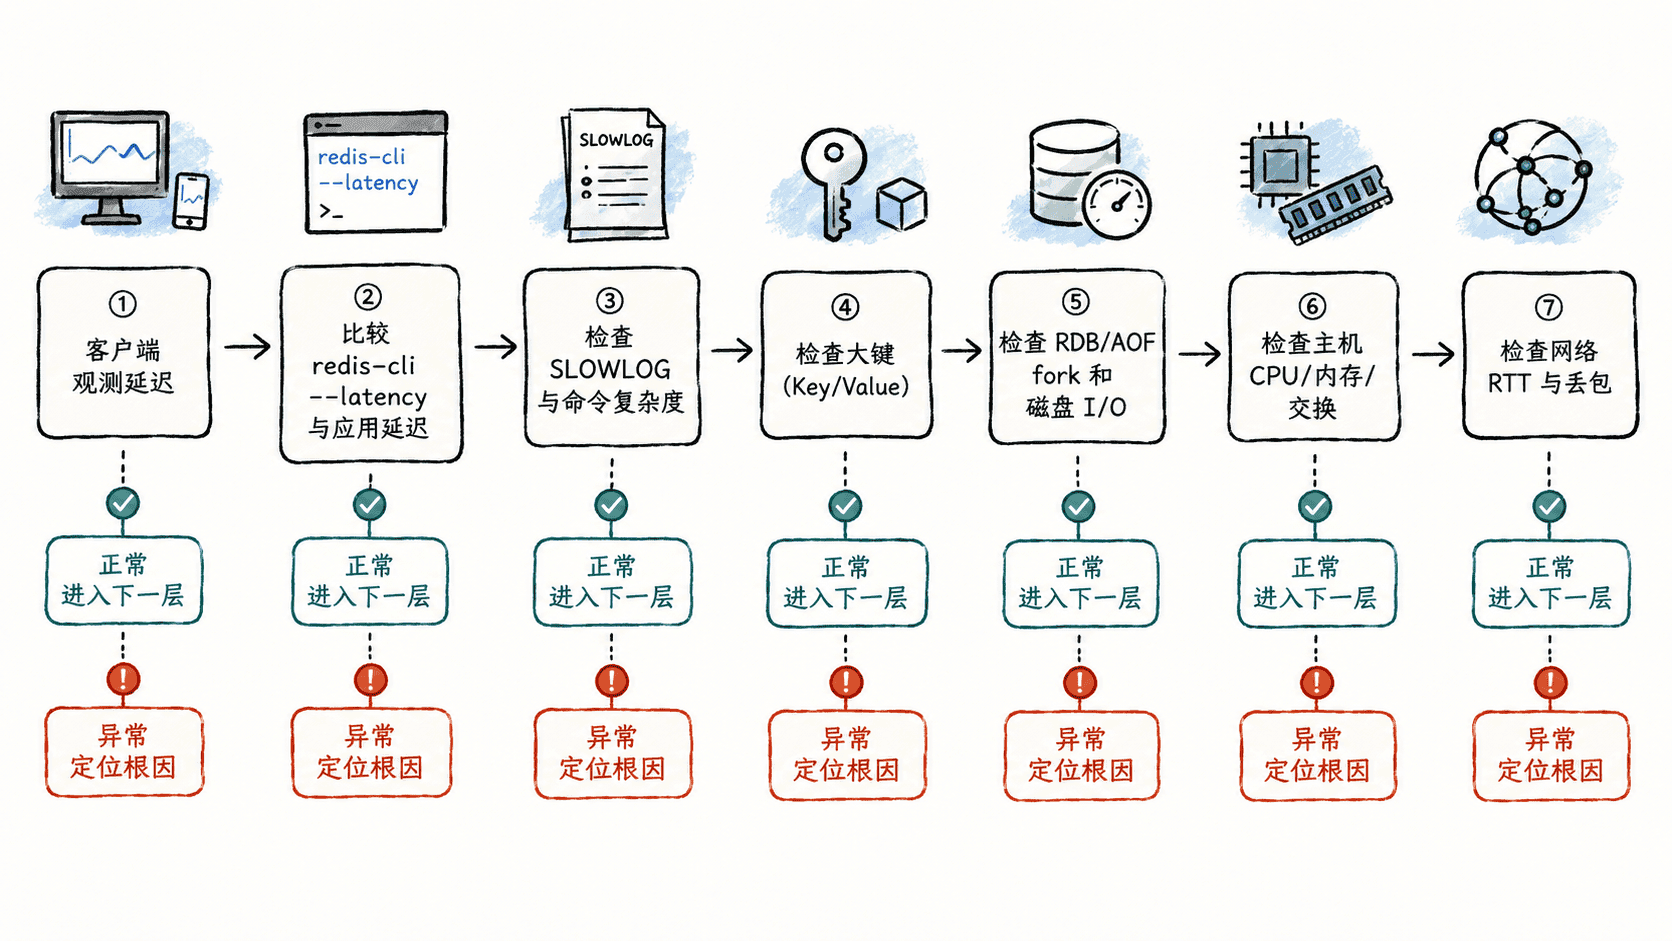
Redis 变慢不能只盯着 CPU。一次请求的延迟可能来自慢命令、大键操作、RDB/AOF 后台任务、主机资源争用,也可能发生在客户端与网络路径。排查时应先确定慢在哪里,再逐层缩小范围。
学习目标
- 区分 Redis 服务端执行变慢与客户端、网络延迟
- 用慢日志、延迟统计和持久化指标定位常见阻塞来源
- 按“命令、数据、持久化、系统、网络”的顺序完成验证闭环
先测出延迟属于哪一层
先从与业务相同网络位置测 Redis 往返延迟,再与应用侧耗时对照。redis-cli --latency 会持续发送 PING 并给出最小、最大和平均往返时间,适合判断当前链路是否已经明显抖动。
redis-cli -h <HOST> -p <PORT> --latency预期输出
min: <MS>, max: <MS>, avg: <MS> (<SAMPLES> samples)如果 CLI 延迟正常而应用仍慢,优先检查连接池、客户端线程池、序列化和应用自身排队;如果 CLI 同样变慢,再进入 Redis 服务端排查。测试点不同会包含不同网络路径,因此不要拿本机结果替代业务机器结果。
从慢命令和大键开始
慢日志记录的是命令在 Redis 内部执行所花的时间,不包含客户端网络传输,因此它是区分“服务端执行慢”和“链路慢”的关键证据。先查看最近记录,再把高耗时命令与对应键的数据规模关联起来。
redis-cli -h <HOST> -p <PORT> SLOWLOG GET 10预期输出
1) 1) (integer) <ID>
   2) (integer) <TIMESTAMP>
   3) (integer) <DURATION_US>
   4) 1) "<COMMAND>"
      2) "<ARGUMENT>"
   5) "<CLIENT_ADDRESS>"
   6) "<CLIENT_NAME>"
<DURATION_US> 是服务端执行耗时,实际输出由多条嵌套记录组成。若频繁看到 KEYS、对超大集合执行全量读取或复杂度随元素数量增长的命令,应先改访问方式;如果命令本身合理但只在某些键上变慢,再用 redis-cli --memkeys、MEMORY USAGE <KEY> 和对应集合长度命令确认是否存在大键。
INFO commandstats 和 INFO latencystats 还能从命令类型维度观察调用次数、平均 CPU 时间及延迟分位数。它们适合判断“某一类命令整体变慢”,而慢日志更适合追具体异常请求。
检查持久化与系统负载
如果慢日志没有明显异常,但延迟呈周期性尖峰,要把时间点与 INFO persistence、INFO stats 对齐。重点看是否正在执行 RDB 保存或 AOF 重写,以及延迟尖峰是否与 fork、磁盘写入压力同时出现。
RDB 和 AOF 的后台工作不等于一定会导致慢请求,但大数据集 fork、写时复制、磁盘抖动或频繁 fsync 都可能放大尾延迟。此时应继续看主机 CPU、内存可用量、磁盘延迟和是否发生 swap;如果 Redis 的 used_memory 明显高于 RSS,也要警惕内存被换出带来的严重延迟。
排除网络与客户端排队
当 SLOWLOG 显示命令执行很快,但业务端仍出现高延迟,问题通常不在命令执行阶段。检查客户端是否频繁新建连接、连接池是否耗尽、是否存在大量并发请求等待同一连接,以及应用主机本身是否 CPU 或内存紧张。
网络侧至少比较业务主机到 Redis 的 RTT、抖动和丢包。如果跨可用区、经过代理或服务网格,还要分别测各跳路径。大量小命令造成的往返次数也会累积延迟,可在语义允许时使用 pipelining 或批量命令减少网络往返,但不能用更大的单次操作换来新的阻塞。
用同一时间窗口完成验证
修复后不要只执行一次 PING。在与故障相近的负载和时间窗口内重新观察应用延迟、redis-cli --latency、慢日志、命令延迟分位数、持久化状态和主机资源。如果服务端执行时间恢复但应用仍慢,就继续沿客户端和网络排查;如果 Redis 内部延迟仍高,则回到异常命令、数据规模和系统资源证据。
最终应能回答两个问题:延迟主要发生在哪一层,以及哪项证据证明修复后该层恢复正常。只有这两个问题都有数据支撑,排障才算完成。