
Redis 与缓存 / 系统课时
排查集群状态异常
排查集群状态异常
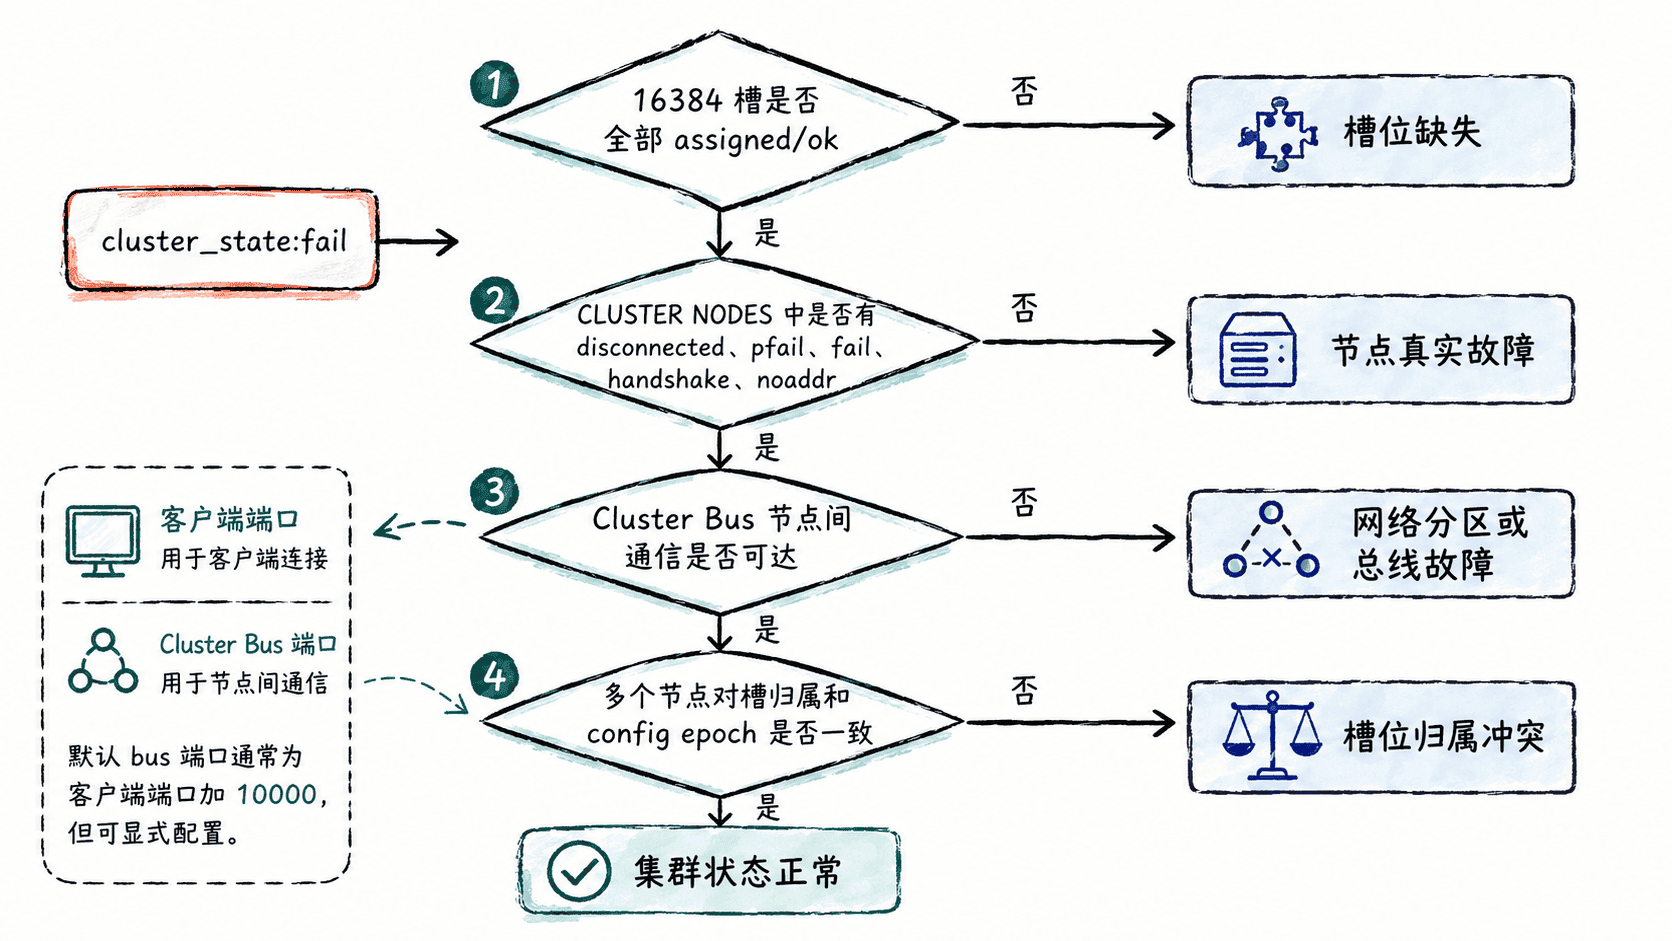
Redis Cluster 出现 cluster_state:fail 时,根因通常落在三类证据上:16384 个槽是否完整覆盖、节点之间的 Cluster Bus 是否正常通信,以及各节点对故障和槽归属的视图是否一致。本课给出一条从状态到槽位、通信和配置纪元的排查路径。
学习目标
- 用
CLUSTER INFO判断集群失败属于槽位还是节点故障 - 从
CLUSTER NODES识别通信异常、故障标记和槽位归属 - 理解配置纪元在冲突槽位归属中的作用并完成修复验证
从集群总状态开始收敛范围
先连接任意一个集群节点,查看集群状态和槽位统计。这个步骤只回答“集群为什么被判定为不可用”,不要一上来就执行修复命令。
redis-cli -c -h <IP> -p <PORT> CLUSTER INFO预期输出(健康集群的关键字段):
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
cluster_known_nodes:<NODES>
cluster_size:<PRIMARY_COUNT>
cluster_current_epoch:<EPOCH>
cluster_my_epoch:<EPOCH>
如果 cluster_slots_assigned 小于 16384,说明存在未分配槽;cluster_slots_pfail 大于 0 表示某些槽对应的主节点处于疑似故障;cluster_slots_fail 大于 0 则表示相关主节点已经被集群确认故障。即使 cluster_known_nodes 数量看起来正确,也不能说明槽位和通信一定健康。
用节点视图检查通信和故障标记
继续查看节点表。CLUSTER NODES 的每一行同时包含节点 ID、地址、角色/故障标记、主从关系、配置纪元、连接状态和槽位范围,是定位集群异常的核心证据。
redis-cli -h <IP> -p <PORT> CLUSTER NODES预期输出示意,节点 ID、地址、时间戳和纪元会因环境而异:
<NODE_ID_1> <IP_1>:<PORT_1>@<BUS_PORT_1> myself,master - <PING> <PONG> <EPOCH_1> connected 0-5460
<NODE_ID_2> <IP_2>:<PORT_2>@<BUS_PORT_2> master - <PING> <PONG> <EPOCH_2> connected 5461-10922
<NODE_ID_3> <IP_3>:<PORT_3>@<BUS_PORT_3> master - <PING> <PONG> <EPOCH_3> connected 10923-16383
优先关注 disconnected、pfail、fail、handshake、noaddr 等状态。pfail 是当前节点的主观疑似故障;当满足集群的故障确认条件后,才会传播为 fail。因此单个节点看到 pfail 时,应从多个主节点重复执行 CLUSTER NODES,确认是否只有局部节点失联。
Cluster Bus 用于节点间 gossip、故障检测和配置传播,它不是客户端普通读写链路。只验证客户端端口可达仍可能漏掉总线端口故障;防火墙、容器端口映射或跨网段策略错误都可能导致客户端能连节点,但节点彼此无法正常组成集群。
检查槽位覆盖和配置纪元
Redis Cluster 要求 0 到 16383 共 16384 个槽都有明确归属。可以让 redis-cli 的集群管理器做只读检查:
redis-cli --cluster check <IP>:<PORT>预期输出(健康集群的关键结论):
[OK] All nodes agree about slots configuration.
[OK] All 16384 slots covered.
如果出现未覆盖槽、多个主节点声称拥有同一槽,或“节点对槽配置意见不一致”,就要回到 CLUSTER NODES 对比不同节点的视图。不要立即执行 --cluster fix,因为修复槽归属可能迁移或重新指派数据,生产环境必须先确认权威节点和数据归属。
配置纪元用于解决槽位归属冲突:当不同节点传播互相矛盾的槽配置时,更新的配置纪元通常具有更高优先级。cluster_current_epoch 是节点已知的集群最高纪元,CLUSTER NODES 中每个主节点也有自己的 config epoch。正常排障时应观察它们是否最终收敛,而不是手工修改纪元;错误使用 CLUSTER SET-CONFIG-EPOCH 可能制造新的冲突。
根据证据修复后再验收
槽位缺失时,先确认是否来自节点误删、迁移中断或新节点尚未完成槽分配;通信异常时,修复 Cluster Bus 端口、地址宣布配置和网络策略;真实节点故障时,则按既定故障转移或节点替换流程恢复。涉及 CLUSTER MEET、CLUSTER FORGET、CLUSTER REPLICATE、重新分槽等写操作时,都应先确认节点身份和当前槽所有权。
修复后至少重复执行 CLUSTER INFO、CLUSTER NODES 和 redis-cli --cluster check。验收标准是 cluster_state:ok、16384 个槽全部覆盖且无 pfail/fail 槽,同时多个节点对槽位配置达成一致。这样才能证明问题已经从“表面恢复”变成“集群视图真正收敛”。