
Redis 与缓存 / 系统课时
理解内存淘汰策略
理解内存淘汰策略
当 Redis 的数据集逼近 maxmemory 时,真正需要决定的不是“要不要省内存”,而是哪些键可以被舍弃、按什么信号舍弃。本节把候选键范围和淘汰算法拆开比较,并给出一套可验证的策略选择方法。
学习目标
- 解释
noeviction、LRU、LFU、随机和 TTL 策略的行为差异 - 区分
allkeys-*与volatile-*的候选键范围 - 通过配置与运行指标验证淘汰策略是否符合访问模式
先看淘汰何时触发
maxmemory 是数据集可使用内存的上限;达到上限后,Redis 才会按 maxmemory-policy 处理需要继续占用内存的写入。noeviction 不会主动删除键,而是在无法继续增长时让相关写命令返回内存限制错误;读取已有数据仍可继续。
下面把上限设为 256 MiB,并选择 allkeys-lfu。这是运行时配置,生产环境还应通过配置文件或平台配置持久化。
redis-cli CONFIG SET maxmemory 256mb
redis-cli CONFIG SET maxmemory-policy allkeys-lfu
redis-cli --raw CONFIG GET maxmemory
redis-cli --raw CONFIG GET maxmemory-policy
预期输出:
OK
OK
maxmemory
268435456
maxmemory-policy
allkeys-lfu
把候选范围和算法分开理解
| 策略 | 候选键 | 淘汰依据 | 适合场景 |
|---|---|---|---|
noeviction |
无 | 不淘汰,写入可能失败 | 数据不能被缓存策略自动丢弃 |
allkeys-lru |
所有键 | 近似选择最久未访问的键 | 热点明显、访问具有时间局部性的缓存 |
allkeys-lfu |
所有键 | 近似选择访问频率较低的键 | 热点长期稳定、希望保护高频键 |
allkeys-random |
所有键 | 随机 | 键价值和访问概率接近 |
volatile-lru / volatile-lfu / volatile-random |
仅设置 TTL 的键 | LRU、LFU 或随机 | 同一实例中只有部分键允许淘汰 |
volatile-ttl |
仅设置 TTL 的键 | 优先淘汰剩余 TTL 更短的键 | 应用能用 TTL 表达数据淘汰优先级 |
volatile-* 最容易被误解:它不是“优先淘汰带 TTL 的键,然后再淘汰其他键”,而是只在带 TTL 的键里选择。如果当前没有可淘汰的 TTL 键,它会表现得接近 noeviction,后续需要增长内存的写入可能失败。
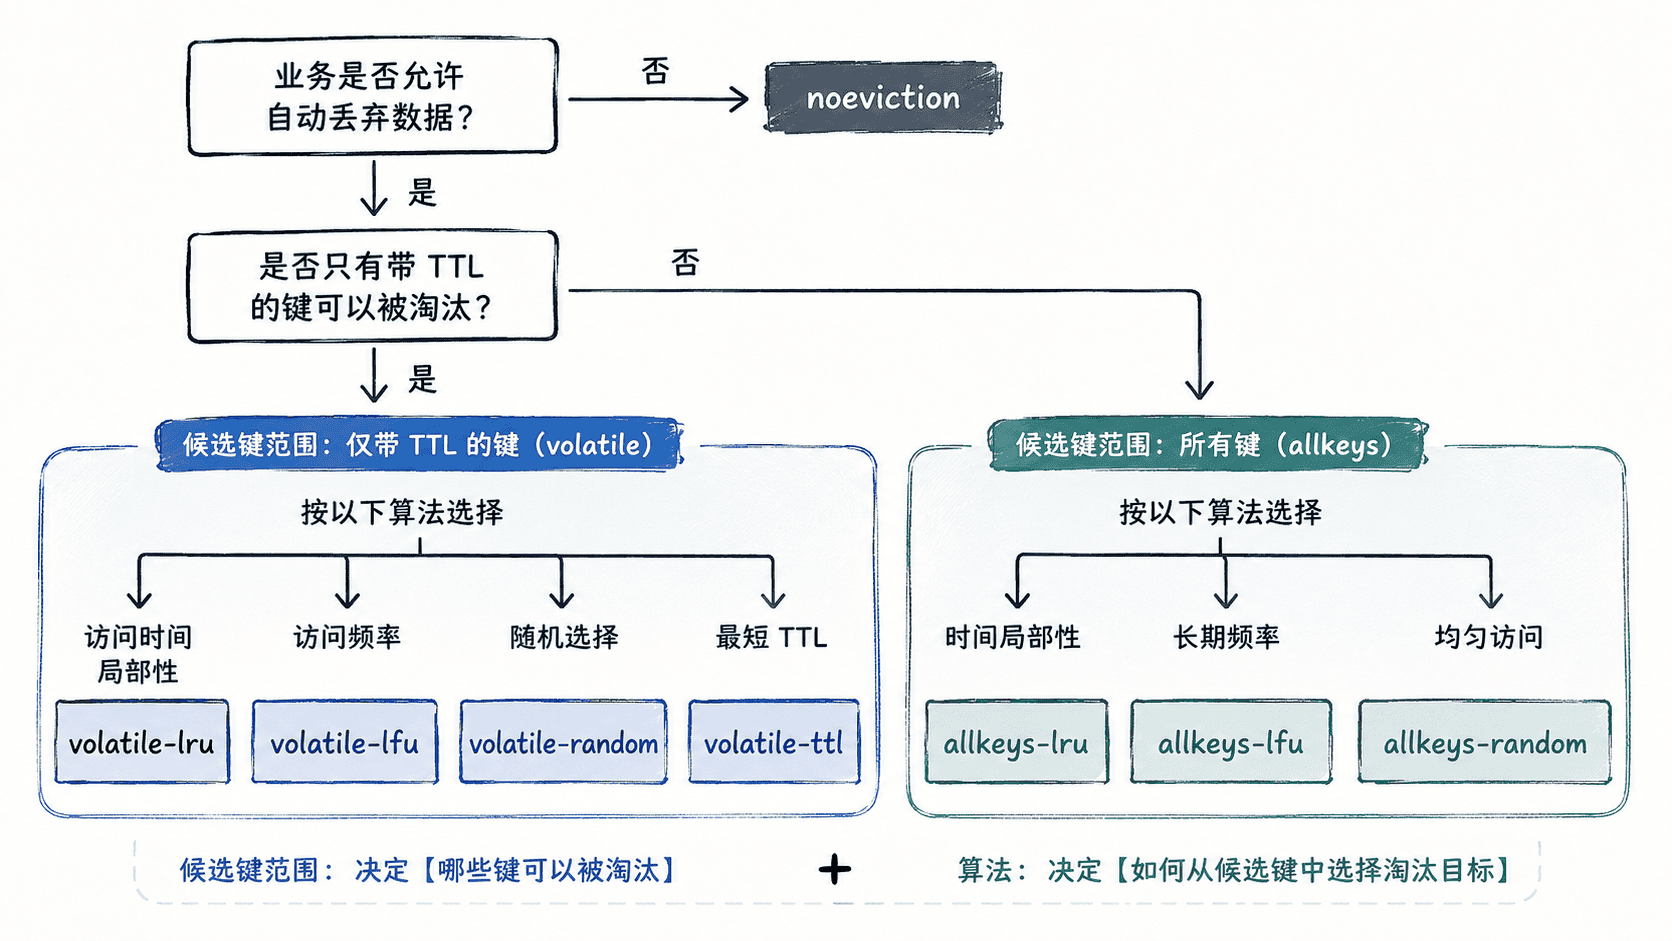
LRU、LFU 和 TTL 看的是不同信号
LRU 更看重“最近是否访问过”,短期突发热点容易被保留;LFU 更看重“长期访问频率”,旧热点会随时间衰减,不会永久占据优势。两者都采用近似算法,而不是维护一个精确的全量排序,因此不要把策略理解成绝对严格的队列。
volatile-ttl 不观察访问热度,而是把应用设置的 TTL 当作优先级提示。若业务已经能准确判断哪些缓存更快过期,它很直接;若大量键 TTL 相同或 TTL 只是统一模板值,它提供的区分度就很低。随机策略开销直观,但只有在键价值近似时才容易接受。
用指标验证选择是否有效
策略上线后,应同时观察内存水位、淘汰量和命中情况。下面的命令不会制造淘汰,只用于确认当前策略和结果指标。
redis-cli INFO memory | grep -E 'used_memory_human|maxmemory_human|maxmemory_policy'
redis-cli INFO stats | grep -E 'evicted_keys|keyspace_hits|keyspace_misses'
预期输出示例:
used_memory_human:<VALUE>
maxmemory_human:256.00M
maxmemory_policy:allkeys-lfu
evicted_keys:<VALUE>
keyspace_hits:<VALUE>
keyspace_misses:<VALUE>
<VALUE> 会随实例状态变化。若 evicted_keys 持续快速增长且命中率下降,通常不是简单地“换一个算法”就能解决,还要检查容量是否过小、TTL 是否失控以及是否存在大键。反过来,缓存允许丢失时长期使用 noeviction,会把内存压力转化成写入错误,也需要明确由上层应用承担。