
Redis 与缓存 / 系统课时
理解 Redis 内存构成
理解 Redis 内存构成
Redis 的内存占用并不等于所有键和值大小之和。除了业务数据,Redis 还需要保存对象元数据、哈希表和过期信息,并为客户端、复制和持久化过程准备缓冲区。理解这些来源,才能正确解释 used_memory 为什么增长,以及内存到底消耗在哪里。
学习目标
- 区分数据内存、对象开销与各种缓冲区的职责
- 使用
INFO memory观察 Redis 的主要内存指标 - 判断数据量不大但进程内存较高时应检查哪些方向
Redis 内存不是只有键和值
业务数据通常占据主要空间,但每个键值还伴随额外结构。例如键名需要存储空间,Redis 对象包含类型和编码等元数据,数据库字典需要哈希表桶,设置 TTL 的键还要维护额外的过期字典。因此,大量短键、小值并不意味着内存开销可以忽略。
另一部分内存来自运行时工作区。客户端连接可能积累输入或输出缓冲区;主从复制需要复制积压缓冲区和从节点相关缓冲;执行持久化或复制时还可能出现写时复制带来的额外物理内存占用。它们不会直接对应某一个业务键,却会影响实例总内存。
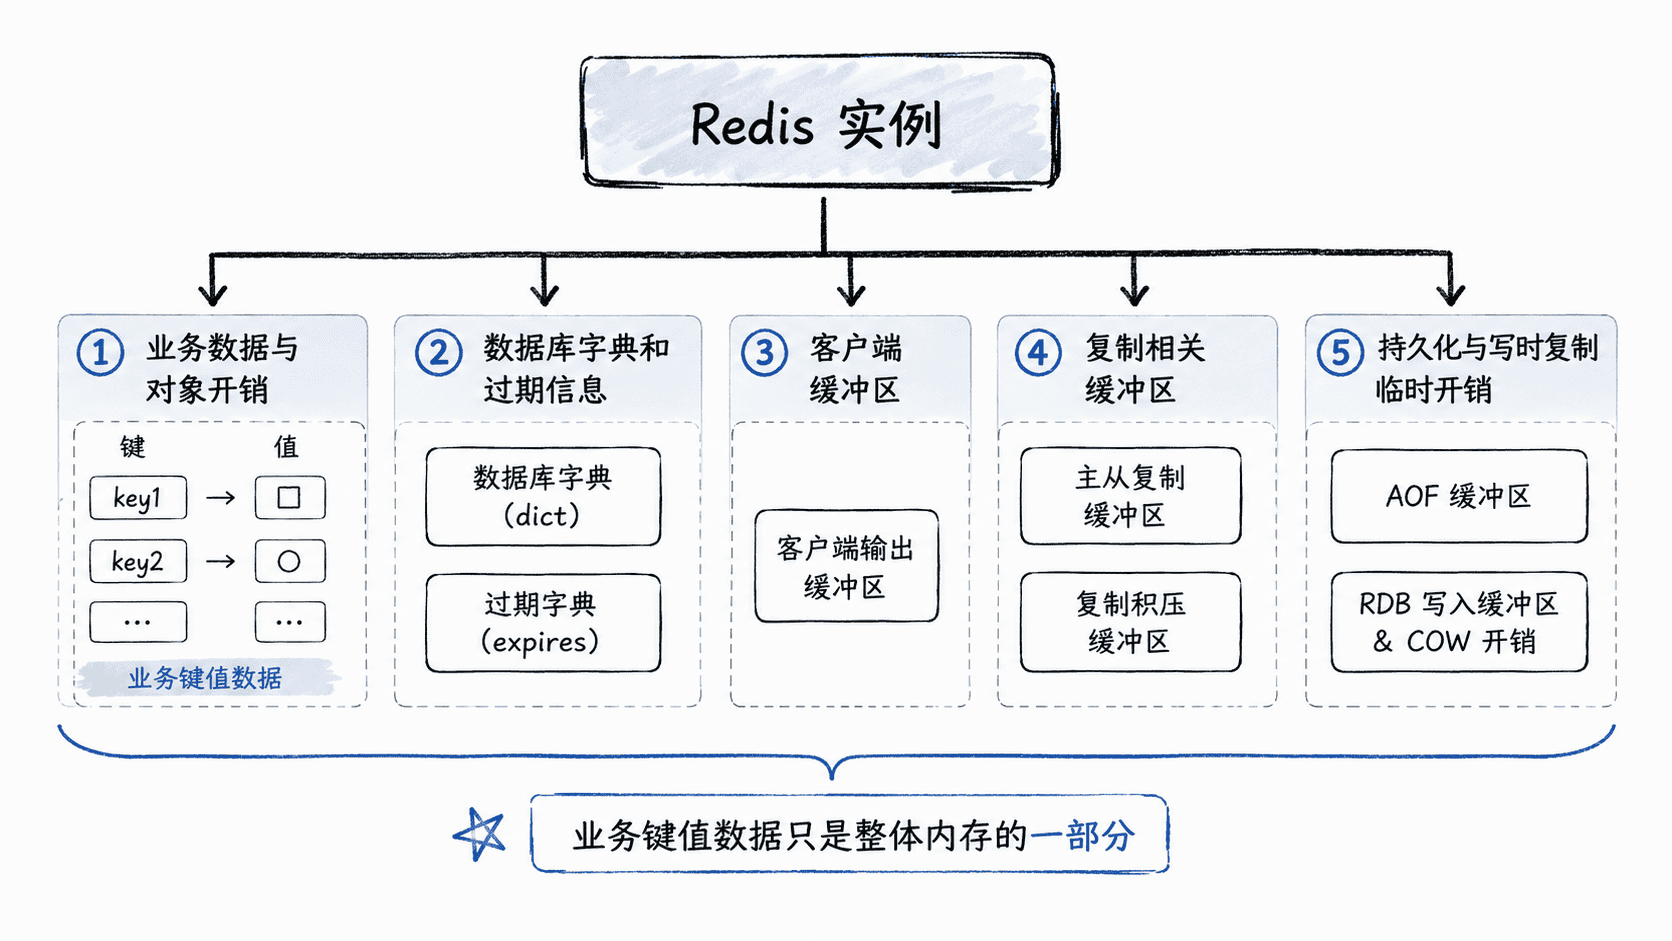
操作系统看到的 Redis 进程常驻内存也可能高于 Redis 自己统计的已分配内存。原因包括内存分配器碎片、已经释放但尚未归还操作系统的页,以及子进程写时复制等,所以排查时不能只看单一数字。
从 INFO memory 读取关键指标
可以直接查看 Redis 暴露的内存统计。下面只筛选最常用的几个字段,避免被完整输出淹没。
redis-cli INFO memory | grep -E '^(used_memory:|used_memory_rss:|used_memory_peak:|mem_fragmentation_ratio:|maxmemory:)'预期输出
used_memory:<VALUE>
used_memory_rss:<VALUE>
used_memory_peak:<VALUE>
maxmemory:<VALUE>
mem_fragmentation_ratio:<VALUE>
<VALUE> 会随实例状态变化。used_memory 表示 Redis 通过分配器管理的内存,used_memory_rss 是操作系统观察到的常驻物理内存,used_memory_peak 记录历史峰值,maxmemory 是配置的内存上限。碎片率可以作为线索,但不能脱离实际字节数单独判断异常。
容易误判的内存现象
当 used_memory_rss 明显高于 used_memory 时,不应立即得出“Redis 内存泄漏”的结论。实例经历大量删除、键尺寸剧烈变化后,分配器可能暂时保留空闲页;如果同时发生后台保存或重写,还要考虑写时复制造成的峰值。
客户端缓冲区也值得单独关注。慢消费者、执行大结果查询的连接或网络阻塞,都可能让输出缓冲持续增长。此时键空间大小可能几乎没变,但 Redis 内存仍然上涨,因此排查应把连接状态和复制状态一起纳入证据链。
做容量规划时看什么
容量估算至少应给业务数据之外留出对象和字典开销、客户端缓冲、复制缓冲以及后台任务产生的峰值空间。启用 maxmemory 后,还要确认其上限与宿主机可用内存之间存在安全余量,避免 Redis 尚未达到自身上限时就让操作系统先进入严重内存压力。
因此,分析 Redis 内存时应同时回答三个问题:业务数据实际占多少、运行机制额外占多少、操作系统最终驻留多少。只有把这三层区分开,used_memory、RSS 和机器总内存之间的差异才具有可解释性。