
Redis 与缓存 / 系统课时
Redis 是什么
Redis 是什么
Redis 是一个以内存数据结构为核心的数据服务。本篇不把它简单等同于“缓存”,而是从数据模型、访问方式、持久化与高可用能力出发,建立选择 Redis 时最重要的判断框架。
学习目标
- 说清 Redis 与传统关系型数据库、普通内存缓存的核心差异
- 识别 Redis 常见数据结构及其适用问题
- 判断缓存、计数、排行榜、消息流等场景是否适合 Redis
先抓住 Redis 的核心定位
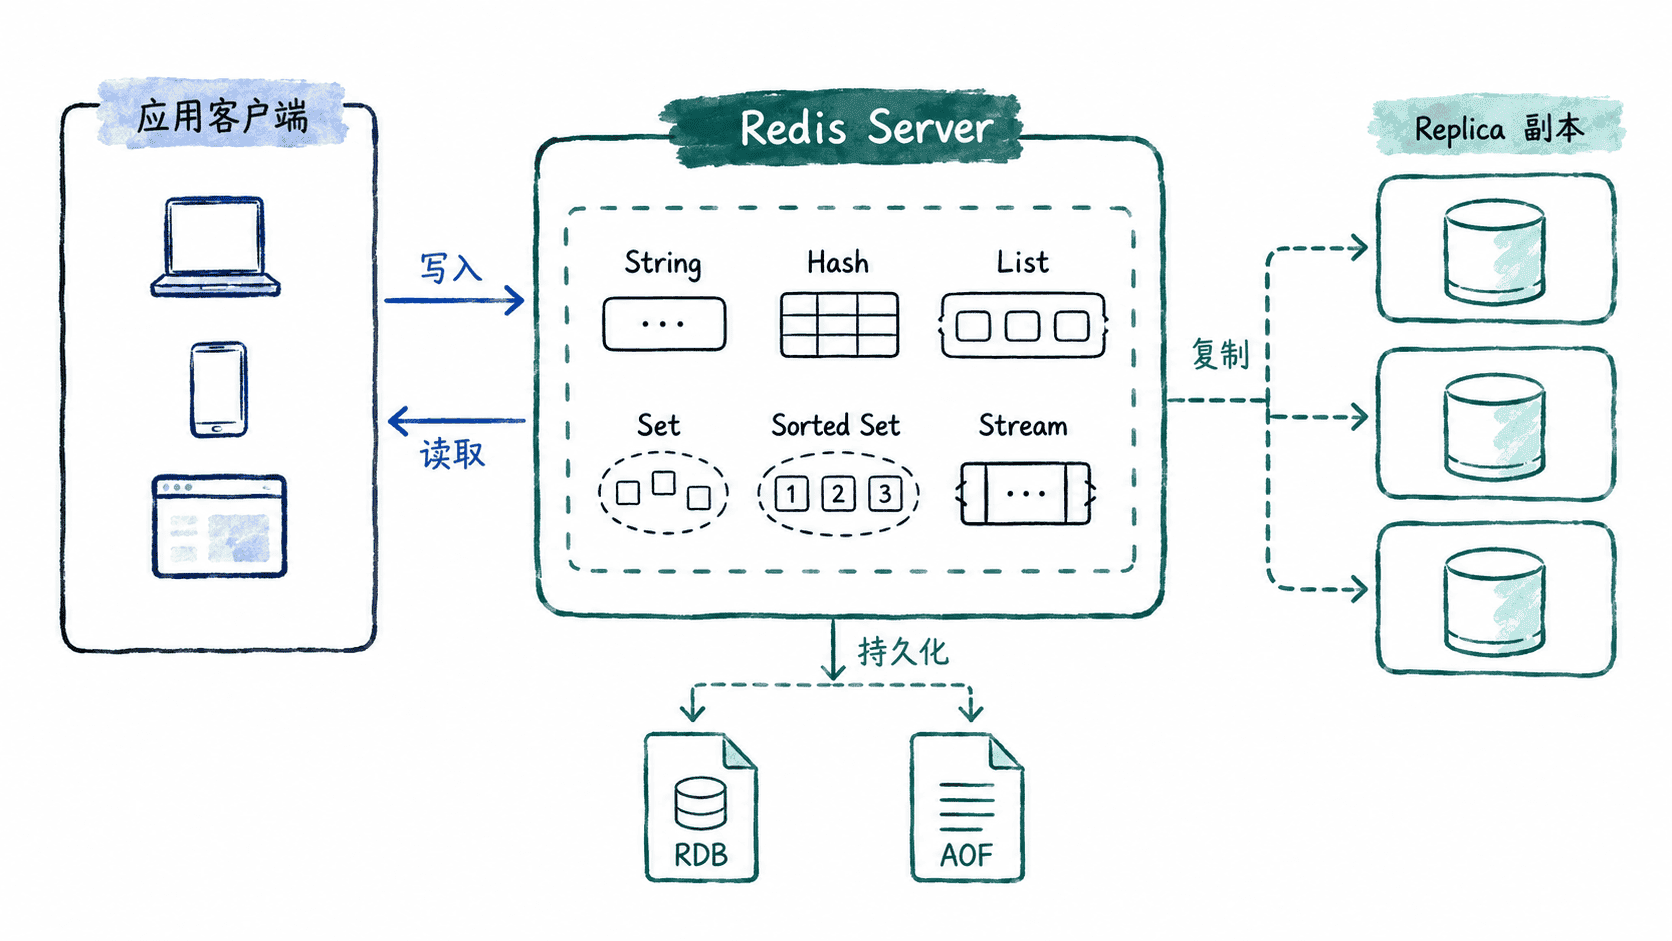
Redis 可以理解为“通过网络访问的数据结构服务器”。应用把键和值交给 Redis 管理,但值不只是一段字符串,还可以是 Hash、List、Set、Sorted Set、Stream 等结构,并通过对应命令直接完成增删、计数、集合运算和范围查询。
数据主要驻留在内存中,因此 Redis 擅长低延迟访问;同时它又提供过期时间、持久化、复制和高可用相关能力,所以它并不是“进程退出就全部消失”的普通内存变量。是否启用持久化、采用哪种复制与故障转移方案,需要按业务的数据可靠性要求决定。
Redis 为什么适合高频访问
Redis 的优势首先来自数据主要在内存中,常用命令的执行路径短,很多数据结构操作可以直接在服务器端完成,减少应用反复读回数据再计算的开销。单个命令还具有原子执行语义,适合计数、条件写入、集合成员变更等并发场景。
不要把 Redis 的性能简单归因于“单线程”。不同版本会在网络 I/O、持久化、释放内存等环节使用额外线程或后台任务;真正需要关注的是命令复杂度、热键、大对象、网络往返和内存压力。一个复杂或阻塞时间过长的命令,同样会拉高其他请求的延迟。
主要能力与典型场景
String 适合缓存文本、计数器和分布式锁中的令牌值;Hash 适合保存字段较多的小对象;List 与 Stream 可用于顺序消息处理;Set 适合去重和成员关系;Sorted Set 通过分值维护顺序,常用于排行榜、延迟任务索引和按分数范围查询。
在工程中,Redis 常被放在数据库或服务前面承担缓存,也可以保存会话、限流计数、验证码、实时榜单、在线状态和短生命周期任务数据。Pub/Sub 适合即时广播但不负责消息持久化,要求可追溯消费时通常应考虑 Stream 等更合适的数据结构。
选择 Redis 时要看清边界
Redis 的高速访问以宝贵的内存资源为主要成本,因此大对象、海量冷数据或长期归档通常不是它的强项。虽然 RDB、AOF、复制和高可用机制能够提高数据可靠性,但“有副本”并不等于绝对不丢数据,故障窗口和持久化策略仍需明确。
如果业务依赖复杂关联查询、强关系约束或大规模历史分析,关系型数据库或分析系统通常更合适。Redis 最有价值的用法,是把明确的数据结构和访问模式映射成低延迟命令,并把它放在整体数据架构中承担合适的一层,而不是无条件替代主数据库。