
Redis 与缓存 / 系统课时
为什么需要 Redis Cluster
为什么需要 Redis Cluster
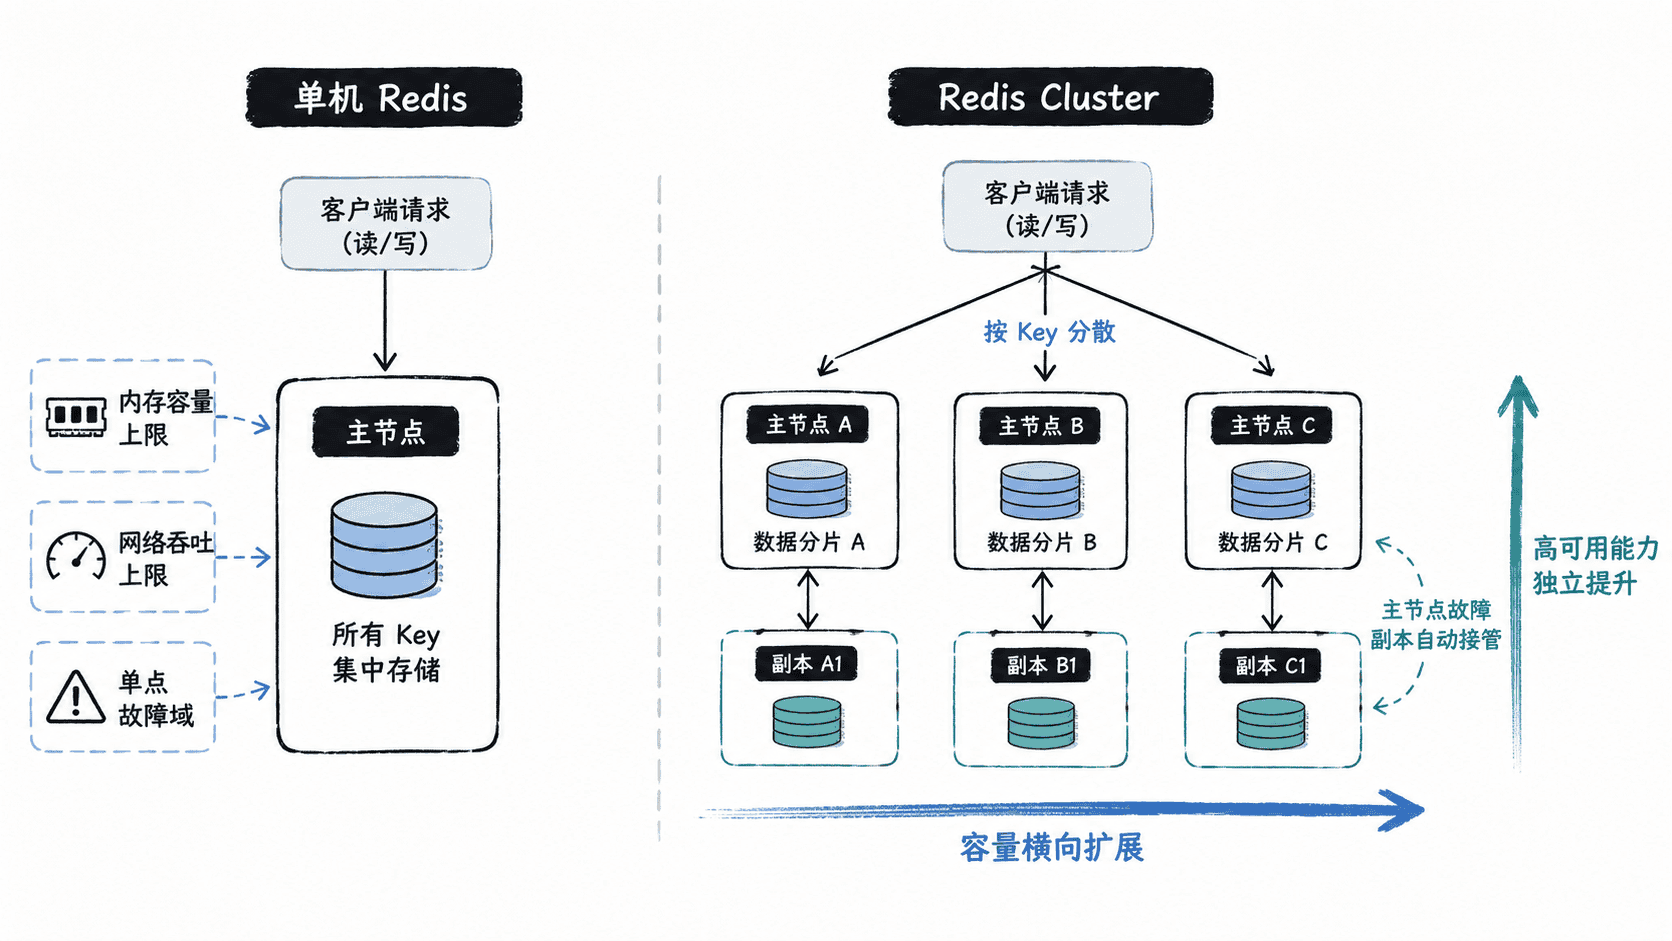
当单机 Redis 的内存、网络吞吐或故障恢复能力接近上限时,继续纵向升级机器往往成本更高、风险也更集中。Redis Cluster 的核心价值,是把数据和请求分散到多个主节点,并配合副本与故障转移,让容量扩展和高可用从“单机能力”转变为“集群能力”。
学习目标
- 说清单机 Redis 在容量、吞吐和故障域上的主要限制
- 理解 Redis Cluster 如何通过分片与副本分别解决扩展和高可用问题
- 判断哪些场景适合使用 Cluster,哪些问题仍需应用侧治理
单机瓶颈为什么会出现
Redis 主要把数据放在内存中,因此单机可承载的数据规模首先受可用内存限制。即使机器还能继续扩容,持久化、主从全量同步、故障重启和数据恢复的时间也会随数据集变大而增加,故障影响面随之扩大。
吞吐也不是无限增长。单个 Redis 实例需要共享同一台机器的 CPU、内存带宽和网络出口;当热点请求、复杂命令或大 Key 持续占用资源时,单纯增加客户端连接并不能线性提升处理能力。
更关键的是,只有一个主节点时,所有写入都集中在同一个故障域。传统主从复制可以提供副本,但它本身并不会把数据拆散到多台主节点上,因此“容量扩展”和“高可用”仍是两个不同问题。
Cluster 同时解决哪两类问题
Redis Cluster 先把整个键空间划分为固定数量的哈希槽,再把不同槽分配给不同主节点。这样,一个键只会落到某个槽,再由负责该槽的主节点处理。新增主节点后,可以迁移一部分槽给新节点,从而把数据量和请求压力继续摊开。
高可用则依赖主从复制。生产集群通常为每个主节点配置一个或多个副本;当主节点被判定为失效后,满足条件的副本可以被提升为新的主节点,并继续负责原来的槽。由此可见,分片负责扩展,副本负责容灾,两者缺一不可。
这也解释了为什么“3 个主节点但没有副本”不能算完整的高可用方案:它可以扩容,但任意主节点宕机后,对应槽的数据就会暂时不可服务。
Cluster 不会自动消除所有瓶颈
Cluster 只能把可分散的键和值分到不同节点。如果大量访问集中在同一个热点 Key,所有请求仍会落到同一个槽和同一个主节点,集群节点再多也无法自动均摊这个热点。
多 Key 操作还会受到槽位边界约束。事务、Lua 脚本或需要同时访问多个键的命令,如果相关键不在同一槽,通常不能像单机那样直接执行。实际设计中常通过 Hash Tag 让必须一起操作的键落到同一槽,但这也可能形成新的局部热点。
此外,Cluster 引入了节点发现、槽迁移、故障转移、重定向和客户端拓扑感知等运维复杂度。它不是“把几台 Redis 连起来”这么简单,而是用更复杂的分布式机制换取更大的容量与更小的单点故障影响。
什么时候值得采用 Cluster
当数据规模明显超过单机合理内存预算、写入或读取吞吐需要跨多个主节点扩展,或者业务要求分片与自动故障转移同时存在时,Redis Cluster 才真正体现价值。反过来,如果数据量很小、访问压力稳定、强依赖大量跨 Key 操作,过早引入 Cluster 只会增加复杂度。
选择 Redis Cluster 的本质,是接受“数据被分散管理”这一前提,换取容量、吞吐和故障域的横向扩展。后续所有设计——包括键命名、客户端选型、槽迁移和故障处理——都建立在这个前提上。