
Redis 与缓存 / 系统课时
拆分与删除大键
拆分与删除大键
大键的问题不只在“占内存多”,还在于一次处理大量元素时可能拉长主线程执行时间,尤其是同步删除和遍历。本节用“先拆分、再迁移、最后异步或分批删除”的路径,把一次重操作拆成可控的小操作,并给出切换验收边界。
学习目标
- 根据访问模式为大 Hash、Set、ZSet 或 List 设计可控的分片边界
- 使用
UNLINK降低整键删除时的同步内存释放阻塞 - 在必须保留部分数据时采用扫描加小批量删除,并完成切换验收
为什么大键删除容易放大延迟
Redis 大多数命令在主线程上执行。删除一个包含大量内部对象的键时,键从键空间移除只是第一步,释放对象及其内存也需要工作;使用 DEL 处理复杂大键时,这段释放成本可能直接落在命令执行路径上。
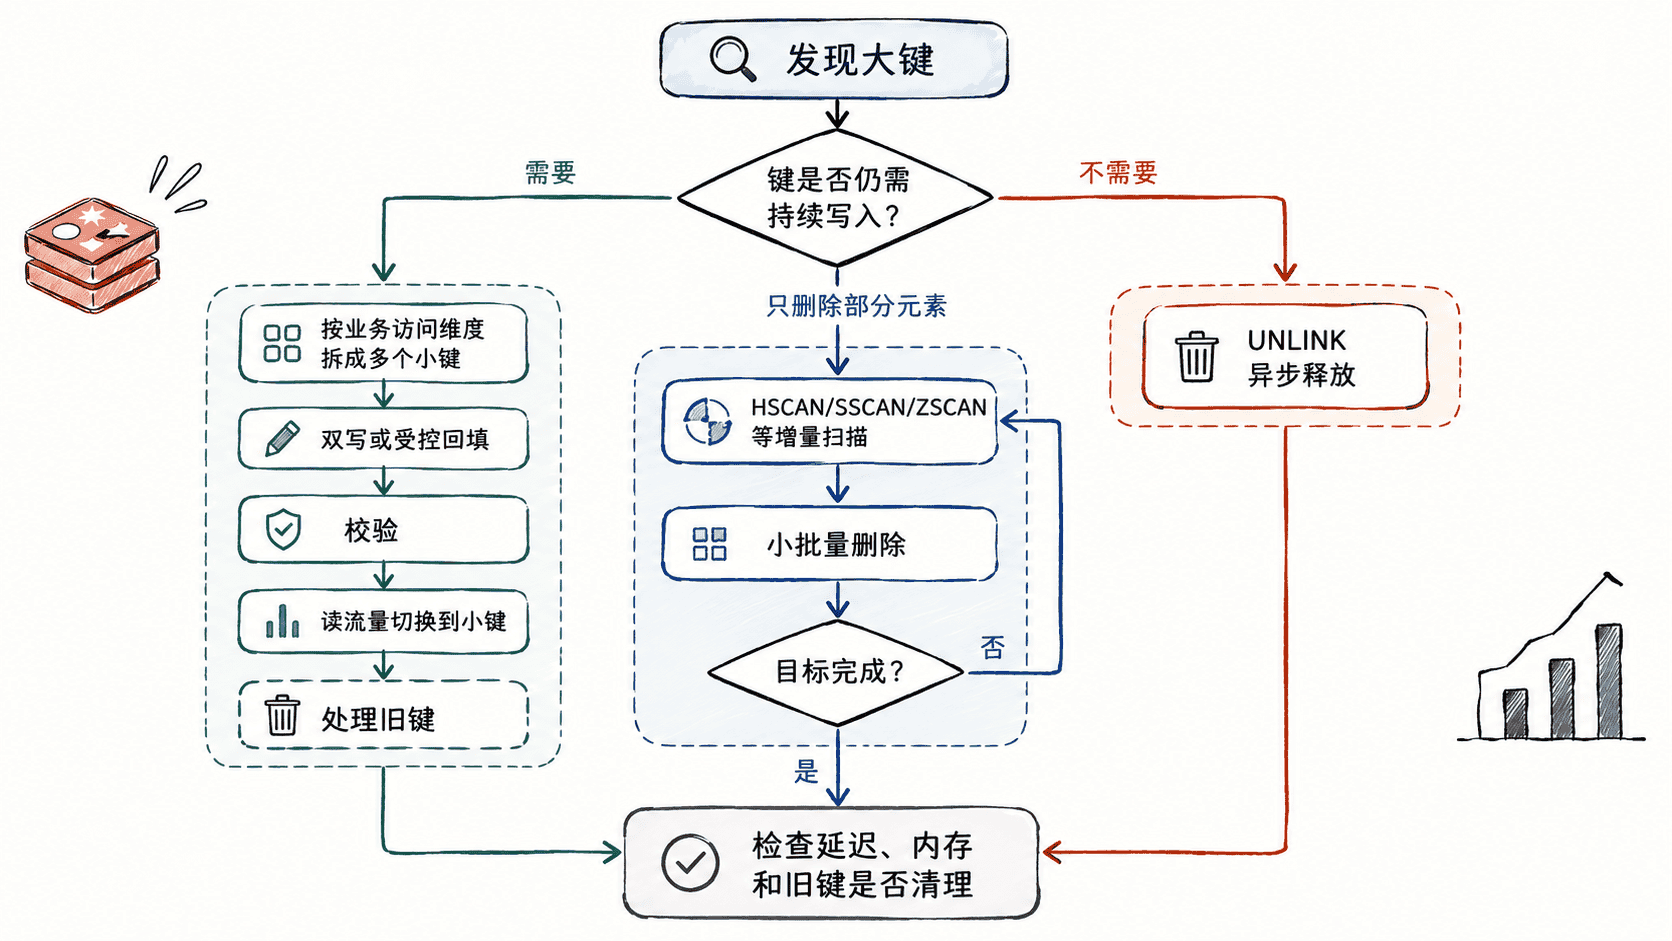
因此要区分两类目标:整键已经废弃时,优先让释放异步化;只想删除其中一部分元素时,把操作拆成小批次。若大键还会持续增长,则只优化删除方式不够,写入模型本身也应拆分。
拆分要跟着访问模式走
拆分不是把一个键机械切成固定份数,而是让单次读写天然只命中少量分片。例如一个不断增长的用户事件 Hash,可以按月份拆成 user:42:events:2026-08、user:42:events:2026-09,这样查询最近事件时只访问最近分片,过期和删除也能按分片进行。
如果业务没有自然时间窗口,可以按稳定哈希桶拆分,但要记录“业务对象到桶”的规则。Redis Cluster 中还要检查多键操作是否跨 slot:依赖事务、Lua 或多键命令的对象,拆分后若落到不同 slot,原来的原子操作可能不再成立。
整键废弃时优先异步释放
UNLINK 会先把键从键空间移除,再把实际内存回收工作交给后台线程。下面先创建一个小型演示 Hash,再执行异步删除;真实大键的 MEMORY USAGE 会明显更大。
redis-cli HSET big:demo f1 v1 f2 v2 f3 v3 f4 v4 f5 v5 f6 v6
redis-cli MEMORY USAGE big:demo
redis-cli UNLINK big:demo
redis-cli EXISTS big:demo
预期输出:
6
<BYTES>
1
0
<BYTES> 与 Redis 版本、编码方式和内存分配器有关。UNLINK 返回 1 表示键已从键空间解除关联,随后 EXISTS 立即得到 0;后台内存回收可能仍在继续,所以不要用“键已不存在”推断物理内存已经瞬间全部下降。
只删部分元素时渐进处理
对于 Hash、Set 和 ZSet,可以用 HSCAN、SSCAN、ZSCAN 增量取得一小批元素,再用 HDEL、SREM、ZREM 删除这一批。COUNT 只是每次扫描工作的提示值,不保证严格返回指定数量,因此批大小要结合单元素尺寸和延迟预算测试。
下面是片段示例,假设调用方会保存扫描游标,并把本轮实际返回的字段填入删除命令;占位符不能直接照抄执行。
redis-cli HSCAN big:hash <CURSOR> COUNT 500
redis-cli HDEL big:hash <FIELD_1> <FIELD_2> <FIELD_3>
当扫描游标回到 0 后,再检查剩余元素数量;若迁移期间仍有并发写入,应先停止旧键写入或采用双写,否则“扫描完成”并不代表旧键不会再次增长。生产环境也不要用 KEYS 找大批键后一次性 DEL,这会把扫描和删除两个重操作叠加到主线程。
迁移切换要有可回退边界
拆分已有大键时,稳妥顺序通常是:新写入先双写旧键和新分片,后台回填历史数据,按数量或业务校验和确认一致,再把读取切到新分片;观察一段时间后,才对旧键执行 UNLINK。如果数据允许短暂冻结写入,也可以用维护窗口代替双写。
验收至少看三件事:旧键是否停止增长,新分片是否覆盖预期数据,以及操作期间 Redis 延迟是否保持在服务目标内。拆分解决的是“未来每次只处理更小的数据单元”,渐进删除解决的是“部分清理不要一次做完”,UNLINK 解决的是“整键删除时不要把大部分释放成本压在主线程上”;三者针对的是不同阶段,不能互相替代。