
Redis 与缓存 / 系统课时
安全遍历键空间
安全遍历键空间
本课解决“如何查找大量键而不长时间阻塞 Redis”的问题。你将理解 KEYS 的风险,掌握 SCAN 的游标式遍历,并正确处理空批次、重复结果和遍历期间的数据变化。
学习目标
- 说明
KEYS在大键空间中的阻塞风险 - 使用
SCAN按游标和匹配模式分批遍历 - 处理重复键、空批次和非快照语义
为什么生产环境慎用 KEYS
KEYS pattern 会一次扫描当前数据库中的全部键,并在完成前占用 Redis 主线程。它只适合开发环境、临时测试或已经确认键数量很少的数据库,不应放入在线接口、定时任务或监控脚本。
KEYS * 的危险不在返回结果大小本身,而在扫描工作一次完成,无法像 SCAN 那样把负载拆到多个批次。
SCAN 的游标循环
SCAN cursor [MATCH pattern] [COUNT count] 每次返回下一游标和一批键。从游标 0 开始,把返回游标继续传给下一次调用;只有游标再次变为 0,本轮遍历才结束。
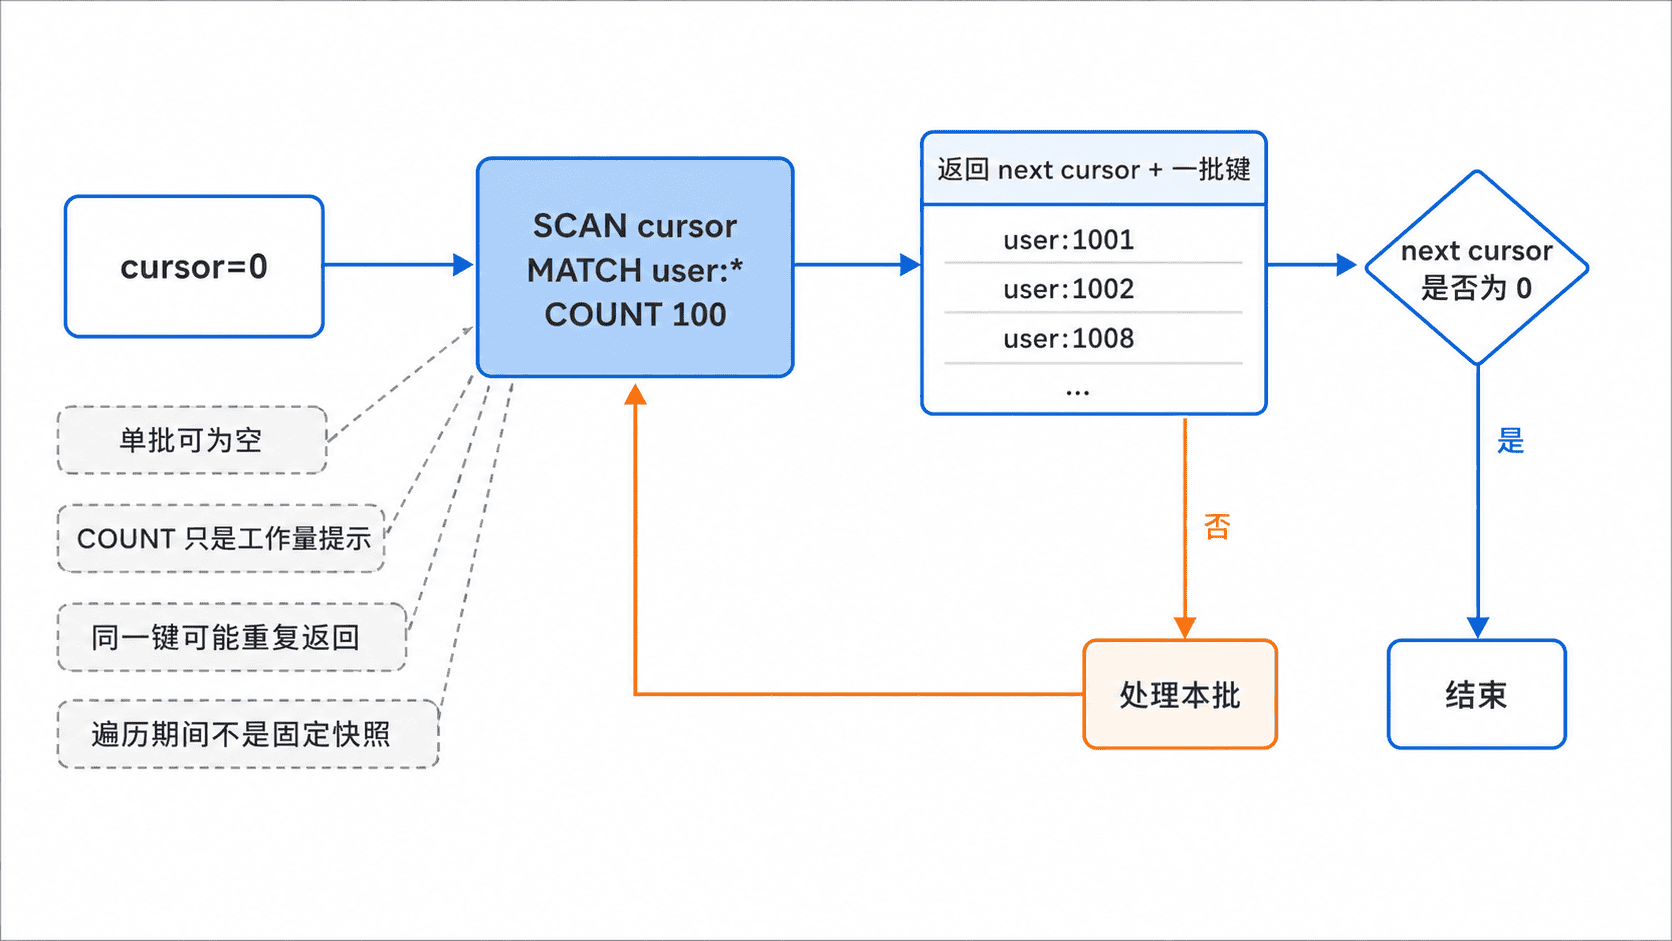
COUNT 是工作量提示,不保证每批恰好返回指定数量。某一批可能没有匹配键,但只要游标不为 0,就必须继续。
主示例:完整遍历 user 前缀
下面脚本在数据库 0 中遍历 user:*,逐批输出键名,不把全部结果一次性加载到内存。
cursor=0
while true; do
  reply=$(redis-cli -n 0 --raw SCAN "$cursor" MATCH 'user:*' COUNT 100)
  cursor=$(printf '%s\n' "$reply" | sed -n '1p')
  printf '%s\n' "$reply" | sed '1d'
  [ "$cursor" = "0" ] && break
done
预期结果:
user:1001
user:1002
输出顺序、批次划分和实际键数量可能不同。脚本依赖 redis-cli、sed 和 POSIX Shell;生产脚本还应补充连接地址、认证、超时、失败重试和限速。
理解遍历边界
SCAN 不是固定快照。遍历期间新增或删除的键不保证一定出现,同一个键也可能被重复返回。因此处理逻辑应具备幂等性,必要时使用集合、数据库唯一约束或业务状态去重。
若任务要求精确处理某一时刻的对象,应维护独立业务索引或待处理 ID,不要把实时键空间扫描当成强一致清单。
选择合适批次
较大的 COUNT 通常减少网络往返,但会增加单次扫描工作量。应从较小值开始压测,并观察 Redis 命令延迟、CPU 和业务响应时间,再确定批次大小。
匹配模式越具体,返回后的无效处理越少,但 MATCH 不能把底层扫描变成索引查询,Redis 仍需要遍历内部字典。