
Redis 与缓存 / 系统课时
Redis 为什么速度快
Redis 为什么速度快
本课从一次请求的完整路径解释 Redis 的高性能来源。重点不是记住“Redis 很快”,而是理解哪些设计减少了等待,以及哪些错误用法仍会阻塞后续请求。
学习目标
- 说明内存访问对延迟的影响
- 理解事件循环与命令执行路径
- 识别会破坏性能的常见操作
一次命令经历什么
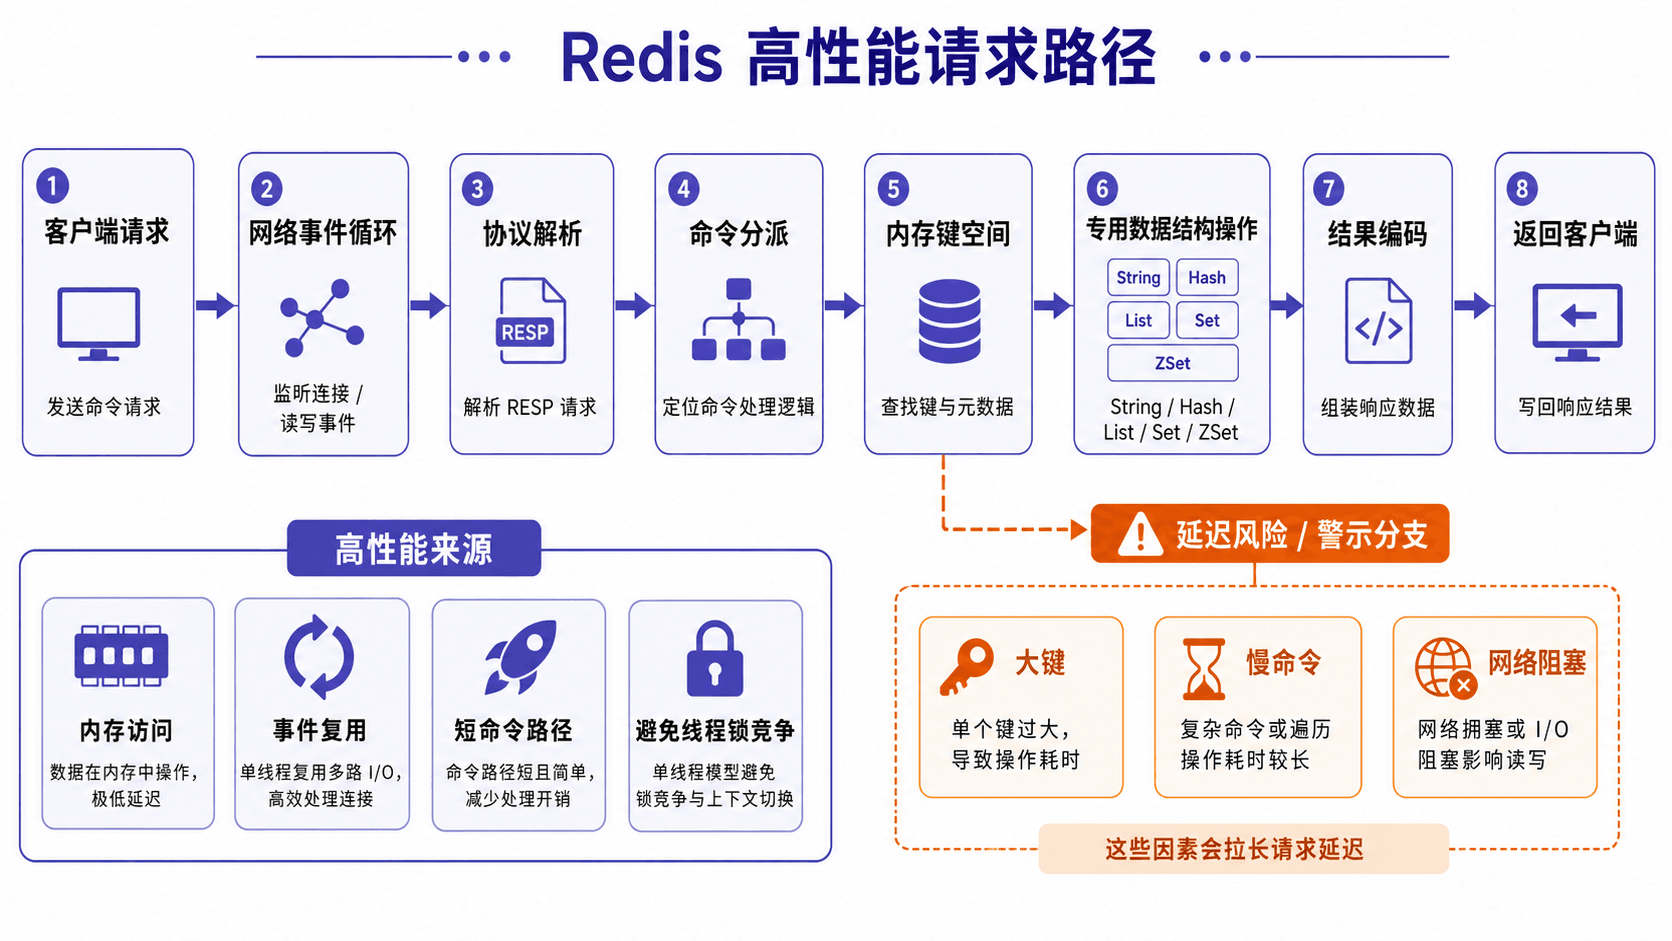
客户端发送命令后,Redis 依次完成网络读取、协议解析、键查找、数据结构操作和响应返回。多数常用命令工作量较小,因此单次请求通常可以快速完成。
内存与数据结构减少工作量
Redis 的主要数据位于内存,避免了频繁随机磁盘读取。CPU 访问内存通常比访问磁盘或远程存储更快,因此小对象读写能够获得较低延迟。
Redis 也不是把所有内容都保存成普通字符串。哈希表、跳表和紧凑编码等内部结构,会根据数据类型与规模完成查找、排序或范围读取。应用可以直接自增计数或读取排行榜,不必先取回全部数据再计算。
但“数据在内存”不代表没有成本。网络传输、序列化、内存分配、复制大对象和返回海量结果都可能成为瓶颈。
事件模型与命令执行
Redis 使用事件驱动模型管理大量连接,只处理已经就绪的套接字,不需要为每个连接长期绑定一个工作线程。
经典命令执行路径以串行方式修改数据,减少了共享状态上的锁竞争。较新版本可使用 I/O 线程辅助网络读写,但命令本身仍需控制执行时间;一个耗时命令可能让后续请求排队。
用最小命令观察路径
下面的命令只用于观察“发送命令、修改内存、返回结果”的最短路径,不代表正式性能测试:
bash
redis-cli SET perf:counter 0
redis-cli INCR perf:counter
redis-cli GET perf:counter
预期输出
text
OK
(integer) 1
"1"
复杂度决定真实表现
Redis 命令并不都同样快。读取单个键通常工作量固定,而扫描大量成员、删除大键或一次返回巨量结果,会显著延长执行时间。一次请求的总延迟可以近似表示为:
优化时应同时观察网络、排队、命令复杂度和响应体大小,而不是只看服务器 CPU。批量操作要限制单批数量,大键删除可使用异步释放,并结合慢日志与延迟监控定位问题。
按自己的节奏,确认真正理解。