
Redis 与缓存 / 系统课时
理解哈希槽
理解哈希槽
Redis Cluster 不直接把“某个 Key 固定绑定到某台机器”,而是先把 Key 映射到 16384 个哈希槽,再由当前负责该槽的主节点处理。理解这一层间接映射后,才能看懂数据分布、节点扩容、重定向以及为什么某些多 Key 命令会失败。
学习目标
- 掌握 Key 到哈希槽再到主节点的两级映射关系
- 理解 CRC16、16384 个槽和 Hash Tag 的作用
- 能用
redis-cli验证键所在槽,并解释槽迁移对客户端的影响
Key 先映射到槽
Redis Cluster 为整个键空间定义了 16384 个槽,编号范围是 0~16383。普通 Key 的槽位可以概括为:
计算得到的槽号并不等于节点编号。Cluster 会另外维护“哪些槽由哪个主节点负责”的映射关系,因此真正的查找链路是 Key → 槽 → 主节点。
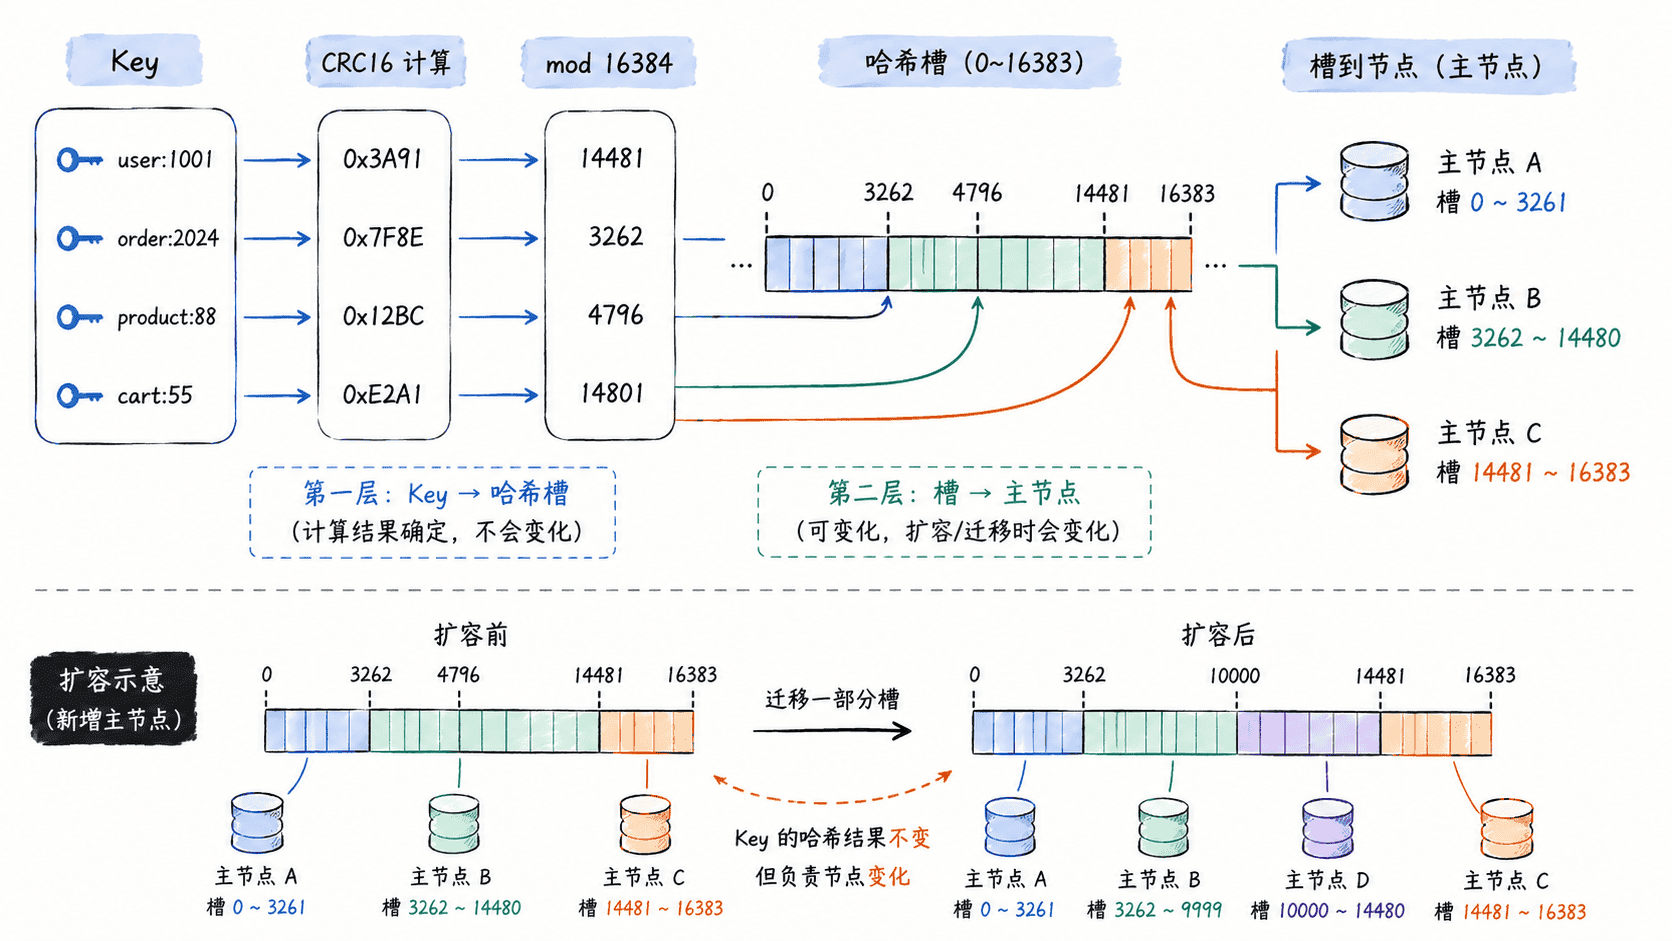
例如某个集群当前可能由三个主节点分别负责不同槽区间。以后新增节点时,不需要改变哈希算法,而是把一部分槽从旧节点迁移给新节点。这样,Key 对应的槽号保持稳定,变化的是槽的所有者。
用命令验证槽位
redis-cli 可以直接计算一个 Key 所属的槽。下面的命令不要求 Key 已经存在,只根据键名计算槽号:
redis-cli -c -p 6379 CLUSTER KEYSLOT user:1001预期输出:
<slot-number><slot-number> 会是 0~16383 之间的整数,实际值取决于键名。若要比较两个键是否能参与同一次跨 Key 操作,可以分别执行 CLUSTER KEYSLOT;返回值相同,说明它们位于同一槽。
Hash Tag 如何控制槽位
如果 Key 中包含一对花括号,并且花括号之间有非空内容,Redis Cluster 只使用其中的内容参与槽位计算。这个片段称为 Hash Tag。
例如 order:{1001}:detail 与 order:{1001}:items 都使用 1001 计算槽位,因此会落到同一槽。这样可以让事务、Lua 脚本或某些多 Key 命令访问彼此相关的键。
Hash Tag 不是越多越好。如果大量键都使用同一个标签,它们会被强制集中到同一个槽,进而集中到同一个主节点,破坏分片带来的负载均衡。因此它更适合解决“少量相关键必须同槽”的问题,而不是作为统一命名模板。
槽迁移时客户端看到了什么
客户端通常会缓存槽到节点的映射,因此请求大多可以直接发送到目标节点。如果客户端把命令发给了错误节点,Redis 会返回重定向信息。
当某个槽已经稳定地属于另一节点时,客户端会收到 MOVED,应更新槽映射并把后续请求发往新节点。槽正在迁移的短暂阶段还可能出现 ASK,表示本次请求临时去另一个节点执行,但不代表槽归属已经永久改变。
这也是 Cluster 客户端与普通单机客户端的重要区别:合格的 Cluster 客户端需要理解槽映射和重定向,而不能永远只连接一个固定地址。
设计键名时要记住的边界
哈希槽让 Redis Cluster 可以通过迁移槽来重新平衡数据,但它并不会自动保证每个槽的数据量完全一致,也不会识别业务热点。不同 Key 即使数量相近,其值大小和访问频率也可能相差很大。
因此,键设计时既要避免无意中把大量数据塞进同一个 Hash Tag,也要识别超级热点 Key。理解“Key → 槽 → 节点”这条链路后,扩容、跨槽报错和热点定位都会变得更容易解释。