
Redis 与缓存 / 系统课时
设计缓存过期时间
设计缓存过期时间
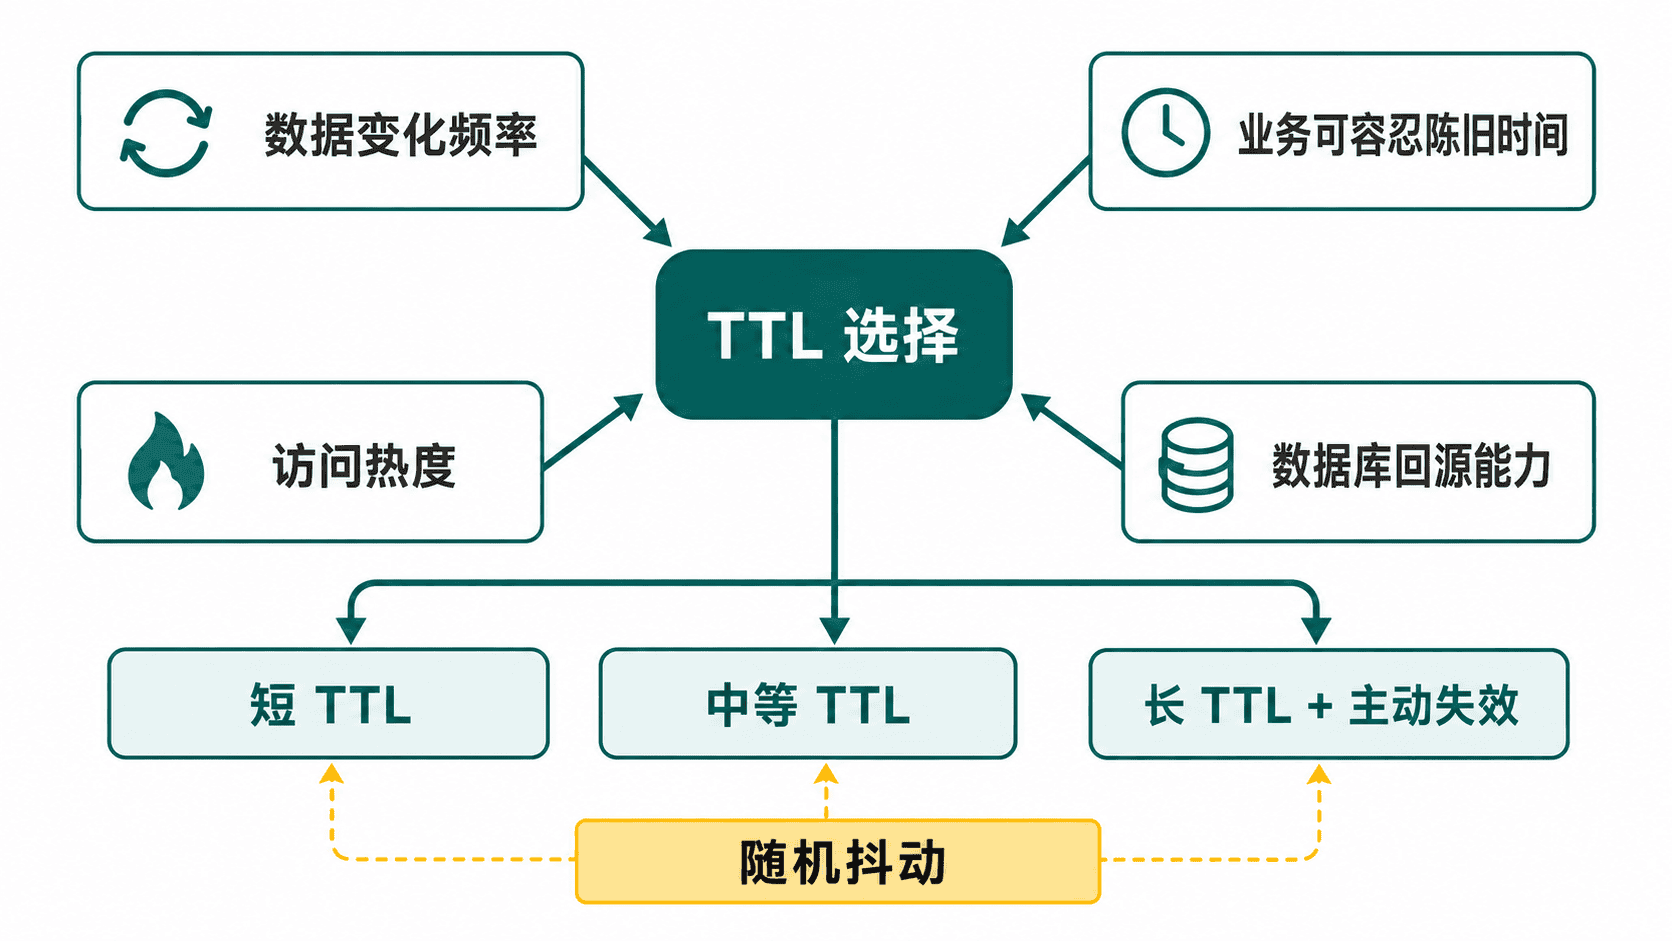
本课解决 TTL 应该设置多长的问题。你将从数据变化速度、允许陈旧程度、访问热度和回源能力出发设计过期时间,避免缓存过久产生旧数据,也避免过短造成频繁回源。
学习目标
- 理解 TTL 对数据新鲜度和回源压力的影响
- 根据数据特征选择合理的过期区间
- 使用随机抖动减少集中失效
TTL 的核心权衡
TTL 越长,缓存命中率通常越高,数据库压力越小,但旧数据停留时间也越长。TTL 越短,数据更接近实时,却会增加缓存重建次数和回源流量。
可以把 TTL 看成业务允许的“最大自然陈旧窗口”。价格最多允许延迟 30 秒,就不应仅为追求命中率而设置数小时;基础字典几乎不变,则可以设置较长 TTL,并在变更时主动删除缓存。
按数据特征选择区间
高频变化且强时效的数据应使用较短 TTL,或配合主动失效。例如实时库存和活动资格,通常需要秒级到分钟级控制。
变化较慢但访问频繁的数据可以使用中等 TTL,例如商品详情和用户基础资料。几乎不变的数据可以使用长 TTL,并通过发布事件或配置变更主动删除。
这些区间不是固定标准。最终数值应结合业务峰值、数据库容量、命中率和回源指标逐步校准。
设置 TTL 并增加抖动
下面的 Bash 示例以 300 秒为基础 TTL,再增加 0 到 60 秒随机抖动,随后读取剩余时间。示例默认连接本机 Redis。
bash
set -euo pipefail

base_ttl=300
jitter=$((RANDOM % 61))
ttl=$((base_ttl + jitter))

redis-cli --raw SET product:1001 '{"name":"Keyboard","price":199}' EX "$ttl"
redis-cli --raw TTL product:1001
预期输出:
text
OK
<TTL_SECONDS>
<TTL_SECONDS> 通常位于 300 到 360 之间,并会因命令执行耗时略有减少。TTL 返回 -1 表示键存在但没有过期时间,返回 -2 表示键不存在。
何时不只依赖自然过期
对重要且可以明确感知变更的数据,仅依赖 TTL 往往不够。更稳妥的做法是数据库更新成功后主动删除缓存,同时保留 TTL 兜底,防止失效事件丢失或旧值长期残留。
永久不过期的键需要可靠的主动更新和容量治理。否则它们既可能长期保存陈旧数据,也可能持续占用内存。
按自己的节奏,确认真正理解。