
Redis 与缓存 / 系统课时
理解集群故障转移
理解集群故障转移
Redis Cluster 的故障转移不是“副本发现主节点断线就立即接管”。它先由集群形成失败共识,再由副本发起选举,最后用新的配置纪元接管原主节点的槽位。本课把这条链路串起来,并用命令验证接管结果。
学习目标
- 区分主观下线
PFAIL与客观下线FAIL - 理解副本选举、配置纪元和槽位接管的关系
- 能通过
CLUSTER NODES验证故障转移是否完成
从怀疑下线到确认故障
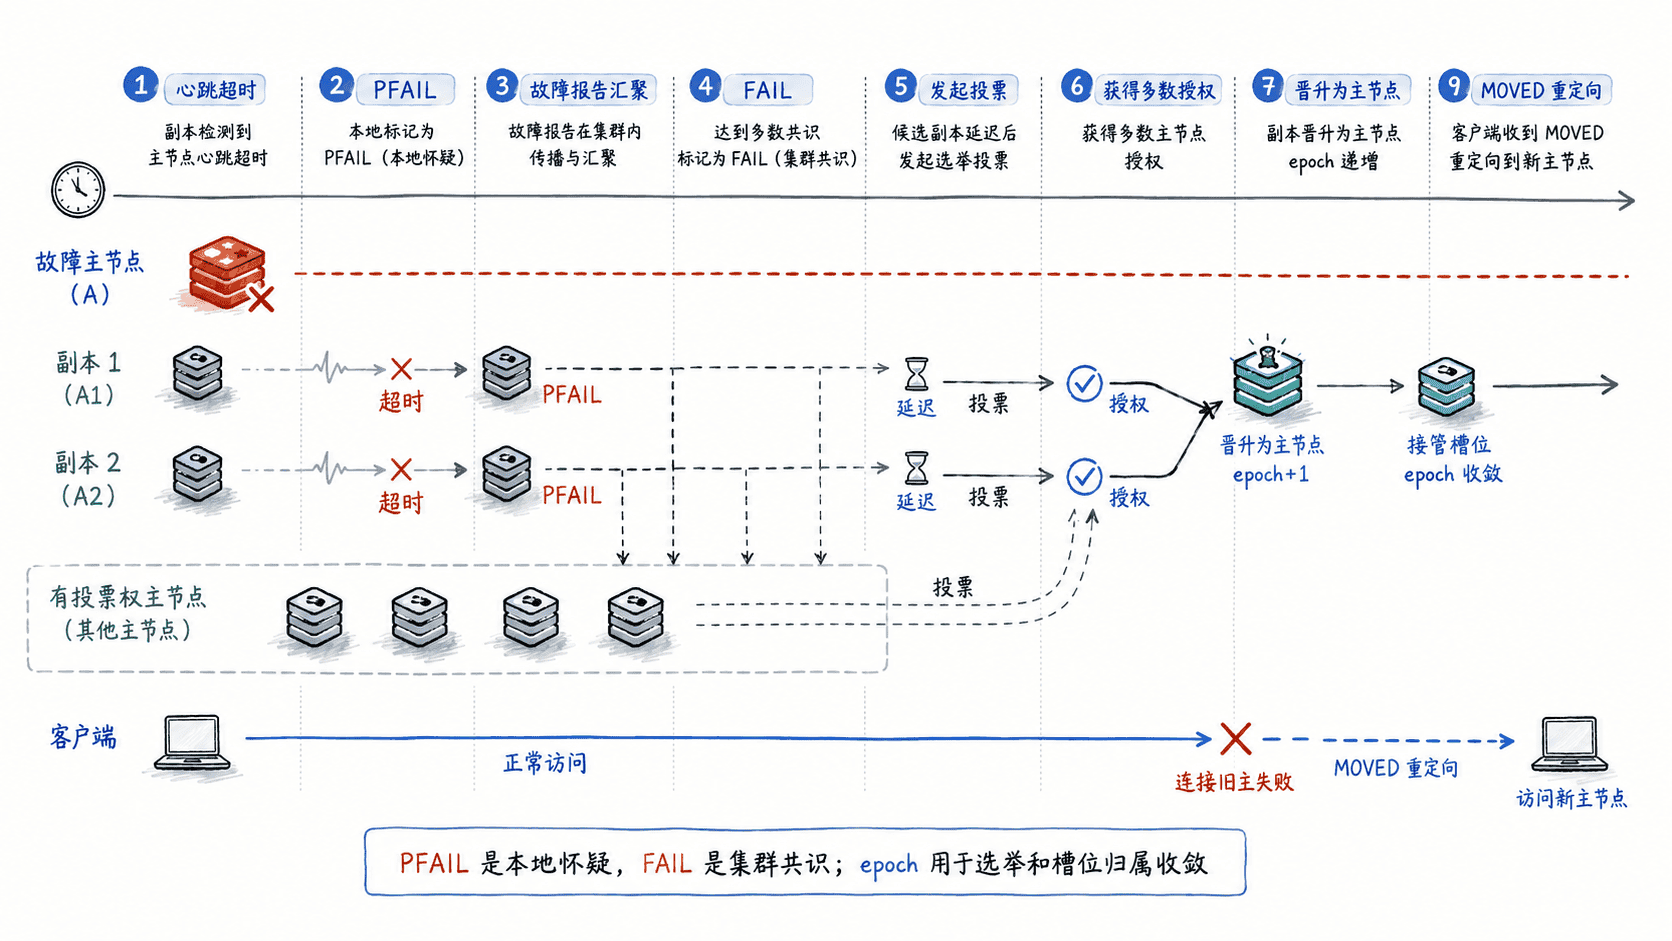
每个节点都会通过 Cluster Bus 与其他节点交换心跳。如果某节点在 cluster-node-timeout 窗口内没有得到目标节点的有效响应,它只会先把目标标记为 PFAIL,表示“我认为它可能不可达”。这仍然是单节点视角,不能直接触发主节点接管。
当负责槽位的主节点持续传播故障报告,并形成足够的多数派共识后,目标主节点才会被标记为 FAIL。这种设计避免某个节点因为短暂网络抖动就单方面宣布主节点失效,也让少数网络分区无法轻易产生两个同时对外提供同一批槽位的主节点。
副本如何赢得故障转移
主节点进入 FAIL 后,它的副本并不会同时晋升。候选副本会根据复制进度等因素错开发起时间,复制偏移量更新的副本通常更早参与选举。候选节点发出故障转移授权请求后,需要获得多数有投票权主节点的授权,才能完成晋升。
每轮选举都依赖递增的 epoch。主节点在同一轮里不会随意重复投票,晋升后的新主节点也会带着更新后的配置纪元声明自己拥有原主节点的槽位。若出现旧拓扑与新拓扑冲突,配置纪元更高的槽位归属会成为集群继续收敛的重要依据。
槽位怎样切到新主节点
副本晋升后,会把故障主节点原先负责的槽位声明为自己所有,并通过集群消息传播新的配置。其他节点更新槽位映射后,客户端访问这些槽位时会被重定向到新主节点。旧主节点如果之后恢复并重新加入集群,看到更新且更高的配置纪元后,通常会放弃旧槽位所有权并作为副本重新跟随当前主节点。
因此,“服务恢复”不只等于某个副本变成 master。还要确认原槽位已经由新主节点声明、其他节点认同该映射,而且客户端能够根据新的 MOVED 信息刷新路由。
用命令观察一次自动故障转移
下面假设你有一个用于实验的 Redis Cluster,并且待测主节点至少有一个健康副本。先把两个 <PORT> 分别替换为故障主节点端口和任意仍在线节点端口,并把 <VALUE> 设置为大于故障检测与选举所需时间的秒数。SHUTDOWN NOSAVE 会停止实例,只应在实验环境执行。
MASTER_PORT=<PORT>
PEER_PORT=<PORT>
WAIT_SECONDS=<VALUE>

redis-cli -p $MASTER_PORT CLUSTER NODES
redis-cli -p $MASTER_PORT SHUTDOWN NOSAVE || true
sleep $WAIT_SECONDS
redis-cli -p $PEER_PORT CLUSTER NODES
预期输出
# 故障前可看到原主节点及其副本
<ID> <IP>:<PORT>@<PORT> master - ... connected 0-5460
<ID> <IP>:<PORT>@<PORT> slave <ID> ... connected

# 故障转移完成后,某个原副本会成为 master,并继续声明原槽位
<ID> <IP>:<PORT>@<PORT> master - ... connected 0-5460
<ID> <IP>:<PORT>@<PORT> master,fail - ... disconnected
节点 ID、时间戳、端口、地址和配置纪元会因环境而不同;真正需要核对的是角色是否从副本变为主节点,以及原主节点的槽位范围是否出现在新主节点行上。
自动切换失败时先看什么
如果主节点已经不可达却迟迟没有新主节点,优先检查三件事:是否存在健康且复制状态足够新的副本、集群中是否仍有多数有投票权主节点可以完成授权、节点间 Cluster Bus 是否双向可达。少数分区即使仍包含业务数据,也可能因为拿不到多数票而无法完成故障转移,这是 Redis Cluster 用可用性换取槽位单一所有权的一部分。
cluster-node-timeout 只影响故障检测与相关超时节奏,不应该通过盲目调小来追求“秒切”。稳定的网络、足够的副本和清晰的多数派边界,才是故障转移能够可靠完成的前提。