
Redis 与缓存 / 系统课时
识别热键
识别热键
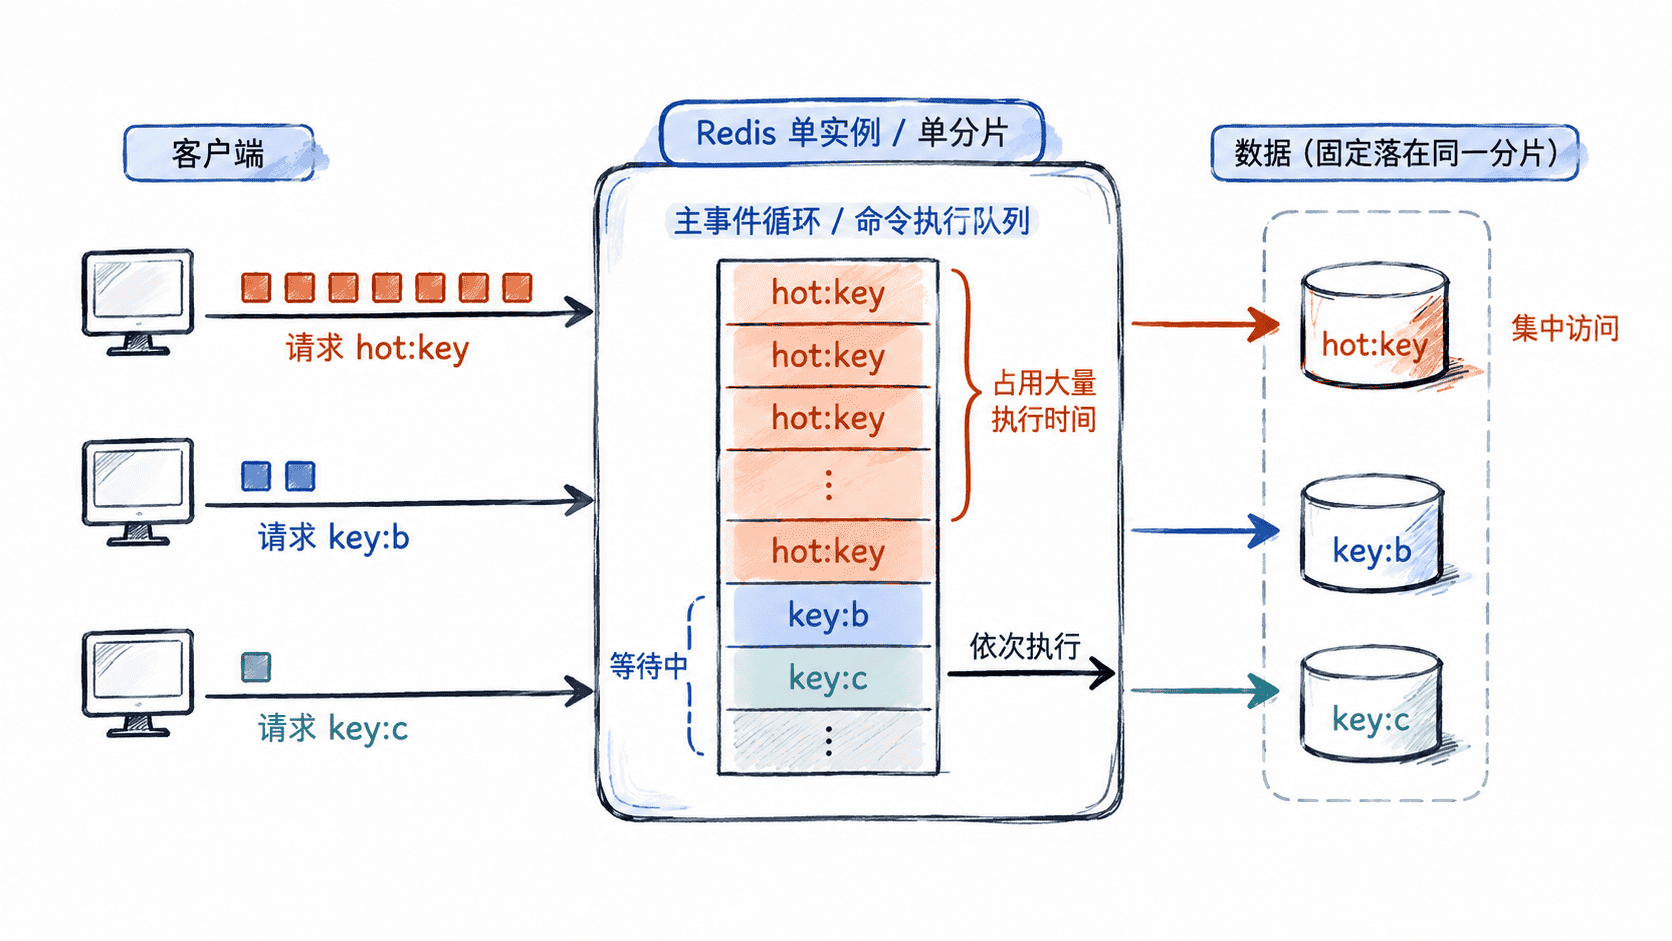
热键不是“占内存最大的键”,而是短时间内承受远高于其他键访问量的键。本篇用可操作的检查顺序定位热键,并把它与 Redis 主线程命令执行、单分片 CPU 和延迟抖动联系起来。
学习目标
- 区分热键与大键,理解访问集中为何会放大单分片负载
- 使用 LFU 频率信息和
redis-cli --hotkeys找出高频键 - 知道何时停止采样,以及如何验证治理是否有效
从症状判断是不是热键
Redis 的命令执行主要由事件循环串行推进。即使客户端很多,请求最终仍会在对应实例或分片上争用执行时间;集群中一个键也只属于一个哈希槽和对应分片。因此,大量请求集中到一个键时,常见表现是某个实例或分片 CPU 明显偏高,同时其他无关命令的延迟也上升。
热键关注的是访问频率与单位时间负载,大键关注的是单个键占用的内存或单次操作的数据量。一个只有几十字节的计数器可能是热键,一个几百 MB 但很少访问的对象则可能只是大键,两者要分别排查。
用 LFU 频率扫描定位候选键
redis-cli --hotkeys 会扫描键空间并读取 LFU 频率计数,因此只有在 maxmemory-policy 已经是 allkeys-lfu 或 volatile-lfu 时才能工作。不要为了临时排障就在生产环境随意改淘汰策略;策略变化会影响内存达到上限后的淘汰行为。
先确认策略,再扫描指定前缀。下面假设当前实例本来就使用 LFU:
redis-cli -h <HOST> -p <PORT> --raw CONFIG GET maxmemory-policy
redis-cli -h <HOST> -p <PORT> --hotkeys --pattern 'cache:*'
预期输出:
maxmemory-policy
allkeys-lfu
<扫描进度>
<若干热键候选及其 LFU counter>
-------- summary -------
Sampled <VALUE> keys in the keyspace!
<按频率列出的热键摘要>
实际键名、计数和扫描数量会不同。LFU counter 是经过对数增长和时间衰减的近似频率,不等于“最近一秒请求次数”,所以它适合筛候选,不适合直接当 QPS 指标。
把候选键和真实负载对上
发现候选键后,需要确认它是否真的解释了 CPU 或延迟异常。重点对齐三个维度:异常发生的时间窗口、命令类型,以及命中键所在实例或分片。若应用侧能提供按业务操作聚合的请求量、耗时或缓存命中指标,应优先与 Redis 的 CPU、延迟监控交叉验证。
还要检查候选键上的命令复杂度。高频 GET 与高频执行大范围 ZRANGE、大型 Hash 操作的成本不同;同一个热键如果同时是大键,风险会叠加,不能只做“降低访问次数”而忽略单次命令成本。
治理后再验证
只读热键常见做法是增加应用本地短 TTL 缓存、把可复制的数据分散为多个逻辑键,或重新设计访问路径。写热键更难水平拆分,因为多个副本会引入一致性问题,通常要从业务聚合方式、批处理或写入模型入手。
治理完成后,在相同流量条件下重新观察原分片 CPU、命令延迟和候选键频率。如果热点只是从一个键转移到另一个键,说明问题尚未解决;真正有效的结果应是访问集中度下降,同时实例或分片的高延迟窗口收窄。