
Redis 与缓存 / 系统课时
理解复制延迟
理解复制延迟
本课解决“主节点已经写入,副本为什么还读不到”的问题。你将从网络、主节点阻塞、同步过程和副本处理能力四个方向定位延迟,并建立可执行的检查顺序。
学习目标
- 识别复制延迟的主要来源
- 使用链路状态与偏移量判断进度
- 根据根因选择修复措施
延迟是怎样产生的
Redis 复制通常是异步的。主节点完成写命令后会尽快把复制流发送给副本,但不会等待所有副本执行完再向客户端返回,因此副本天然可能短暂落后。
网络抖动会延迟传输;主节点执行大命令或长 Lua 脚本会阻塞命令传播;全量同步会占用 CPU、内存、磁盘和带宽;副本资源不足则会减慢接收与执行。
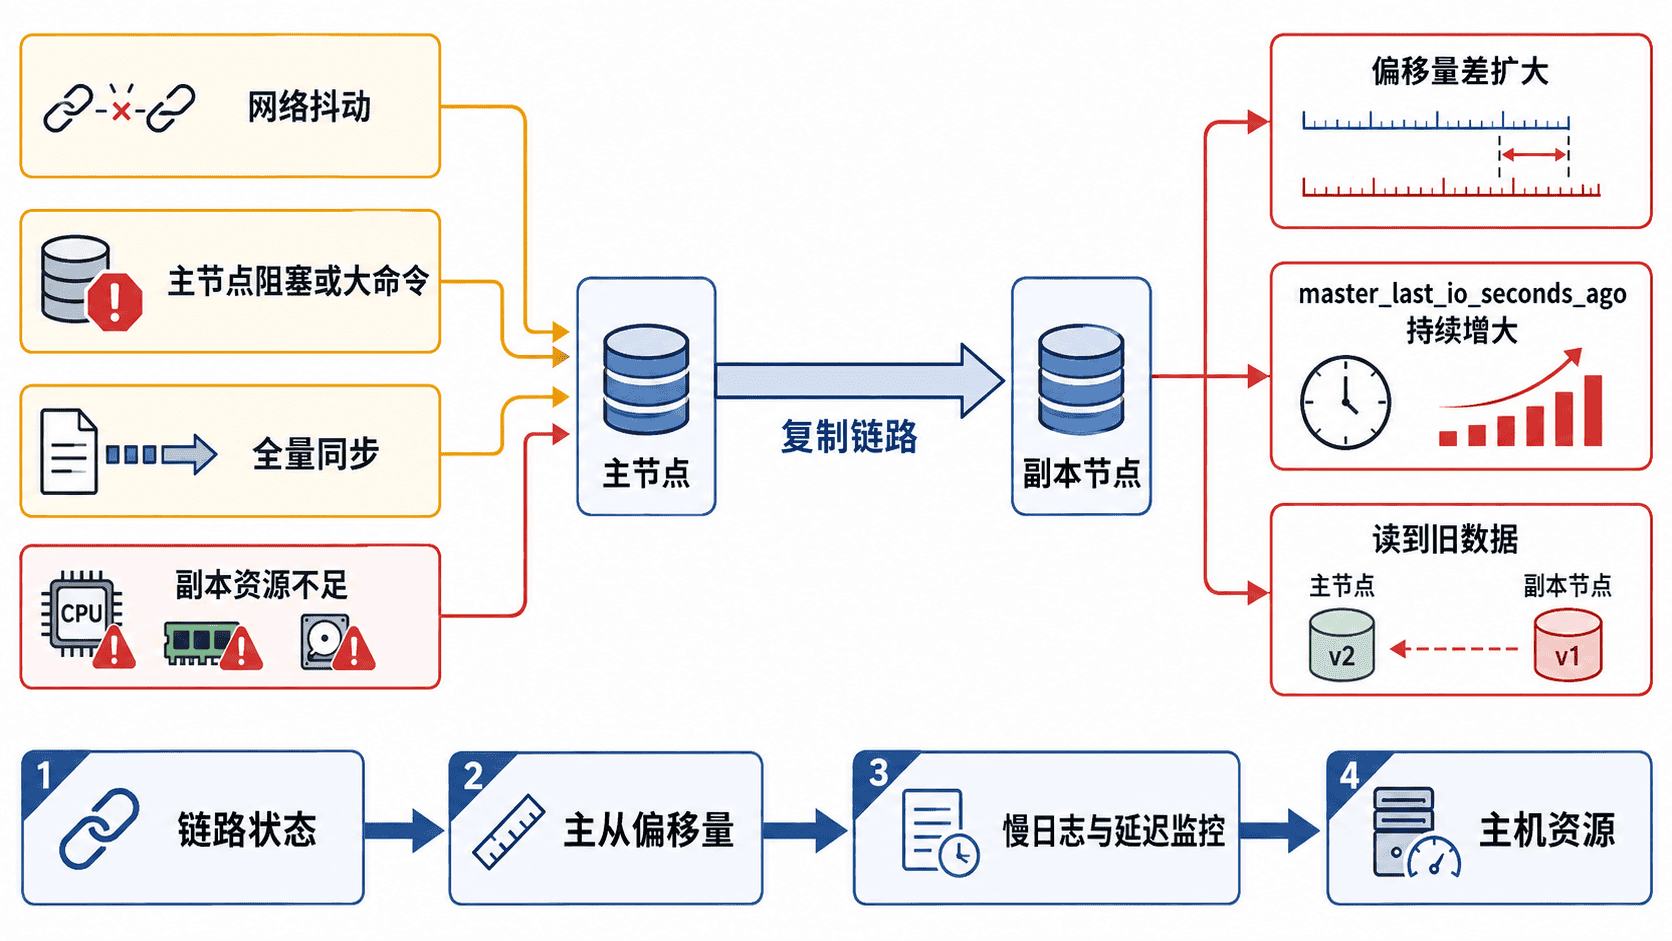
先检查链路和偏移量
下面脚本读取主从偏移量并计算差值。偏移量单位是复制流字节,不是业务记录数。
bash
master_offset=$(redis-cli --raw -p 6379 INFO replication | awk -F: '/^master_repl_offset:/{sub(/\r$/,"",$2); print $2}')
replica_offset=$(redis-cli --raw -p 6380 INFO replication | awk -F: '/^slave_repl_offset:/{sub(/\r$/,"",$2); print $2}')
redis-cli --raw -p 6380 INFO replication | grep -E "^(master_link_status|master_last_io_seconds_ago):"
printf 'master_offset=%s\nreplica_offset=%s\nlag_bytes=%s\n' \
  "$master_offset" "$replica_offset" "$((master_offset - replica_offset))"
预期输出结构如下,数值会随写入变化:
text
master_link_status:up
master_last_io_seconds_ago:<SECONDS>
master_offset:<MASTER_OFFSET>
replica_offset:<REPLICA_OFFSET>
lag_bytes:<BYTES>
链路应保持 up。一次采样的差值只能说明当前状态;连续采样时 <BYTES> 持续扩大,才表示副本长期追赶不过来。
检查阻塞与延迟记录
先查看慢日志数量,再确认延迟监控是否启用:
bash
redis-cli -p 6379 SLOWLOG LEN
redis-cli -p 6379 CONFIG GET latency-monitor-threshold
预期输出结构:
text
(integer) <SLOWLOG_COUNT>
1) "latency-monitor-threshold"
2) "<THRESHOLD_MS>"
<SLOWLOG_COUNT> 大于 0 时,可继续执行 SLOWLOG GET 5 查看最近慢命令。<THRESHOLD_MS> 为 0 表示延迟监控未启用,此时 LATENCY DOCTOR 不会提供有效诊断;生产环境应先评估阈值,再通过配置文件持久化启用。
按根因修复
网络问题应检查丢包、带宽、跨地域链路和防火墙;主节点阻塞应拆分大 key、避免 KEYS 等高风险操作,并限制单次处理量;副本资源不足应提升 CPU、内存或磁盘性能。
一致性要求高的请求不应无条件读取副本。刚完成支付、库存扣减或权限变更后,可以短时间读取主节点,或用业务版本号判断副本数据是否已经追上。
按自己的节奏,确认真正理解。