
Redis 与缓存 / 系统课时
分批遍历 Hash
分批遍历 Hash
本课使用 HSCAN 通过游标分批读取大型 Hash。你将掌握完整扫描循环、MATCH 与 COUNT 的真实作用,并能处理重复结果和扫描期间数据变化带来的弱一致性问题。
学习目标
- 理解
HSCAN的游标迭代机制 - 使用
MATCH和COUNT控制扫描过程 - 正确处理重复项与并发修改
游标迭代机制
HSCAN key cursor 每次返回下一游标和一批字段值。首次调用传入游标 0;后续继续传入上次返回的游标;当返回游标再次变为 0 时,本轮扫描结束。
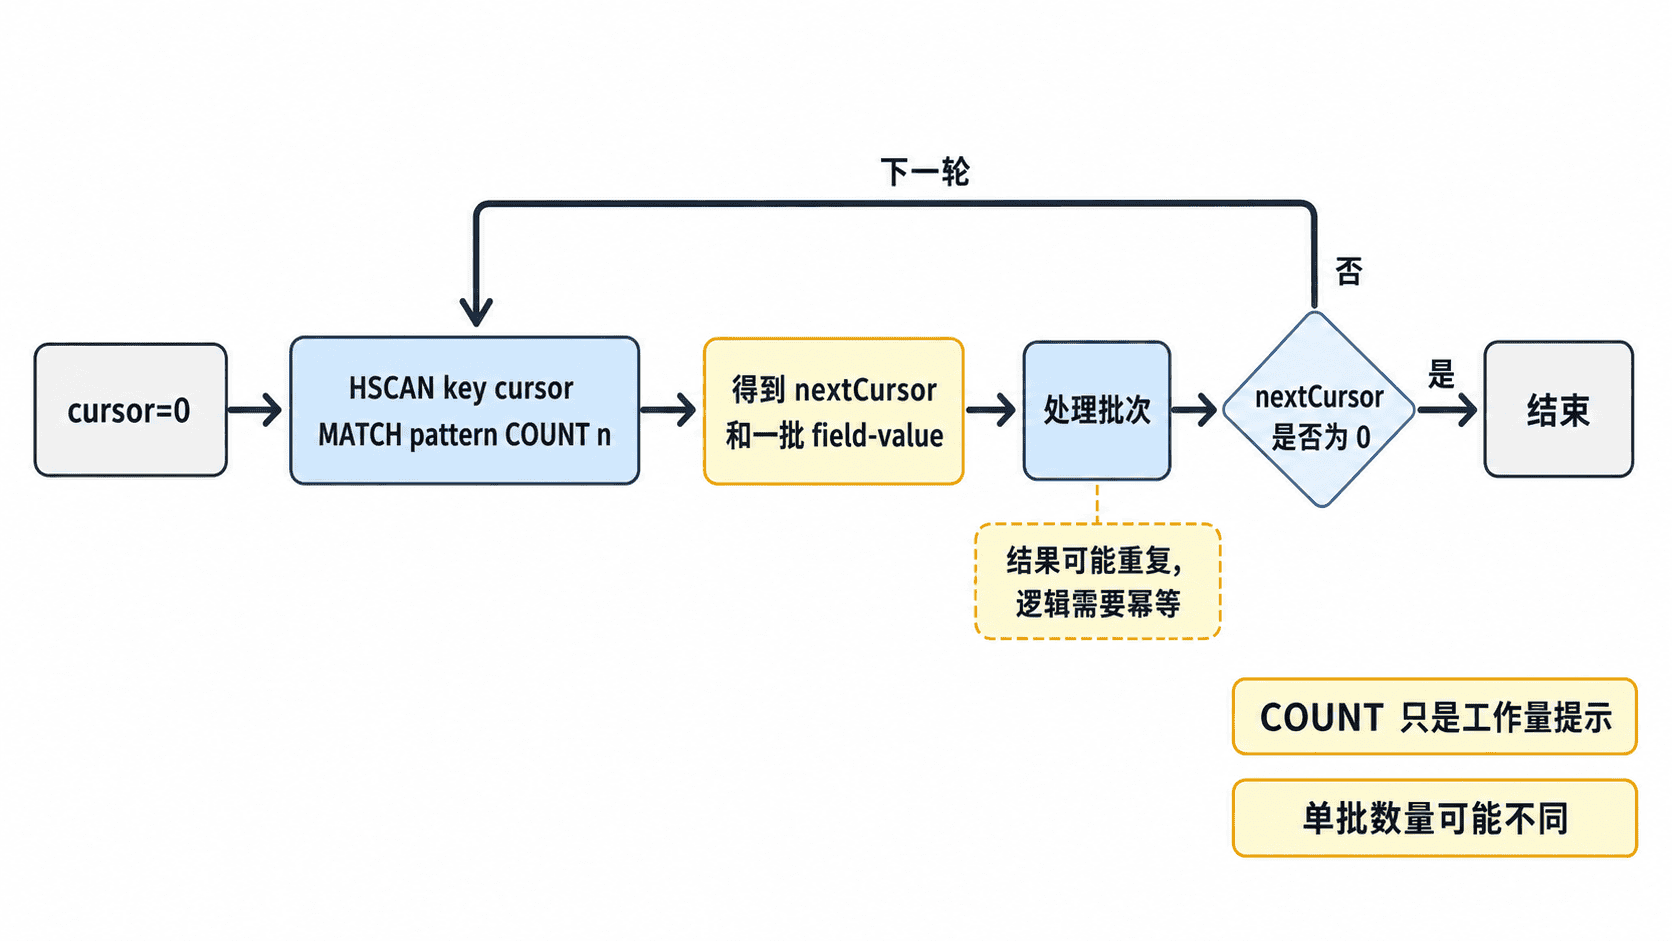
COUNT 是每轮扫描工作量的提示,不保证精确返回指定数量。MATCH 用于过滤返回字段,但 Redis 仍可能扫描不匹配的数据,因此它不能等同于数据库索引查询。
完整遍历示例
下面使用 redis-py 创建五个字段,再循环调用 hscan。示例最终校验完整结果,不依赖每一轮返回多少字段;使用字典汇总也能自然覆盖可能出现的重复字段。
python
from redis import Redis

client = Redis(host="localhost", port=6379, decode_responses=True)
key = "inventory:demo"

client.delete(key)
client.hset(
    key,
    mapping={
        "sku:1": 10,
        "sku:2": 20,
        "sku:3": 30,
        "sku:4": 40,
        "sku:5": 50,
    },
)

cursor = 0
all_items: dict[str, str] = {}

while True:
    cursor, batch = client.hscan(
        key,
        cursor=cursor,
        match="sku:*",
        count=2,
    )
    all_items.update(batch)
    if cursor == 0:
        break

print(len(all_items))
print(sorted(all_items.items()))
预期输出
text
5
[('sku:1', '10'), ('sku:2', '20'), ('sku:3', '30'), ('sku:4', '40'), ('sku:5', '50')]
运行前需要可访问的 Redis 服务和 redis Python 包。示例使用本机默认端口 6379;实际主机、端口、认证和 TLS 配置可能不同。
一致性与重复处理
HSCAN 提供弱一致性遍历。扫描期间新增、删除或修改字段时,变化项是否被看到并不确定,同一字段也可能重复返回,因此处理逻辑应幂等,不能假设每个字段恰好出现一次。
如果任务要求某个时点的稳定快照,应使用版本边界、复制数据或从支持一致性读取的持久化存储中获取。HSCAN 更适合清理、统计、迁移和后台巡检,不适合强一致交易判断。
按自己的节奏,确认真正理解。