
Redis 与缓存 / 系统课时
处理缓存雪崩
处理缓存雪崩
本课解决大量缓存同时失效或 Redis 短时不可用时,请求集中压向数据库的问题。你将通过随机过期、分批预热、请求合并、限流和降级,把集中回源拆成数据库可承受的小流量。
学习目标
- 区分集中失效与 Redis 故障两类雪崩
- 使用随机 TTL 打散回源时间
- 建立限流、降级和恢复保护
雪崩链路
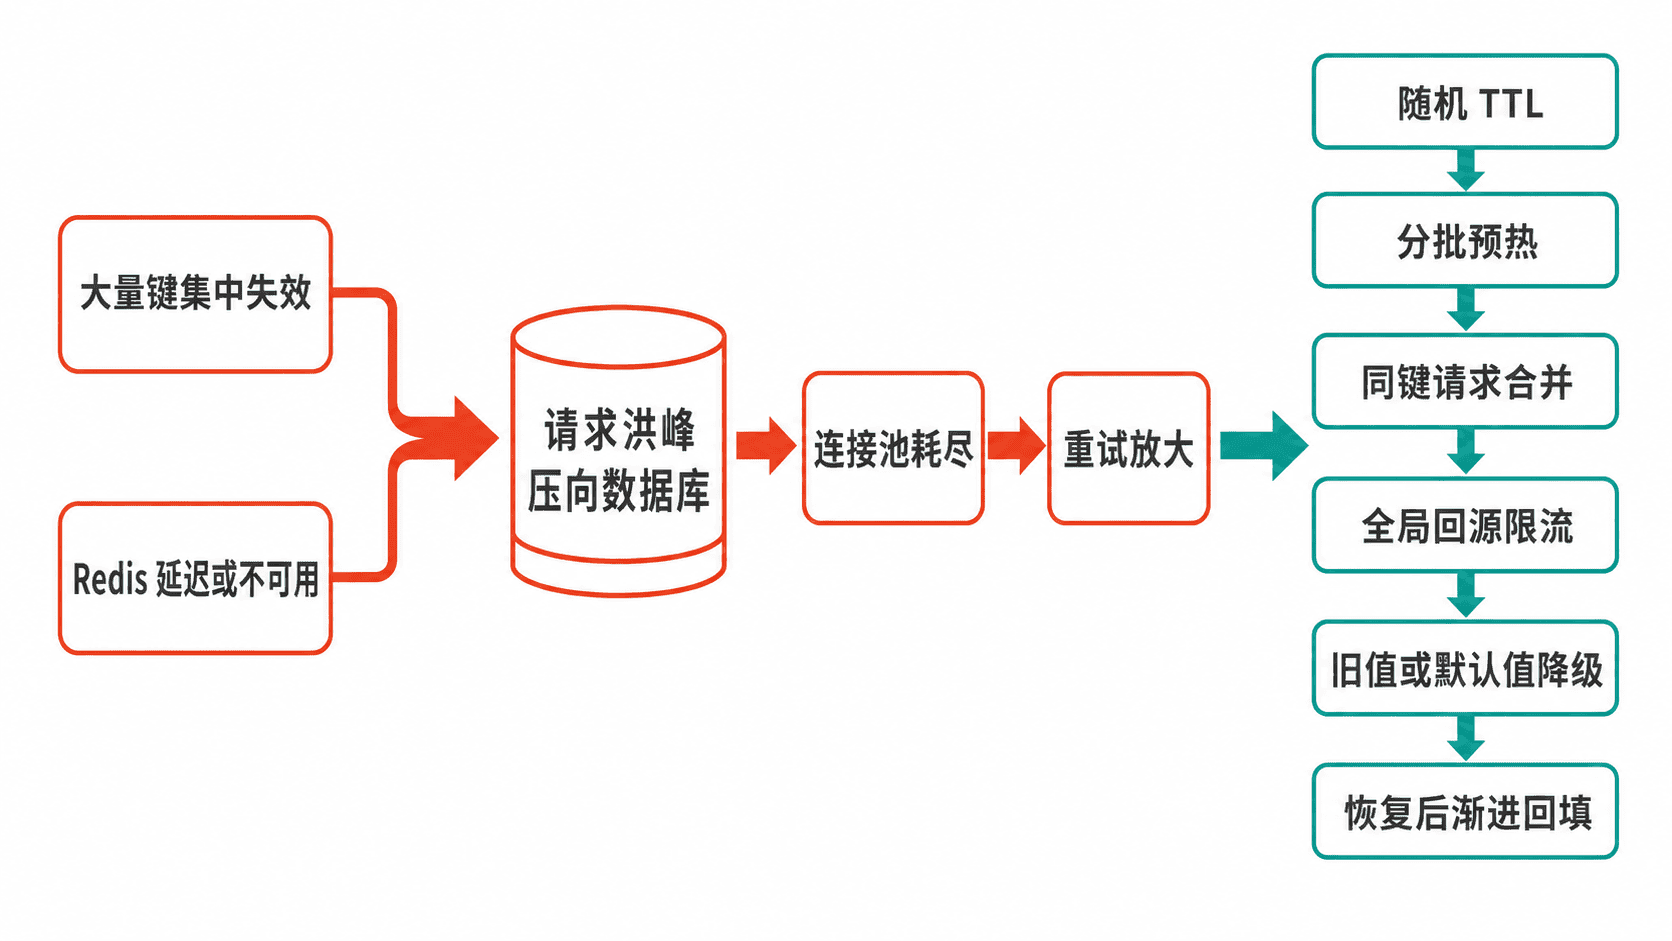
大量键使用相同 TTL 时,可能在同一时刻失效。请求随后绕过 Redis,快速消耗数据库连接池;接口超时又触发客户端重试,最终形成级联故障。Redis 网络故障、节点切换或整体延迟升高,也会产生类似结果。
打散过期时间
在基础 TTL 上增加随机抖动,可以避免同一批数据整齐过期。下面的 Bash 示例默认连接本机 Redis,为商品缓存设置 1800 到 2099 秒的 TTL。
set -euo pipefail

base_ttl=1800
jitter=$((RANDOM % 300))
ttl=$((base_ttl + jitter))

redis-cli --raw SET cache:product:1001 '{"id":1001}' EX "$ttl"
redis-cli --raw TTL cache:product:1001
预期输出:
OK
<TTL_SECONDS>
<TTL_SECONDS> 通常位于 1800 到 2099 之间,并会因执行耗时略有减少。抖动范围应根据键数量、数据库承载能力和数据新鲜度确定。
控制回源并发
发布或促销前应按分区和优先级分批预热,不能一次加载全部数据。缓存未命中时,可以合并同一键的并发请求,并用信号量或限流器约束全局数据库回源并发。
Redis 超时后也不能让所有请求直接访问数据库。非核心请求可以返回短期旧值、默认值或繁忙提示;核心请求只能在数据库安全阈值内回源,超过阈值应快速失败。
区分两类故障
集中失效主要通过随机 TTL、分批预热和互斥重建解决。Redis 整体故障则需要短超时、熔断、旧值兜底和全局回源限流。只增加 TTL 抖动,无法处理 Redis 节点不可用。
客户端重试也必须受控。无上限重试会放大流量,应限制次数、增加退避,并确保总等待时间不超过接口超时预算。
恢复与验证
Redis 恢复后应先少量探测,再逐步放量和分批回填,防止恢复瞬间出现二次雪崩。压测应覆盖批量过期、Redis 高延迟和节点不可用,并观察数据库 QPS、连接池等待、回源并发与重试量。
验收重点不是“请求全部成功”,而是故障期间数据库没有超过安全水位,核心接口可控降级,恢复后指标平稳回落。