
Redis 与缓存 / 系统课时
使用 Pipeline 批量发送命令
使用 Pipeline 批量发送命令
本课解决批量执行大量 Redis 命令时网络往返过多的问题。你将使用 Pipeline 一次发送多条命令、按加入顺序读取结果,并理解它只优化传输效率,不会为命令组提供原子性。
学习目标
- 理解 Pipeline 如何减少网络往返
- 使用 redis-py 批量执行读写命令
- 控制批次大小并正确处理逐条结果
Pipeline 优化的是什么
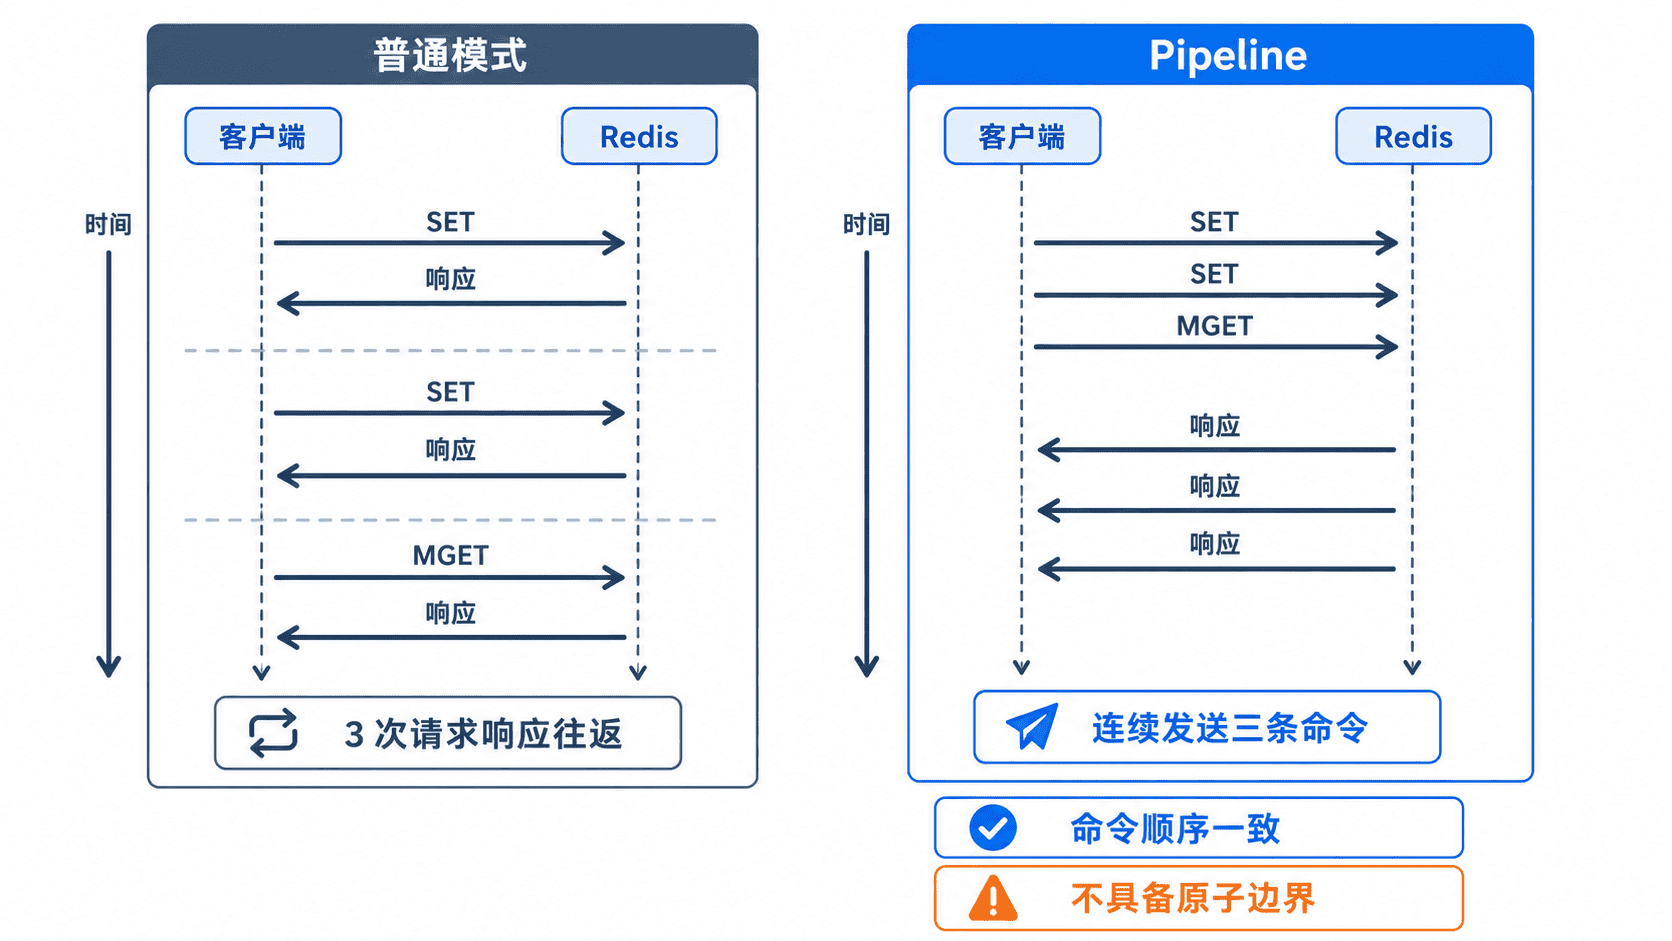
普通模式下,客户端通常发送一条命令并等待一次响应,执行 N 条命令会产生接近 N 次网络往返。Pipeline 允许客户端连续写入多条命令,再集中读取响应,主要节省等待时间。
Pipeline 不会把多条命令合并成一条 Redis 命令,也不会自动启用 MULTI/EXEC。同一连接中的响应顺序与命令发送顺序一致,但其他客户端仍可能在这批命令之间执行操作,因此不能依赖它保护跨命令约束。
使用 redis-py 执行批量命令
将以下代码保存为 pipeline_demo.py。示例显式设置 transaction=False,表示只使用 Pipeline,不启用事务。
import os
from redis import Redis

client = Redis(
    host=os.getenv("REDIS_HOST", "127.0.0.1"),
    port=int(os.getenv("REDIS_PORT", "6379")),
    decode_responses=True,
)

pipe = client.pipeline(transaction=False)
pipe.set("user:1:name", "Alice")
pipe.set("user:2:name", "Bob")
pipe.mget(["user:1:name", "user:2:name"])

results = pipe.execute()
print(results)
安装依赖并运行程序:
python -m pip install redis
python pipeline_demo.py
预期输出
[True, True, ['Alice', 'Bob']]execute() 返回的列表与命令加入 Pipeline 的顺序一致。前两个 True 对应两次 SET,最后一个列表对应 MGET。
控制批次大小
Pipeline 会在客户端暂存待发送命令,并在客户端和服务端短时间积累响应。一次加入过多命令会抬高内存峰值、延长连接占用时间,并影响其他请求延迟。
工程中可先按每批 100 到 1000 条执行,再根据命令大小、网络延迟和实例负载压测调整。批次并非越大越好,目标是在吞吐量、单批延迟和内存占用之间取得平衡。
处理错误与结果
redis-py 默认调用 execute() 时,只要结果中存在命令错误就会抛出 ResponseError;已经发送到 Redis 的其他命令不会因此自动撤销。若业务需要逐项检查,可使用 execute(raise_on_error=False),此时错误会以异常对象出现在对应结果位置。
应同时记录命令索引、业务键和批次编号,才能把失败结果映射回原始任务。对于“读取余额后决定是否扣款”这类相互依赖的操作,不要用普通 Pipeline 代替原子方案,应选择 Lua 或带 WATCH 的事务重试。