
Redis 与缓存 / 系统课时
理解主从复制架构
理解主从复制架构
本课解决“为什么一个 Redis 实例不够用”的问题。你将看清主节点与副本节点之间的数据流向,理解读扩展和数据冗余的价值,并明确主从复制本身不负责自动故障转移。
学习目标
- 说清主节点与副本节点的职责
- 理解复制、读扩展和数据冗余之间的关系
- 判断主从复制能解决和不能解决的问题
架构中的两个角色
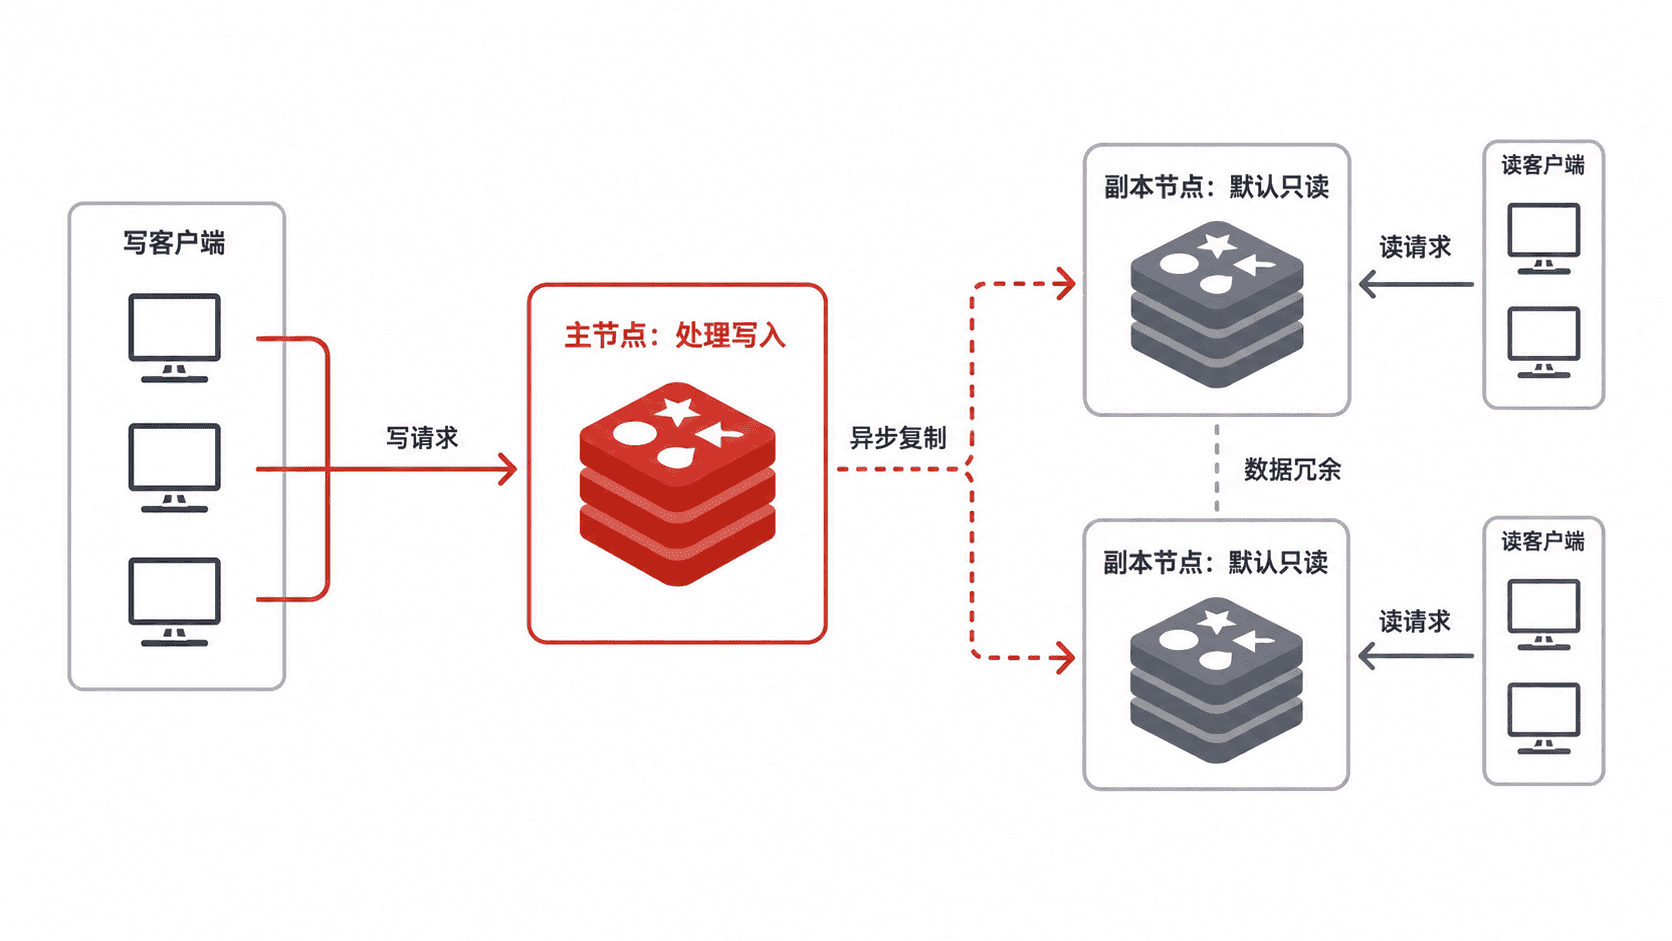
主节点通常接收写命令,并把复制流持续发送给副本节点。副本默认只读,用于保存数据副本,也可以承担读请求、备份或离线分析。
客户端不应把主从节点当成两个彼此独立的数据库。副本的数据来源是主节点;复制链路中断后,它会暂时停留在最后一次成功处理的复制位置。
读扩展与数据冗余
当业务读多写少时,可以让主节点负责写入,让副本分担读取,从而降低主节点查询压力。但应用必须接受副本可能短暂落后于主节点,刚写入的数据不一定能立即从副本读到。
副本还提供数据冗余。主节点故障时,副本通常保留了大部分数据,可被人工提升,或由 Sentinel 自动选为新主节点。由于复制通常是异步的,故障瞬间尚未到达副本的数据仍可能丢失。
用命令确认角色
下面分别查看主节点和副本节点的复制信息。示例假设主节点端口为 6379,副本端口为 6380。
bash
redis-cli -p 6379 INFO replication | grep -E "^(role|connected_slaves):"
redis-cli -p 6380 INFO replication | grep -E "^(role|master_host|master_port|master_link_status):"
预期输出如下;副本数量会随实际部署变化。
text
role:master
connected_slaves:<REPLICA_COUNT>
role:slave
master_host:127.0.0.1
master_port:6379
master_link_status:up
role 表示当前角色,master_link_status:up 表示副本与主节点的复制链路正常。Redis 文档已普遍使用 replica 一词,但部分命令输出仍保留 slave 字段名。
主从复制的能力边界
主从复制可以提高读取能力并保存冗余副本,但不会自动判断何时切换主节点,也不会自动通知普通客户端改连新地址。
因此,生产环境通常还需要 Sentinel、Redis Cluster 或外部编排系统完成故障检测、主节点选举和客户端地址更新。即使引入这些组件,也仍需处理复制延迟与少量数据丢失窗口。
按自己的节奏,确认真正理解。