
Redis 与缓存 / 系统课时
理解增量同步
理解增量同步
本课说明副本短暂断线后为什么不必总是重新传输全部数据。你将理解复制 ID、复制偏移量和复制积压缓冲区如何共同决定能否执行部分重同步。
学习目标
- 理解复制偏移量表示的数据位置
- 说明复制积压缓冲区的作用
- 判断断线重连何时可以部分重同步
三个关键状态
主节点维护复制 ID,用于标识当前复制历史;主节点与副本分别记录复制偏移量,用于表示复制流已经发送或处理到的位置;复制积压缓冲区保存最近一段复制数据。
副本重连时会携带自己记住的复制 ID 和偏移量。只有复制历史匹配,并且缺失区间仍保留在积压缓冲区中,主节点才可以从指定位置继续发送。
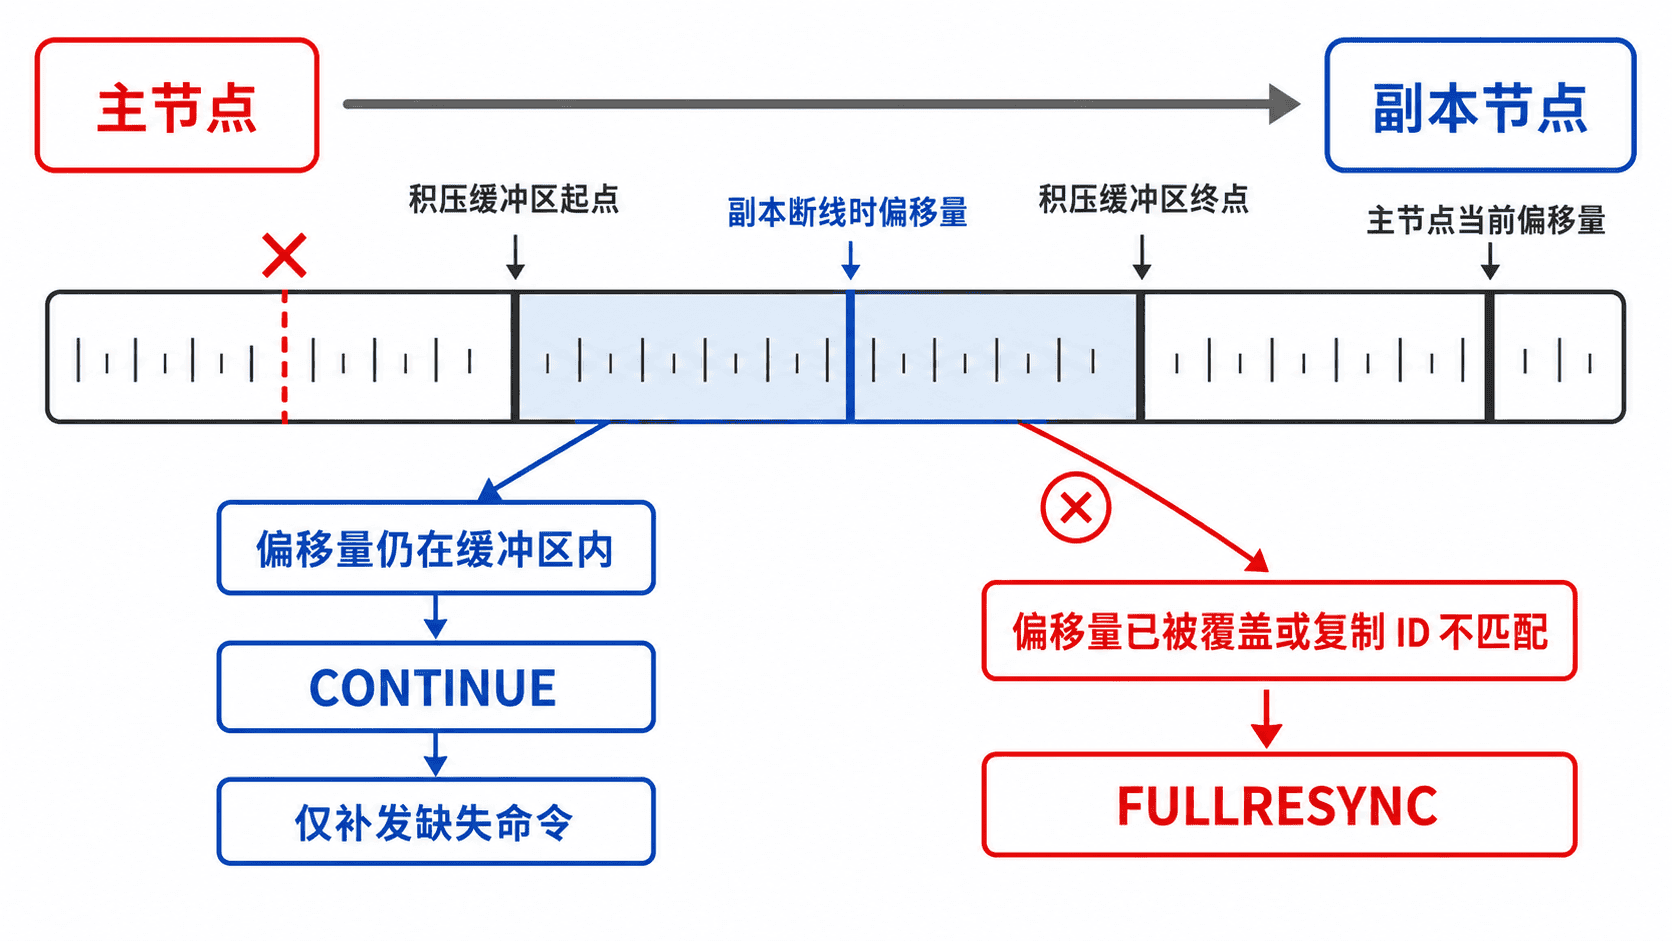
部分重同步的判断
假设副本在偏移量 1000 处断线,主节点继续处理写入并推进到 1300。如果积压缓冲区仍保存 1001 到 1300 的复制数据,主节点只需补发这一段。
如果写入速度很快,缓冲区起点已经推进到 1200,那么副本需要的 1001 到 1199 已不存在,只能退回全量同步。复制 ID 不匹配时,即使偏移量数值看起来接近,也不能直接续接。
查看复制状态
下面分别读取主节点与副本的复制 ID、偏移量和积压缓冲区状态。请在复制链路正常时执行。
bash
redis-cli -p 6379 INFO replication | grep -E "^(master_replid|master_repl_offset|repl_backlog_active|repl_backlog_size):"
redis-cli -p 6380 INFO replication | grep -E "^(master_replid|slave_repl_offset):"
预期输出结构如下,ID、偏移量和缓冲区大小会随环境变化:
text
master_replid:<REPLICATION_ID>
master_repl_offset:<MASTER_OFFSET>
repl_backlog_active:1
repl_backlog_size:<BYTES>
master_replid:<REPLICATION_ID>
slave_repl_offset:<REPLICA_OFFSET>
正常情况下,两个节点看到的复制 ID 应一致,副本偏移量会接近主节点偏移量。偏移量表示复制流中的字节位置,不等同于命令条数。
提高部分重同步成功率
复制积压缓冲区越大,通常能覆盖越长的断线时间,但会占用更多内存。配置时应结合复制流量、可接受断线时长和实例内存估算,而不是机械设置固定大值。
还要避免主从链路频繁抖动。稳定网络、合理超时和持续监控,往往比单纯扩大缓冲区更重要;若断线时间超过缓冲覆盖范围,仍会退化为全量同步。
按自己的节奏,确认真正理解。