
Redis 与缓存 / 系统课时
接入监控与告警
接入监控与告警
本课建立 Redis 的最小可观测闭环:采集实例指标,计算容量与命中率风险,并用分级告警把异常路由到正确的处理人员。
学习目标
- 识别 Redis 必须监控的核心指标
- 配置 Prometheus 告警规则
- 验证指标采集与规则文件有效性
设计监控链路
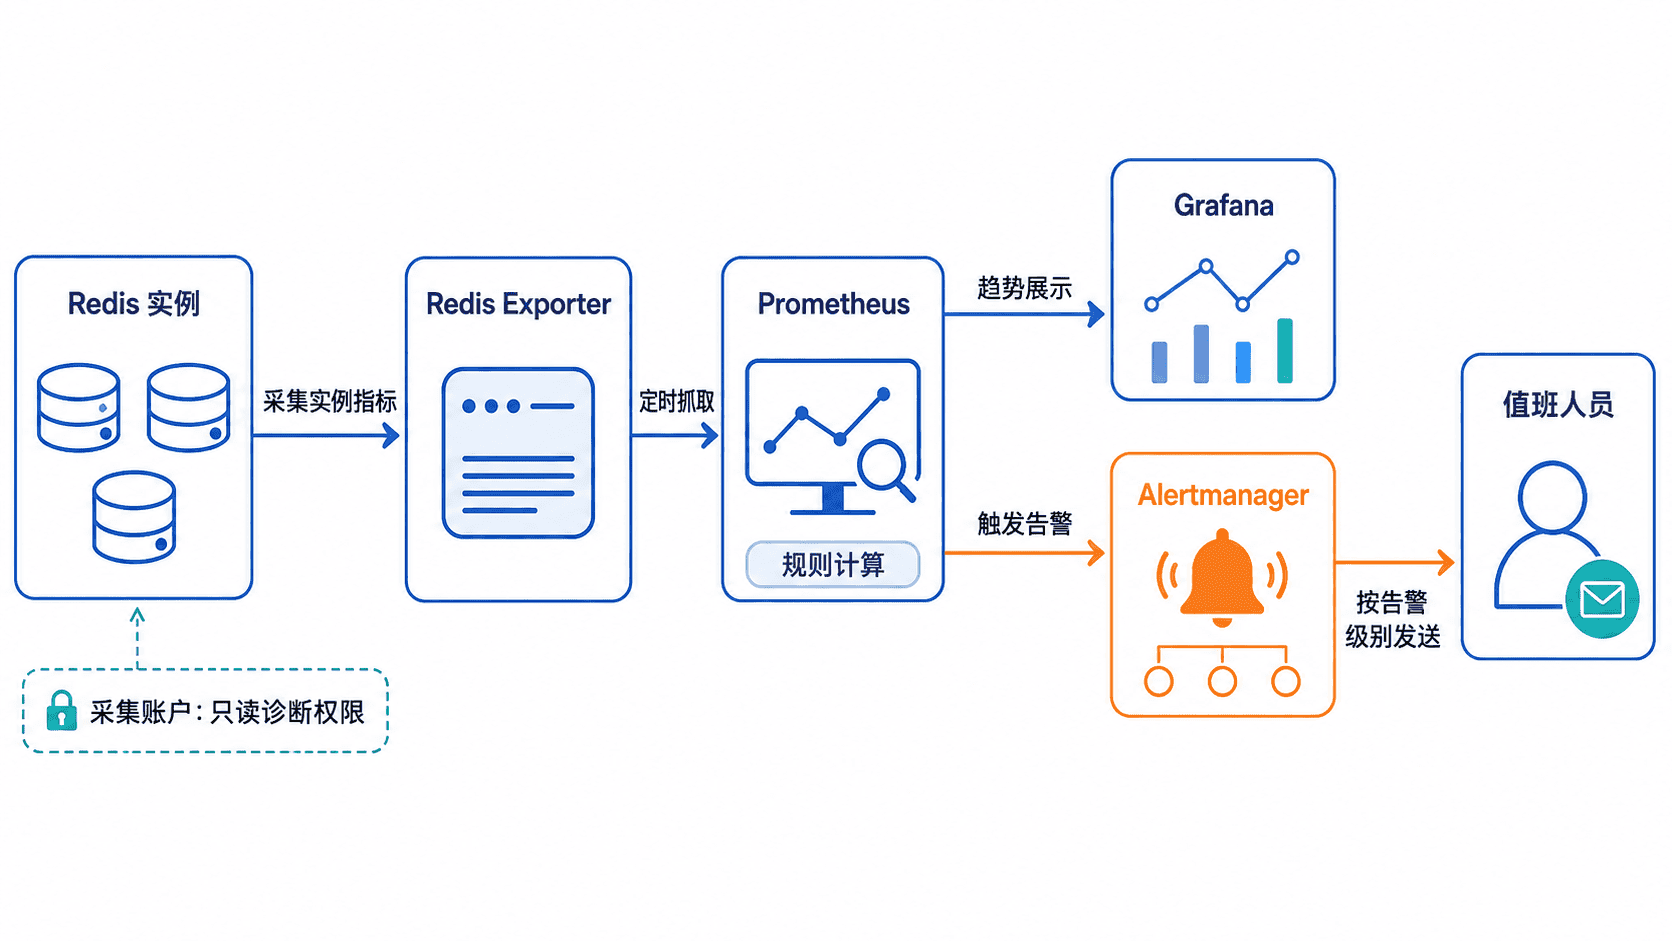
常见链路是 Redis Exporter 读取实例状态,Prometheus 定时抓取,Grafana 展示趋势,Alertmanager 发送告警。采集账户只需诊断相关命令,不应拥有业务键写权限。
选择核心指标
内存重点关注使用率、碎片率、淘汰量和拒绝写入;性能关注命令延迟、慢查询和 CPU;缓存效果关注命中率;连接关注当前连接数、拒绝连接数与阻塞客户端;高可用关注复制链路、复制延迟和 Sentinel 状态。
命中率可按 keyspace_hits / (keyspace_hits + keyspace_misses) 计算。低命中率不一定代表故障,应结合冷启动、访问模式、缓存穿透和回源压力判断。
配置告警规则
以下使用常见 redis_exporter 指标名,实际名称必须先从 /metrics 核对。阈值应根据容量基线和业务影响调整,不能直接照搬。
yaml
groups:
  - name: redis
    rules:
      - alert: RedisMemoryUsageHigh
        expr: redis_memory_max_bytes > 0 and redis_memory_used_bytes / redis_memory_max_bytes > 0.85
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Redis memory usage is above 85%"

      - alert: RedisReplicationDown
        expr: redis_master_link_up == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "Redis replica lost connection to master"

      - alert: RedisRejectedConnections
        expr: increase(redis_rejected_connections_total[5m]) > 0
        labels:
          severity: critical
        annotations:
          summary: "Redis rejected client connections"
告警标签还应包含实例、环境和责任团队,注解中补充处理手册链接,避免只发送一个无法定位的指标名。
验证采集与规则
先从 Redis 读取关键状态,再校验 Prometheus 规则文件。文件路径按实际部署替换。
bash
redis-cli -p 6379 INFO memory | grep -E '^(used_memory|maxmemory):'
redis-cli -p 6379 INFO stats | grep -E '^(keyspace_hits|keyspace_misses|rejected_connections):'
promtool check rules /etc/prometheus/rules/redis.yml
预期输出
text
used_memory:<BYTES>
maxmemory:<BYTES>
keyspace_hits:<COUNT>
keyspace_misses:<COUNT>
rejected_connections:<COUNT>
Checking /etc/prometheus/rules/redis.yml
  SUCCESS: 3 rules found
<BYTES> 和 <COUNT> 会随实例运行变化。若 promtool 校验成功但 Prometheus 没有加载规则,还要检查规则目录配置、Prometheus 日志和规则页面。
设置告警分级
容量接近上限、命中率持续下降可设为预警;复制中断、拒绝连接、持续高延迟应设为紧急告警。每条告警都要明确观察窗口、恢复条件和升级路径,并通过演练确认通知真正到达。
按自己的节奏,确认真正理解。