
Redis 与缓存 / 系统课时
执行故障转移演练
执行故障转移演练
本课在隔离的演练环境中停止 Redis 主节点,观察 Sentinel 的下线判定和从节点提升过程,并量化切换时间、数据影响与客户端恢复结果。
学习目标
- 按安全步骤执行主节点故障注入
- 测量故障转移时间与数据影响
- 验证客户端能自动恢复读写
明确演练边界
演练前确认环境、负责人、回滚方式和观察窗口,禁止在未审批的生产实例上直接停止服务。记录当前主节点、复制状态、应用错误率和最新写入序号,作为切换后的对照基线。
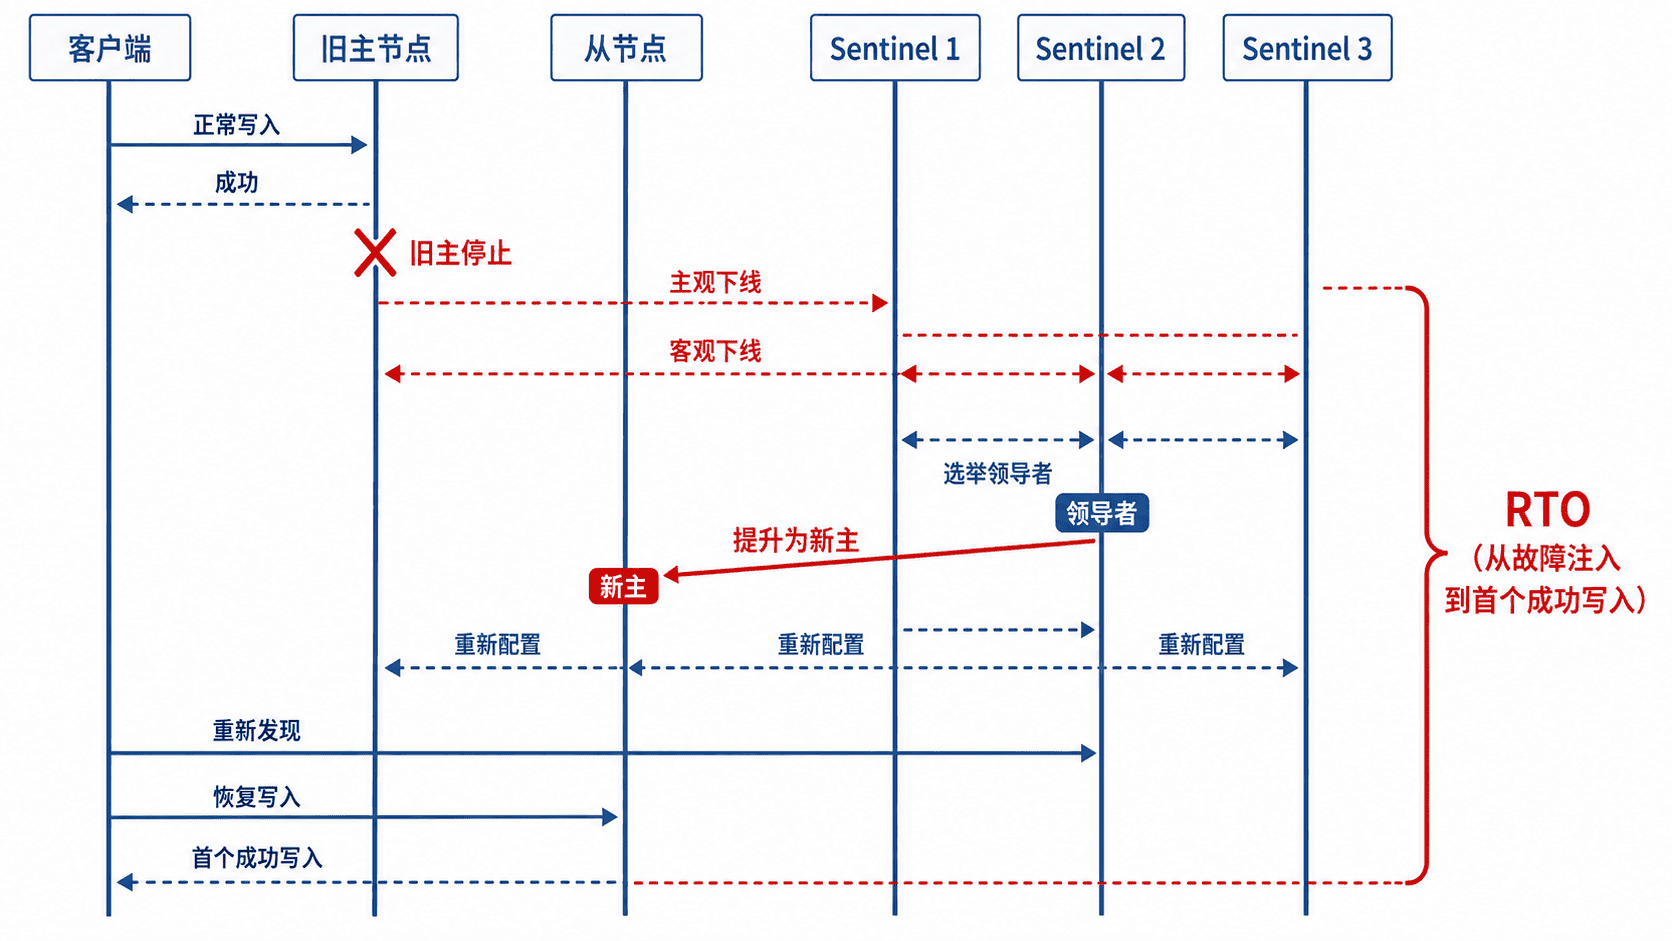
切换过程同时涉及客户端、旧主、从节点和多个 Sentinel,用时序图更容易对齐事件顺序与 RTO 统计区间。
执行主演练脚本
下面的脚本应在旧主节点主机上执行。它先写入基线序号,再停止旧主,轮询 Sentinel 返回的新主节点,并以首次成功写入作为恢复时刻。服务单元名和地址应按演练环境调整。
bash
set -euo pipefail

SENTINEL_HOST="10.0.0.13"
SENTINEL_PORT="26379"
MASTER_NAME="mymaster"
REPLICA_HOST="10.0.0.12"
REPLICA_PORT="6379"
REDIS_SERVICE="redis-server"

mapfile -t old_addr < <(
  redis-cli --raw -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" \
    SENTINEL get-master-addr-by-name "$MASTER_NAME"
)
OLD_HOST="${old_addr[0]}"
OLD_PORT="${old_addr[1]}"

echo "old-master=$OLD_HOST:$OLD_PORT"
redis-cli -h "$OLD_HOST" -p "$OLD_PORT" SET app:drill:seq 1001 >/dev/null

replica_baseline=""
for _ in $(seq 1 20); do
  replica_baseline=$(redis-cli --raw -h "$REPLICA_HOST" -p "$REPLICA_PORT" GET app:drill:seq)
  [[ "$replica_baseline" == "1001" ]] && break
  sleep 0.2
done

if [[ "$replica_baseline" != "1001" ]]; then
  echo "replication-baseline-failed"
  exit 1
fi

echo "replica-baseline=$replica_baseline"
start_epoch=$(date +%s)
sudo systemctl stop "$REDIS_SERVICE"

NEW_HOST=""
NEW_PORT=""

for _ in $(seq 1 90); do
  mapfile -t new_addr < <(
    redis-cli --raw -h "$SENTINEL_HOST" -p "$SENTINEL_PORT" \
      SENTINEL get-master-addr-by-name "$MASTER_NAME"
  )

  if [[ "${new_addr[0]:-}" != "$OLD_HOST" && -n "${new_addr[0]:-}" ]]; then
    if [[ "$(redis-cli --raw -h "${new_addr[0]}" -p "${new_addr[1]}" SET app:drill:after-failover ok 2>/dev/null || true)" == "OK" ]]; then
      NEW_HOST="${new_addr[0]}"
      NEW_PORT="${new_addr[1]}"
      break
    fi
  fi

  sleep 1
done

if [[ -z "$NEW_HOST" ]]; then
  echo "failover-timeout"
  exit 1
fi

recovered_epoch=$(date +%s)
echo "new-master=$NEW_HOST:$NEW_PORT"
echo "baseline-after-failover=$(redis-cli --raw -h "$NEW_HOST" -p "$NEW_PORT" GET app:drill:seq)"
echo "write-after-failover=$(redis-cli --raw -h "$NEW_HOST" -p "$NEW_PORT" GET app:drill:after-failover)"
echo "rto_seconds=$((recovered_epoch - start_epoch))"
预期输出
text
old-master=10.0.0.11:6379
replica-baseline=1001
new-master=10.0.0.12:6379
baseline-after-failover=1001
write-after-failover=ok
rto_seconds=<SECONDS>
<SECONDS> 取决于 down-after-milliseconds、Sentinel 选举、复制状态和客户端重连时间。若脚本输出 failover-timeout,应立即停止扩大演练范围,并检查 Sentinel 日志、quorum、网络和从节点可提升条件。
评估与恢复
RTO 应从故障注入开始,统计到新主节点首次成功完成业务读写,而不是只统计 Sentinel 地址变化。还要对比最后确认写入与新主数据,判断是否存在丢失,并核对客户端错误峰值、重连次数和请求重试是否造成重复写入。
旧主节点恢复后应先确认其角色和复制配置,再作为从节点重新加入,不能直接以主节点身份恢复流量。最后执行数据一致性检查,恢复监控与流量,并清理演练键。
按自己的节奏,确认真正理解。