
Redis 与缓存 / 系统课时
Redis 与关系型数据库的区别
Redis 与关系型数据库的区别
本课解决“Redis 能否替代 MySQL”这一常见误区。通过同一份用户资料的两种存储方式,对比数据模型、查询能力、事务语义、持久化目标和系统分工。
学习目标
- 对比 Redis 与关系型数据库的数据模型
- 理解两者在查询、事务和持久化上的差异
- 设计缓存与数据库的合理分工
数据模型不同
关系型数据库以表、行和列组织数据,依靠主键、索引、约束和关联表达业务关系。Redis 以键定位值,数据结构围绕具体操作设计。
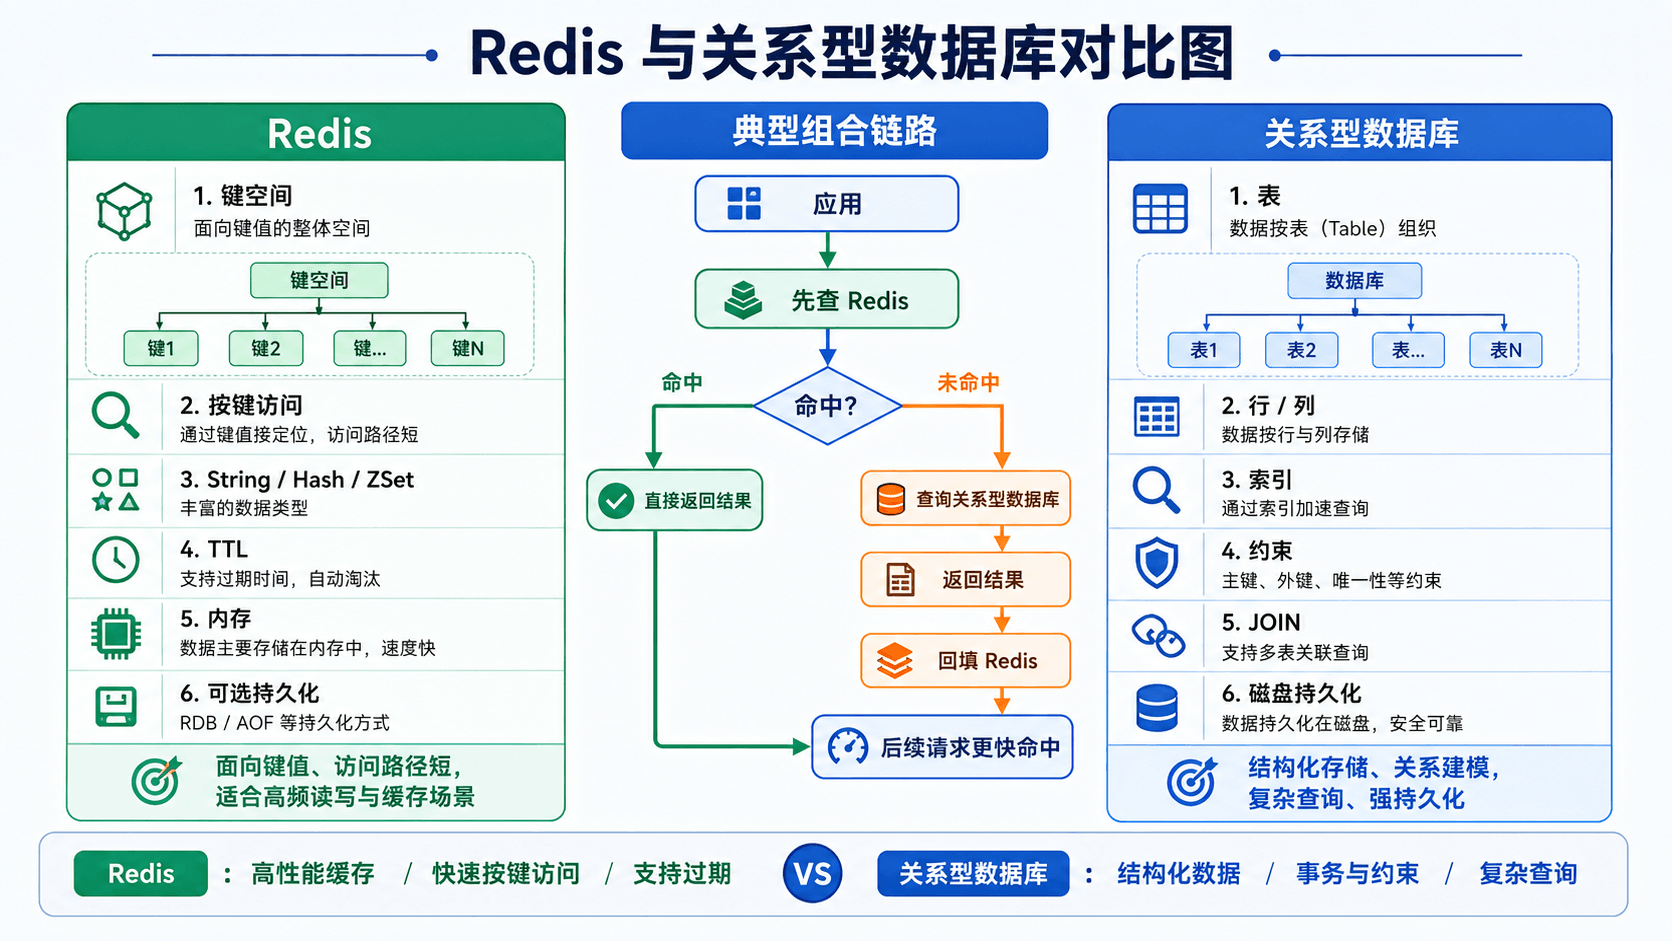
下面用同一条用户资料观察两种模型。Redis 通过哈希按键保存字段:
bash
redis-cli HSET user:1001 name Alice level 3
redis-cli HGETALL user:1001
预期输出
text
(integer) 2
1) "name"
2) "Alice"
3) "level"
4) "3"
关系型数据库则通过表结构、字段类型和约束保存同类数据:
sql
CREATE TABLE user_profile (
  user_id BIGINT PRIMARY KEY,
  name VARCHAR(50) NOT NULL,
  level INT NOT NULL
);

INSERT INTO user_profile (user_id, name, level)
VALUES (1001, 'Alice', 3);

SELECT user_id, name, level
FROM user_profile
WHERE user_id = 1001;
预期结果
text
+---------+-------+-------+
| user_id | name  | level |
+---------+-------+-------+
|    1001 | Alice |     3 |
+---------+-------+-------+
查询能力不同
Redis 最擅长已知键或明确数据结构下的操作,例如按用户 ID 获取资料、按分数读取排行榜。它不提供通用 JOIN,也不适合临时组合大量筛选条件。
关系型数据库可以通过 SQL 完成过滤、聚合、关联和排序,并由优化器选择执行计划。业务查询条件经常变化时,关系模型通常更自然。
事务与持久化目标不同
关系型数据库强调 ACID 事务、约束和多行一致性,适合订单、账户余额等核心事实数据。
Redis 的单条命令具有原子性,也支持 MULTI/EXEC、Lua 脚本和乐观锁,但事务队列不等同于关系型数据库事务。执行期错误不会自动回滚已经成功的命令,因此不能只看到“原子”就忽略业务一致性。
关系型数据库通常以持久化为基础设计恢复机制。Redis 以内存服务为主,通过 RDB 或 AOF 在性能与恢复点之间取舍,还要评估复制延迟、故障切换和允许丢失的数据窗口。
常见组合方式
典型架构是数据库保存权威数据,Redis 保存热点副本或派生状态。读取先查 Redis,未命中再查询数据库;写入先保证数据库成功,再按一致性策略删除或刷新缓存。
这种分工既利用 Redis 的低延迟,也保留关系型数据库的复杂查询、约束和事务能力。
按自己的节奏,确认真正理解。