
大模型原理与训练 / 系统课时
清洗数据并控制序列长度
清洗数据并控制序列长度
微调数据不仅要能读,还要避免重复、冲突、空回答和极端长样本吞噬训练预算。本节建立一条可复现的清洗链路,用 Chat Template 后的 token 数统计长度分布,再决定过滤还是截断。
学习目标
- 按稳定顺序处理空回答、重复样本和冲突样本。
- 基于真实训练序列的 token 分布选择长度上限。
- 区分过滤、语义截断和直接 token 截断的适用边界。
先定义清洗顺序
清洗顺序会影响最终数据量。先去掉目标答案为空的样本,再做完全重复去重;随后以除最后一条 assistant 答案外的上下文为键检测冲突,避免同一个输入同时对应互相矛盾的监督信号。最后再统计 token 长度并处理超长样本。
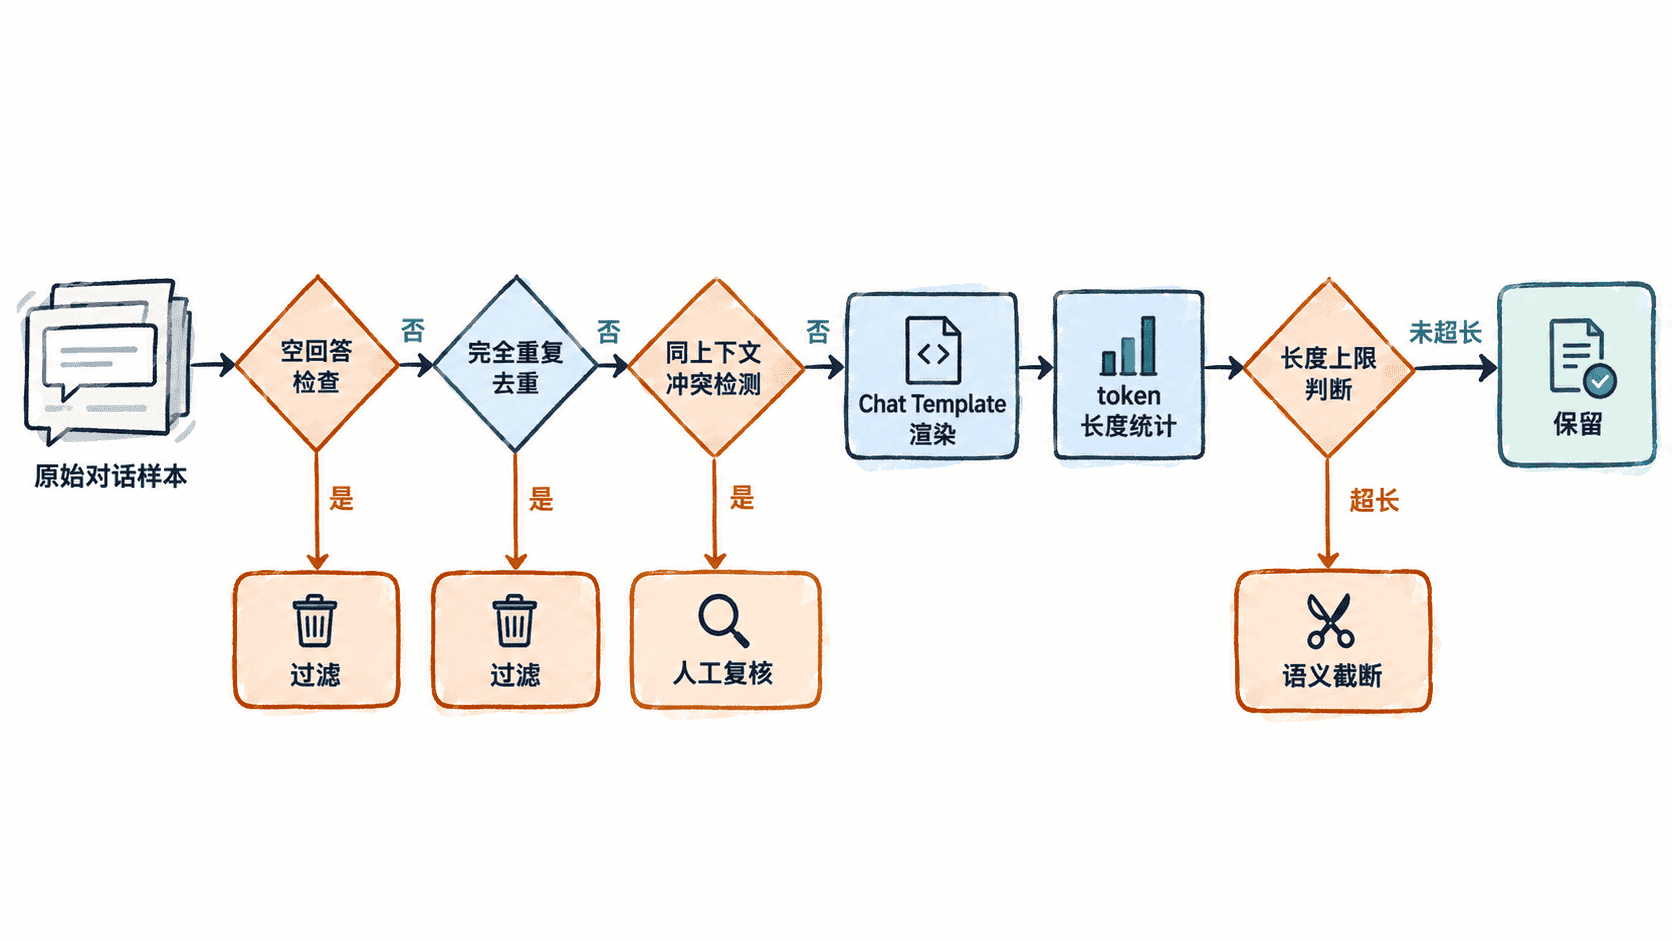
下面的最小脚本演示一条保守策略:空回答直接丢弃,完全重复只留一份,同一上下文出现多个不同目标答案时整组剔除,最后过滤超过长度上限的极端样本。
import json
from collections import defaultdict
from transformers import AutoTokenizer

MODEL_ID = 'Qwen/Qwen2.5-0.5B-Instruct'
MAX_LENGTH = 128
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)

raw_samples = [
    {'messages': [
        {'role': 'user', 'content': '解释梯度累积。'},
        {'role': 'assistant', 'content': '梯度累积通过多次反向传播后再更新参数,模拟更大的批次。'},
    ]},
    {'messages': [
        {'role': 'user', 'content': '解释梯度累积。'},
        {'role': 'assistant', 'content': '梯度累积通过多次反向传播后再更新参数,模拟更大的批次。'},
    ]},
    {'messages': [
        {'role': 'user', 'content': '天空通常是什么颜色?'},
        {'role': 'assistant', 'content': '蓝色。'},
    ]},
    {'messages': [
        {'role': 'user', 'content': '天空通常是什么颜色?'},
        {'role': 'assistant', 'content': '绿色。'},
    ]},
    {'messages': [
        {'role': 'user', 'content': '只回答一句话。'},
        {'role': 'assistant', 'content': '   '},
    ]},
    {'messages': [
        {'role': 'user', 'content': '生成一份很长的示例日志。'},
        {'role': 'assistant', 'content': '日志内容。' * 300},
    ]},
    {'messages': [
        {'role': 'user', 'content': '什么是 LoRA?'},
        {'role': 'assistant', 'content': 'LoRA 用低秩增量矩阵降低微调时需要训练的参数量。'},
    ]},
]

def stable_json(value):
    return json.dumps(value, ensure_ascii=False, sort_keys=True)

def split_target(sample):
    messages = sample['messages']
    if not messages or messages[-1]['role'] != 'assistant':
        return None
    answer = messages[-1]['content'].strip()
    if not answer:
        return None
    return messages[:-1], answer

deduplicated = []
seen = set()
for sample in raw_samples:
    target = split_target(sample)
    if target is None:
        continue

    fingerprint = stable_json(sample['messages'])
    if fingerprint in seen:
        continue

    seen.add(fingerprint)
    deduplicated.append(sample)

answers_by_context = defaultdict(set)
for sample in deduplicated:
    context, answer = split_target(sample)
    answers_by_context[stable_json(context)].add(answer)

conflicting_contexts = {
    key for key, answers in answers_by_context.items()
    if len(answers) > 1
}
cleaned = [
    sample for sample in deduplicated
    if stable_json(split_target(sample)[0]) not in conflicting_contexts
]

lengths = [
    len(tokenizer.apply_chat_template(
        sample['messages'],
        tokenize=True,
        add_generation_prompt=False,
    ))
    for sample in cleaned
]

def percentile(values, q):
    ordered = sorted(values)
    index = round((len(ordered) - 1) * q)
    return ordered[index]

kept = [
    sample for sample, length in zip(cleaned, lengths)
    if length <= MAX_LENGTH
]

print('raw_samples=', len(raw_samples))
print('after_empty_and_dedup=', len(deduplicated))
print('conflicting_context_groups=', len(conflicting_contexts))
print('after_conflict_filter=', len(cleaned))
print('p50_tokens=', percentile(lengths, 0.50))
print('p90_tokens=', percentile(lengths, 0.90))
print('max_tokens=', max(lengths))
print('kept_under_128=', len(kept))
预期输出
raw_samples= 7
after_empty_and_dedup= 5
conflicting_context_groups= 1
after_conflict_filter= 3
p50_tokens= <TOKENS>
p90_tokens= <TOKENS>
max_tokens= <TOKENS>
kept_under_128= 2
token 统计值取决于 tokenizer 版本,但样本数量变化应与输出一致。真实数据集应把每个清洗阶段的计数写入日志,避免数据突然少了一半却无法定位是哪条规则造成的。
用 token 分布决定长度上限
长度统计必须在 Chat Template 渲染后执行,而不是按字符数或原始消息长度估算,因为角色标记、特殊 token 和不同语言的分词都会改变实际序列长度。重点观察 P50、P90、P95、P99 和最大值,再结合显存与吞吐预算选择上限。
如果绝大多数样本集中在 2K token 内,只有极少数达到 20K,直接把全局 max_length 设到 20K 通常不划算:更长的序列会增加激活占用和单步计算量。更合理的做法是先检查长尾是否真的包含高价值任务信息,再决定保留、拆分或过滤。
选择过滤还是截断
| 策略 | 适合情况 | 主要风险 |
|---|---|---|
| 过滤 | 超长样本占比低,且不是关键任务 | 丢失少量长上下文能力 |
| 语义截断 | 多轮历史过长,但最新问题与答案必须保留 | 需要重新渲染并检查角色边界 |
| 直接截 token | 仅用于已确认可安全裁剪的特殊数据 | 可能切断 assistant 答案或结束标记 |
对对话数据,优先在结构化 messages 层做语义截断,例如删除最早的若干轮历史或压缩冗余上下文,然后重新执行 Chat Template。不要先渲染成 token IDs 再从尾部硬切,因为这样很容易把目标答案、assistant 结束标记或关键指令截掉。
验收清洗结果
清洗结束后至少保留四类指标:原始样本数、各规则删除数、token 长度分位数、最终保留率。再从被删除和被保留两侧各随机抽样检查,确认重复确实重复、冲突规则没有误伤合法多答案任务、长样本处理没有切掉监督目标。
最终的数据处理脚本应可重复执行:同一份原始数据、同一 tokenizer、同一组规则,应得到相同样本集合与长度统计。这样在 LoRA、QLoRA 或全参数训练之间切换时,模型差异才不会被数据版本漂移掩盖。