
大模型原理与训练 / 系统课时
估算参数量与显存开销
估算参数量与显存开销
训练前最容易踩的坑不是代码报错,而是参数规模和显存预算根本不匹配。本节把显存拆成可计算的几部分,用同一套方法比较全参数微调、LoRA 与 QLoRA,并在启动任务前判断单卡是否还有足够余量。
学习目标
- 拆解权重、梯度、优化器状态、激活值和运行时预留的显存来源
- 根据参数量和训练方式估算全参数微调、LoRA 与 QLoRA 的静态显存
- 从显存预算反推批大小、序列长度、梯度检查点和量化方案
显存预算先拆成五类
训练显存不能只看模型权重。一个实用的开跑前预算可以写成:
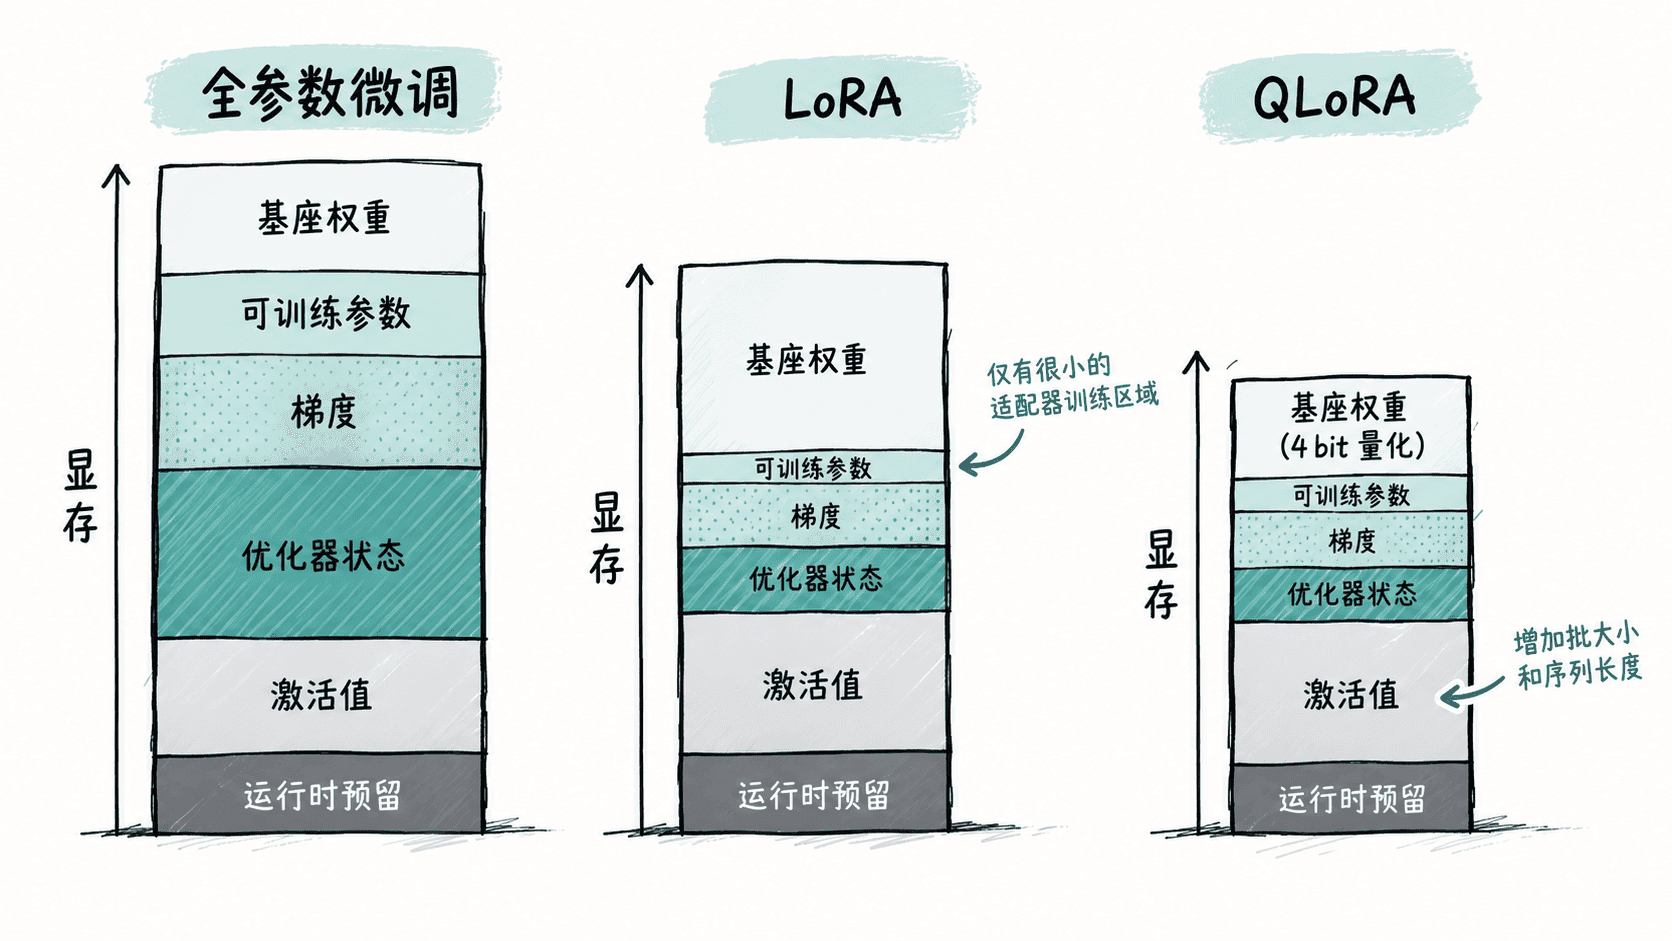
其中,权重是模型本身占用的存储;梯度只属于需要训练的参数;优化器状态通常还要为每个可训练参数保存额外张量;激活值来自前向传播并为反向传播保留;运行时预留则覆盖临时张量、CUDA 工作区、通信缓冲和内存碎片等无法仅靠参数量推导的空间。
| 组成 | 全参数微调 | LoRA | QLoRA |
|---|---|---|---|
| 基座权重 | 全部常驻,BF16/FP16 常按 2 字节/参数起算 | 全部常驻但冻结 | 基座通常以 4 bit 量化形式常驻 |
| 梯度 | 全部可训练参数 | 仅适配器参数 | 仅适配器参数 |
| 优化器状态 | 覆盖全部可训练参数 | 仅覆盖适配器 | 仅覆盖适配器 |
| 激活值 | 仍需单独预算 | 仍需单独预算 | 仍需单独预算 |
| 运行时空间 | 必须预留 | 必须预留 | 必须预留 |
先算静态参数账
以 BF16 或 FP16 全参数训练为基线,模型权重约为 2 字节/参数,梯度约为 2 字节/参数。若 Adam 的一阶、二阶状态都使用 FP32,则两份状态合计约为 8 字节/参数。因此在不额外保存 FP32 主权重时,静态部分可以先按约 12 字节/参数估算;某些训练实现还会保留额外的 FP32 主权重,此时可能接近 16 字节/参数。
例如 70 亿参数模型仅按 12 字节/参数计算,就约为 78.2 GiB,还没有计入激活值和运行时空间。这也是为什么同样的模型,全参数训练和参数高效微调的单卡门槛会相差很大。
LoRA 的关键变化是基座权重虽然仍要驻留显存,但不再为全部基座参数保存梯度和优化器状态。设基座参数量为 ,LoRA 可训练参数量为 ,静态训练状态主要从与 成正比变成与远小于 的 成正比。
QLoRA 再进一步把冻结的基座权重量化到低比特。4 bit 权重的理论原始存储约为 0.5 字节/参数,但真实占用还包括量化分组、缩放因子和框架元数据,因此不能直接把 0.5 字节乘参数量当成最终显存峰值。
激活值决定能跑多长的序列
参数账只解决了静态部分。真正启动训练后,激活值会随微批大小、序列长度、隐藏维度和网络层数增长。即使 QLoRA 已把基座权重压得很小,长序列或过大的微批仍可能让激活值成为最大显存项。
梯度检查点可以少保存一部分中间激活,在反向传播时重新计算它们,以更多计算量换取更低显存。另一个常见误区是把推理阶段的 KV Cache 直接加入训练预算:常规因果语言模型训练通常会关闭推理缓存,真正需要预留的是训练框架产生的临时张量、算子工作区、通信缓冲和分配器碎片;如果训练流程中还包含生成式评估,则应另外预算评估阶段的缓存峰值。
用脚本做开跑前估算
下面用一个 70 亿参数基座、约 2000 万可训练适配器参数的 QLoRA 场景做粗估。示例把 4 bit 基座权重额外增加 10% 作为量化元数据近似值,并人为预留 6 GiB 激活空间和 2 GiB 运行时空间。
PARAMS = 7_000_000_000
TRAINABLE = 20_000_000
GIB = 1024 ** 3

# 4 bit 原始权重按 0.5 字节/参数计算,再给量化元数据留 10%。
base_quantized = PARAMS * (4 / 8) * 1.10
adapter_weights = TRAINABLE * 2
adapter_gradients = TRAINABLE * 2
adam_states = TRAINABLE * 8

# 激活值和运行时空间不能仅靠参数量精确推出,先按目标配置预留。
activations = 6 * GIB
runtime_reserve = 2 * GIB

parts = {
    "base_quantized": base_quantized,
    "adapter_weights": adapter_weights,
    "adapter_gradients": adapter_gradients,
    "adam_states": adam_states,
    "activations": activations,
    "runtime_reserve": runtime_reserve,
}

for name, value in parts.items():
    print(f"{name}: {value / GIB:.2f} GiB")

print(f"estimated_total: {sum(parts.values()) / GIB:.2f} GiB")
预期输出
base_quantized: 3.59 GiB
adapter_weights: 0.04 GiB
adapter_gradients: 0.04 GiB
adam_states: 0.15 GiB
activations: 6.00 GiB
runtime_reserve: 2.00 GiB
estimated_total: 11.81 GiB
这里的 11.81 GiB 是规划值,不是某个框架保证的真实峰值。量化元数据比例、实际 LoRA 参数量和激活占用都应替换成当前模型与训练配置的数据。
从估算反推训练配置
如果静态参数状态本身已经超过单卡容量,降低批大小通常解决不了问题,应优先考虑 QLoRA、参数或优化器分片、CPU Offload 等方案。若静态部分可以装下而训练步骤才溢出,则更应该检查激活值。
调整时可以先降低 micro batch,并通过梯度累积维持需要的有效批大小;随后检查序列长度,因为更长的上下文通常会显著提高激活开销;仍然不足时再启用梯度检查点。如果显存已经接近上限,还应给评估、保存检查点和运行时波动留下余地。
最终判断标准不是“模型成功加载”,而是使用目标精度、目标序列长度和目标微批完整执行前向、反向和优化器更新后仍有稳定余量。只要把静态参数账和动态激活账分开计算,就能在真正开跑前判断该缩批、缩序列、量化基座,还是直接换用分片训练。