
大模型原理与训练 / 系统课时
选择 NF4 与双重量化
选择 NF4 与双重量化
QLoRA 的 4bit 配置不只有“开或关”。量化类型决定 16 个离散值如何表达基座权重,double quant 则继续压缩量化缩放常数。本篇聚焦 NF4、FP4 与双重量化的取舍,并给出一组可直接用于 BitsAndBytesConfig 的常见配置。
学习目标
- 解释 NF4 为什么适合近似正态分布的预训练权重。
- 说明 double quant 压缩的是量化常数,而不是再次压缩 LoRA 参数。
- 根据显存、数值误差与硬件计算类型选择一组合理的 4bit 配置。
NF4 的重点是更合适的 16 个表示值
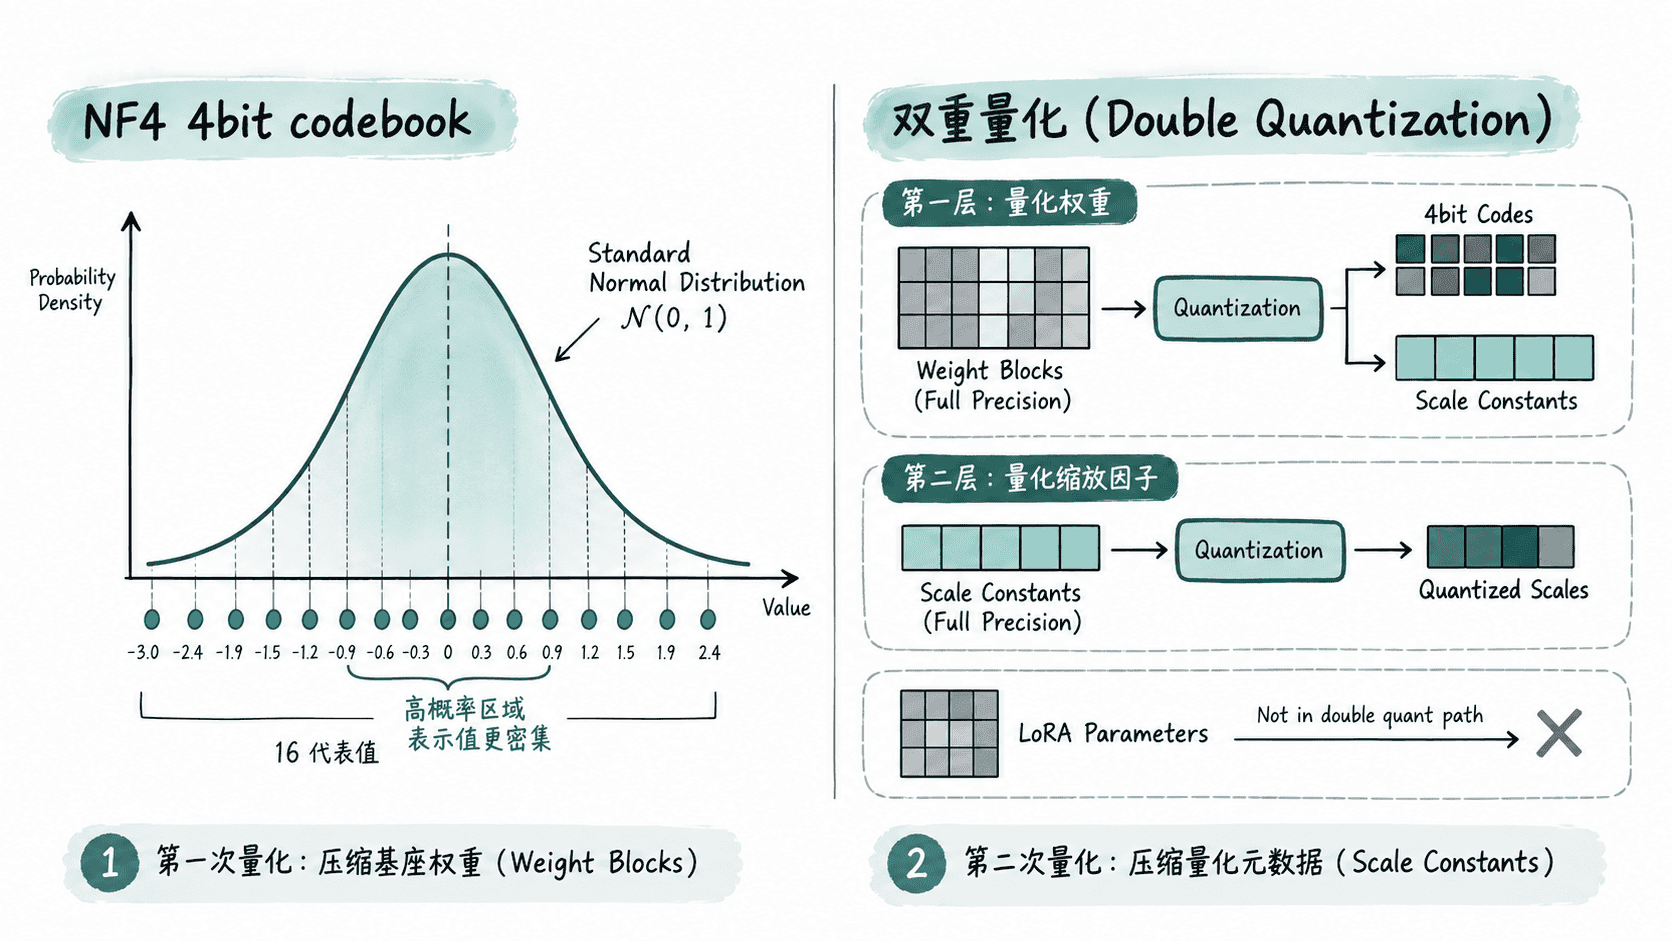
4bit 只能编码 16 种状态。NF4(NormalFloat 4)不是简单把数轴等距切成 16 份,而是针对近似零中心正态分布的数据设计表示值:标准化后,量化区间按正态分布的概率质量组织,再映射到有限的 4bit 码本。
这使有限的 16 个值能把更多表示能力放在权重更常出现的区域。对典型预训练模型权重而言,NF4 往往比通用 FP4 更适合作为 QLoRA 的训练量化类型;但它仍然是有损量化,具体误差会受模型、层分布与分块尺度影响。
双重量化压缩的是量化常数
第一次 4bit 量化通常按块保存两类信息:每个权重的 4bit 码值,以及帮助恢复该块数值范围的缩放常数。模型很大时,后者虽然远小于权重本体,也会积累成可观的元数据开销。
double quant,也常称 nested quantization,会继续量化这些缩放常数。基座权重仍然是 4bit 码值,LoRA 参数也不会因此变成 4bit;它只是把“描述如何反量化 4bit 权重”的元数据再压缩一层,因此额外显存收益通常小于从 16bit 降到 4bit 的第一次量化,但成本也相对温和。
配置一个常见的 QLoRA 组合
如果硬件支持 BF16,一个常见起点是 NF4 + double quant + BF16 计算。下面的示例只构造量化配置,不下载模型,因此适合先验证本地 transformers 是否识别这些选项。
import torch
from transformers import BitsAndBytesConfig

quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)

print(quant_config.bnb_4bit_quant_type)
print(quant_config.bnb_4bit_use_double_quant)
print(quant_config.bnb_4bit_compute_dtype)
预期输出
nf4
True
torch.bfloat16
真正加载模型时,还需要把 quant_config 作为 quantization_config 传给模型加载接口。若 GPU 不支持 BF16,应根据硬件改用 FP16 或其他受支持计算类型;量化存储类型与计算类型是两个独立维度,不要因为权重是 4bit 就假设矩阵乘法也只能是 4bit。
NF4、FP4 和 double quant 怎么取舍
| 方案 | 权重存储 | 额外显存收益 | 数值与速度判断 |
|---|---|---|---|
| FP4 | 4bit | 相对 16bit 已大幅下降 | 可作为兼容或对照方案;误差表现依模型与实现而定 |
| NF4 | 4bit | 与 FP4 位宽相同 | 更贴合近似正态的预训练权重,通常是 QLoRA 微调的优先起点 |
| NF4 + double quant | 4bit,缩放常数再量化 | 在 NF4 基础上继续减少量化元数据 | 通常只增加较小的元数据处理开销,但实际速度仍由内核、GPU 和 batch 等共同决定 |
这里最容易误判的是“位宽相同就等价”。NF4 与 FP4 都是 4bit,但码本设计不同,因此不能只用显存判断好坏;double quant 也不是另一种权重码本,而是与 NF4/FP4 正交的元数据压缩开关。
选择时先检查三个边界
首先确认训练目标是 LoRA/QLoRA,而不是要更新全部基座参数。4bit 基座通常作为冻结权重使用,不能把它直接理解成“4bit 全参数训练”。
其次分开设置 bnb_4bit_quant_type 与 bnb_4bit_compute_dtype。前者控制基座权重如何编码,后者控制反量化后的主要计算精度。BF16 常在支持它的 GPU 上兼顾范围与速度,但硬件支持必须先确认。
最后再决定是否开启 bnb_4bit_use_double_quant。当显存边界很紧时,它往往值得开启;若正在定位量化误差、内核兼容性或性能问题,可以先关闭它建立基线,再单独打开比较。这样能把“码本选择”“计算精度”和“量化元数据压缩”三个变量分别验证,而不是一次改变所有条件。